Gradium lança Phonon, modelo de voz que roda direto no aparelho
Gradium, spin-off da Kyutai em Paris, lança Phonon, modelo TTS de 31M parâmetros open-source que gera voz natural direto em celulares, PCs, placas e navegadores, sem nuvem.
Tecnologia
Phonon permite síntese de voz natural em dispositivos locais, eliminando a necessidade de conexão com a nuvem.
Leia também: Spotify AI DJ cresce e domina playlists em agentes de IA hoje
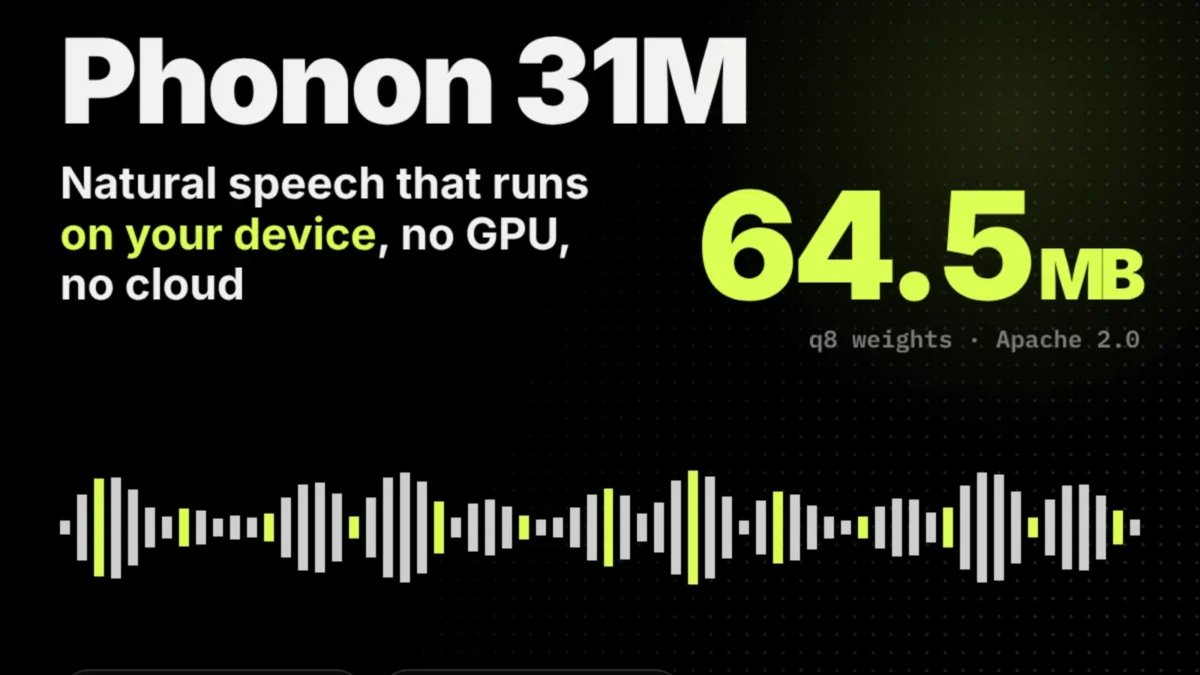
A francesa Gradium, spin-off da Kyutai focada em inteligência artificial vocal, lançou o Phonon, uma família de modelos de texto para fala (TTS) feitos para rodar direto no dispositivo. O destaque é a versão de 31 milhões de parâmetros, open-source sob licença Apache 2.0, capaz de gerar voz natural localmente em celulares, laptops, placas embarcadas e navegadores, sem depender de nuvem, GPU dedicada ou cobrança por caractere.
Modelo compacto, aberto e pensado para rodar em qualquer lugar
O Phonon chega em dois tamanhos: 31 milhões e 40 milhões de parâmetros. O menor ocupa 64,5 MB e é o que foi liberado com código aberto, permitindo que desenvolvedores adaptem o modelo para seus próprios produtos, de assistentes virtuais a ferramentas de acessibilidade. A proposta da Gradium é reduzir custos de operação e aumentar a privacidade, já que o texto a ser convertido em fala não precisa sair do aparelho.
Por baixo do capô, o Phonon usa um backbone transformer causal que recebe, em um único prefixo, tanto o texto quanto embeddings de locutor — vetores que codificam características de voz. A entrada de texto é tratada por um tokenizador SentencePiece com vocabulário de 4.000 tokens, sem conversão para fonemas, o que simplifica o pipeline e permite lidar diretamente com texto cru.
A arquitetura gera um vetor latente a cada 80 milissegundos de áudio. Um módulo de fluxo de correspondência transforma esse vetor em um embedding de áudio em um único passo. Na sequência, uma versão reduzida do decodificador Mimi, da Kyutai, converte esse embedding em áudio PCM a 24 kHz. Um cabeçote separado detecta automaticamente o fim da fala e decide quando encerrar a geração.
No Phonon 31m, o backbone tem 6 camadas transformer, largura 512 e 8 cabeças de atenção. Já o Phonon 40m mantém a mesma largura, mas com 9 camadas. Ambos foram destilados de um modelo professor maior e treinados em cluster NVIDIA H100, com uso de NCCL e CUDA Graphs para acelerar a distribuição e o agendamento dos treinamentos.
Desempenho: da CPU do notebook ao Raspberry Pi
Em testes de desempenho divulgados pela Gradium, o Phonon 31m mostra que a proposta on-device é viável mesmo em máquinas modestas. “On a MacBook Air M5 CPU with 4 threads, Phonon 31m reaches first audio in 6.9 ms”, registra a documentação técnica, com o modelo rodando 29,9 vezes mais rápido que o tempo real. O concorrente Kokoro, que não é streaming, leva 517 milissegundos para começar a falar.
Em um Raspberry Pi 5, placas muito usadas em projetos embarcados e IoT, o Phonon inicia o áudio em 38 milissegundos e roda 3,7 vezes mais rápido que o tempo real. A Gradium relata que o Kokoro precisa de cerca de 7 segundos para iniciar na mesma placa, o que na prática inviabiliza respostas em tempo real em muitos cenários.
Nos testes em chip móvel Snapdragon 8 Elite Gen 5, o modelo começa a falar em 7,5 milissegundos, a 24 vezes o tempo real. Em GPU NVIDIA L40S com CUDA, o primeiro trecho de fala aparece em 5 milissegundos, e um processador AMD EPYC 7413 entrega início de áudio em 43 milissegundos, indicando que mesmo servidores sem GPU podem atender aplicações de TTS em larga escala com baixa latência.
Qualidade de voz: Phonon supera Kokoro e NeuTTS em testes cegos
Para medir a qualidade da voz, a Gradium conduziu testes cegos de audição em pares, com 1.189 avaliadores e 17.270 votos, comparando o Phonon com concorrentes estabelecidos. Em inglês dos Estados Unidos, “Phonon 40m scored 2117 Elo and Phonon 31m scored 2098.” Nesse mesmo ranking, Kokoro aparece com 2043 pontos Elo, NeuTTS com 2034 e Magpie com 1939.
Os pesquisadores também mediram a acurácia na leitura de frases difíceis, repletas de números de telefone, e-mails e códigos postais, em um conjunto público de 500 sentenças por idioma. “Phonon 31m scored 1,70% WER against 3,50% for Kokoro and 8,71% for NeuTTS Nano”, afirma o relatório, referindo-se à taxa de erro de palavras (WER, na sigla em inglês). Segundo a Gradium, a normalização de texto embutida no modelo — que trata abreviações, números e formatos específicos antes da síntese — explica boa parte dessa vantagem.
Em conjuntos mais fáceis, como o Seed-TTS, a diferença se estreita. O Phonon 31m ficou com 0,51% de WER, enquanto o Kokoro atingiu 0,45%, praticamente empatados na capacidade de ler frases mais simples sem erros.
Entenda o contexto
O lançamento do Phonon ocorre em um momento em que a maior parte dos serviços comerciais de síntese de voz ainda depende de chamadas a servidores remotos. Esse modelo de negócio facilita o controle de custo e atualização, mas cria problemas de privacidade — todo texto precisa ser enviado à nuvem — e de imprevisibilidade de gastos, com cobrança por caractere ou minuto de áudio.
Ao apostar em um modelo compacto e aberto, a Gradium busca empurrar o mercado na direção de soluções locais, que rodam direto no chip do usuário. Para desenvolvedores, isso significa menor dependência de provedores externos; para empresas, uma conta de infraestrutura potencialmente mais baixa; para usuários finais, menos preocupação com quem tem acesso aos seus dados de voz e texto.
Ecossistema, licenças e impacto para desenvolvedores
Além dos pesos do modelo em si, a Gradium liberou um runtime multiplataforma, licenciado sob MIT ou Apache-2.0, que funciona em Rust, Python (com instalação via pip install ptts), Swift, C, C++ e diretamente no navegador, por meio do pacote phonon-tts. Há ainda servidores compatíveis com a API de modelos de linguagem populares e com WebSocket, o que facilita plugar o Phonon em aplicativos já existentes.
De acordo com a documentação, “Phonon loads in Transformers, MLX-Audio, Ollama and LM Studio”, quatro dos ecossistemas mais usados atualmente para rodar modelos de IA localmente. A empresa também oferece o Gradium Studio, ferramenta em que é possível fazer clonagem e design de vozes para depois rodá-las de forma local com o Phonon.
Datasets, código-fonte e documentação técnica foram disponibilizados publicamente, numa tentativa clara de criar comunidade em torno do projeto. A abertura sob licença Apache 2.0 permite uso comercial, modificação e redistribuição, desde que mantidos avisos de copyright e licença.
Na prática, a chegada do Phonon pressiona serviços de TTS baseados exclusivamente em nuvem, que podem ver parte da demanda migrar para soluções locais e gratuitas. A resposta da concorrência deve vir na forma de modelos on-device mais eficientes, ofertas híbridas e novas discussões sobre padrões de privacidade e segurança para tecnologias de voz, em um cenário em que a síntese de fala deixa de ser privilégio de grandes datacenters e passa a caber no bolso do usuário.
Fonte: matéria original