Liquid RIPL leva modelos generativos a latência abaixo de 50 ms
Liquid AI lança o motor de inferência Liquid RIPL, que entrega respostas completas em menos de 50 ms e permite trocar árvores de decisão por modelos generativos em aplicações críticas sem estourar o orçamento de latência.
Inteligência Artificial
Novo motor de inferência da Liquid AI reduz drasticamente o tempo de resposta para aplicações críticas.
Leia também: NVIDIA OpenShell instala runtime seguro para IA com sandbox
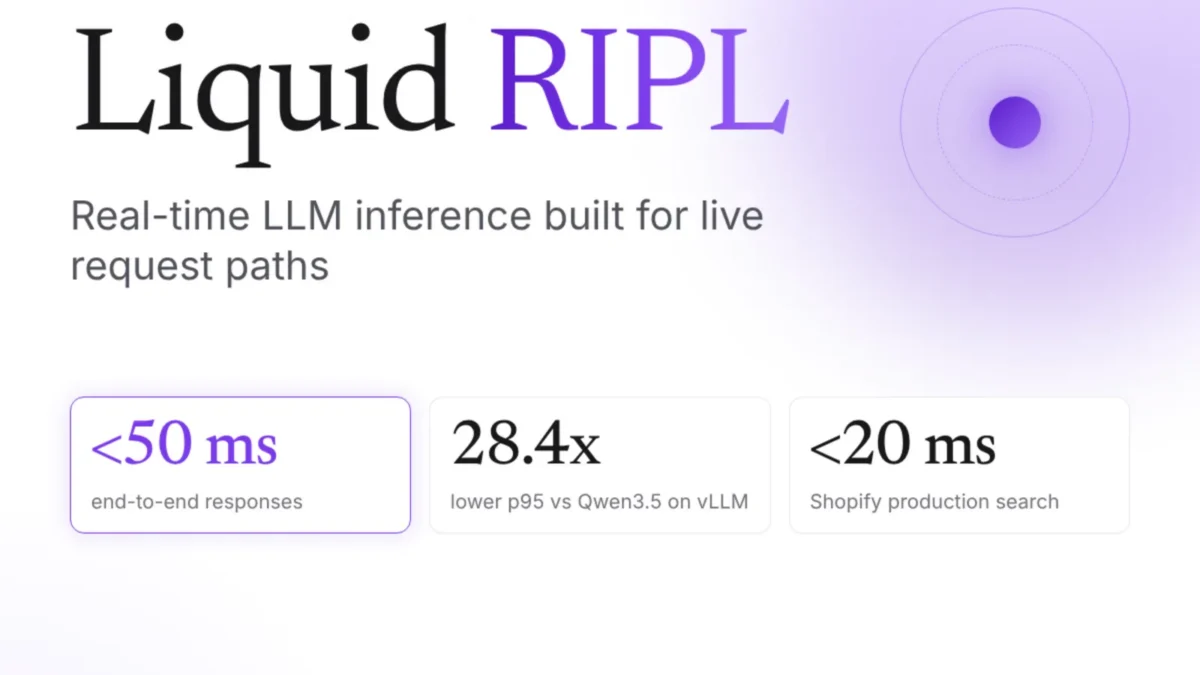
A Liquid AI lançou o Liquid RIPL, um motor de inferência em tempo real que promete executar modelos generativos de grande porte com latência abaixo de 50 milissegundos de ponta a ponta, abrindo caminho para substituir modelos clássicos por modelos fundacionais híbridos (LFMs) em aplicações críticas sem estourar o orçamento de latência.
Motor mira ranking, fraude e pagamentos em tempo real
O RIPL (Real-time Inference Pipeline) foi projetado para servir os Liquid Foundation Models diretamente no caminho de requisições ao vivo, do momento em que o pedido chega até a resposta final gerada. Segundo a empresa, o sistema mantém a latência sub-50 ms mesmo quando o tráfego chega de forma contínua em carga máxima, algo essencial para tarefas como ranking de busca, checagem de fraudes e autorização de pagamentos, que não toleram esperas de segundos.
A mensagem da Liquid AI para desenvolvedores é direta: “Swap gradient-boosted trees for a generative model, and keep the latency budget”, ou seja, trocar árvores de decisão por um modelo generativo sem abrir mão do limite de tempo já praticado em produção.
Hoje, muitas equipes recorrem a modelos clássicos nesses fluxos justamente porque a inferência de grandes modelos de linguagem costuma ser lenta demais. O RIPL tenta resolver essa limitação otimizando não só o modelo, mas todo o pipeline de inferência, da chegada da requisição ao envio da resposta.
Como o RIPL se compara a outros motores
Nos testes divulgados, a Liquid AI rodou o mesmo modelo LFM2.5-350M tanto no RIPL quanto em vLLM, um dos motores de inferência mais usados no ecossistema de IA generativa. Em diferentes cargas de trabalho, a empresa afirma que “RIPL’s p95 line sits well below the vLLM line in each case”, indicando que a latência p95 (o tempo abaixo do qual ficam 95% das requisições) é consistentemente menor no novo motor.
Os experimentos consideram chegadas de requisições em regime aberto (Poisson open-loop) sobre um hardware B200, com os LFMs rodando em RIPL e baselines como MiniCPM5 e Granite 4.2 executando em vLLM. A Liquid AI argumenta que isso isola parte do ganho no próprio motor, e não apenas na arquitetura dos modelos.
Os LFMs usados são híbridos, misturando blocos convolucionais e GQA (Grouped Query Attention). Entre os modelos destacados estão o LFM2.5-1.2B-Instruct, com 16 camadas, e o LFM2.5-2.6B, com 30 camadas. A combinação busca equilibrar capacidade de representação com eficiência e baixa latência.
Shopify já roda LFMs com menos de 20 ms
Um dos principais casos de uso apresentados é o da Shopify, que opera em um ambiente de comércio eletrônico especialmente sensível a atrasos. De acordo com a Liquid AI, “Shopify is deploying LFMs across latency-sensitive commerce workloads” e consegue rodar inferências em tráfego real de produção com latência abaixo de 20 ms.
Os ganhos não ficam só no tempo de resposta. Ainda segundo a empresa, esses LFMs “use about 50% fewer parameters than alternatives and deliver 2 to 10x faster inference”, ou seja, usam cerca de metade dos parâmetros de alternativas comparáveis e entregam inferência de 2 a 10 vezes mais rápida. Na prática, isso se converte em menor custo computacional, maior throughput e possibilidade de melhorar a qualidade das respostas com modelos generativos mais sofisticados, sem sacrificar desempenho.
Entenda o contexto
Motores de inferência para modelos generativos costumam priorizar grandes lotes de requisições e tarefas longas, como agentes que fazem múltiplas chamadas em sequência. Nesses cenários, alguns segundos por resposta ainda são aceitáveis. Em fluxos de missão crítica, porém, como detecção de fraude em transações, ranqueamento em tempo real de resultados de busca ou autorização de pagamentos, o intervalo disponível é de milissegundos.
Esse descompasso levou empresas a manterem árvores de decisão, regressões e outros modelos clássicos nesses caminhos, usando LLMs apenas em tarefas menos sensíveis à latência. O RIPL tenta quebrar essa barreira ao mostrar que modelos generativos fundacionais podem operar dentro de orçamentos rígidos de tempo, inclusive com carga contínua e volumosa.
A Liquid AI também mapeou seis cargas de trabalho em tempo real contra orçamentos fixos de latência, oferecendo ainda uma calculadora de latência e cards técnicos dos modelos LFM2.5 para ajudar desenvolvedores a estimar desempenho e dimensionar suas próprias aplicações.
Impacto no mercado e próximos passos
O lançamento do RIPL repercute entre empresas que lidam diariamente com limites de latência rígidos, como grandes varejistas online, fintechs e provedores de serviços digitais. A adoção em produção pela Shopify funciona como um selo de validação, mostrando que a tecnologia não está restrita a laboratório.
Para fornecedores de soluções tradicionais de inferência, o movimento acende um alerta: se a otimização de todo o pipeline — e não apenas do modelo — virar padrão, motores que não acompanhem essa evolução podem perder espaço. A tendência é de competição mais acirrada com soluções como vLLM, MiniCPM5 e Granite 4.2, empurrando o segmento a buscar latências cada vez menores.
Do lado da comunidade técnica, o tema ganha tração em espaços especializados, impulsionado pela divulgação feita por Asif Razzaq, CEO da Marktechpost AI Media Inc., plataforma de notícias de IA que registra mais de 2 milhões de visualizações mensais e reúne uma comunidade superior a 150 mil membros em fóruns de machine learning. A Liquid AI, por sua vez, deve seguir ampliando o ecossistema em torno dos LFMs e do RIPL, com foco em ferramentas, suporte e casos de uso em produção para consolidar o motor como referência em inferência em tempo real.
Fonte: matéria original