Cerebras roda modelo GPT 4 de 3 tri parâmetros em 59 chips
Cerebras detalha técnica para rodar o modelo open source Kimi K3, de 3 trilhões de parâmetros, em 59 wafers WSE-3T, e desafia limite de GPUs em IA gigante.
Inteligência Artificial
Cerebras utiliza avançada tecnologia para executar modelo GPT 4 de 3 trilhões de parâmetros com eficiência inédita.
Leia também: Projeto pgrust expõe bugs no Postgres e reacende ambição no software
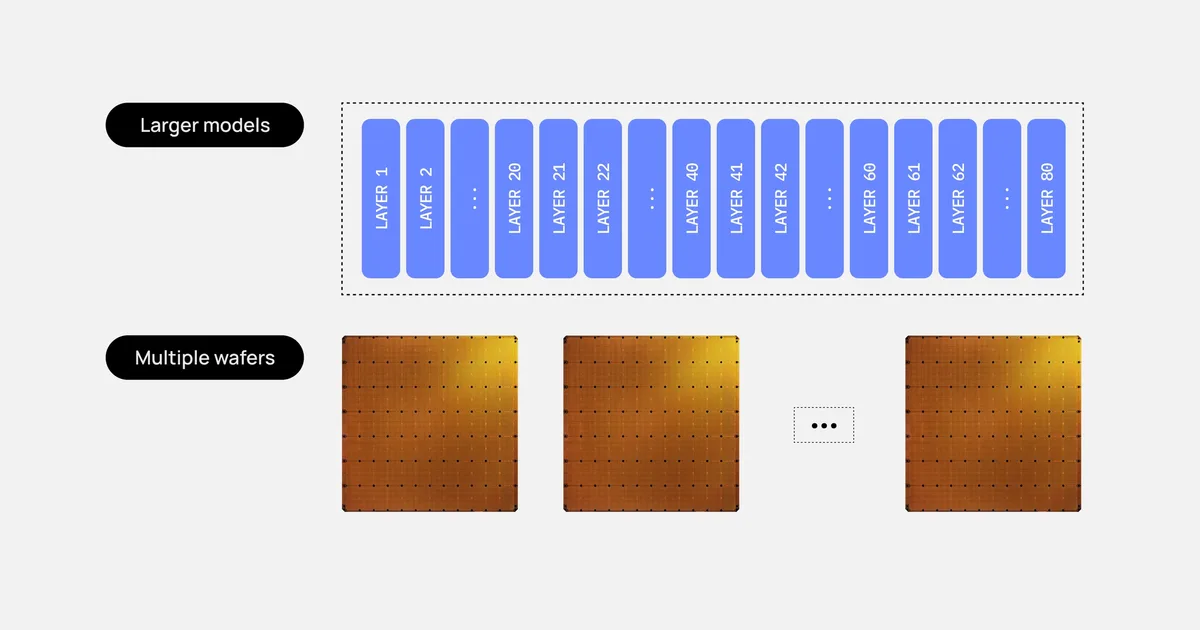
A Cerebras detalhou como consegue rodar modelos de IA com trilhões de parâmetros, como o open source Kimi K3, distribuindo as 93 camadas da rede por 59 wafers WSE-3T interconectados, cada um com 44 GB de memória on-chip, e mantendo desempenho comparável a sistemas proprietários como o GPT-5.6 Sol.
Como a Cerebras está implantando modelos de IA com um trilhão de parâmetros?
A empresa distribui o modelo por dezenas de wafers WSE-3T, trata cada wafer como um estágio de pipeline e só movimenta ativações entre chips, sem tirar os pesos da memória on-chip. Assim, consegue rodar modelos multi-trilhão a algo entre 1000 e 2000 tokens por segundo.
O exemplo usado é o Kimi K3, descrito pela equipe como “Kimi K3 é um modelo open source de 3 trilhões de parâmetros com 69 camadas de atenção linear e 24 camadas densas.” Ao todo, são 93 camadas. Com pesos armazenados em 4 bits, cada camada consome cerca de 16 GB.
Como cada wafer WSE-3T oferece 44 GB de SRAM on-chip, cabem múltiplas camadas em um único chip. No mapeamento apresentado, o Kimi K3 ocupa 59 wafers. Cada wafer armazena localmente os pesos das suas camadas e processa as ativações recebidas do wafer anterior, enviando o resultado ao próximo.
A comunicação entre wafers acontece via RDMA sobre Ethernet, com o time destacando que “a latência para passagem de ativações entre wafers via RDMA sobre Ethernet é de cerca de 2 microssegundos por salto.” Como só as ativações viajam, e não os pesos, o tráfego é menor e a latência se mantém baixa mesmo com dezenas de saltos.
Para evitar que os wafers fiquem ociosos, o sistema mantém o pipeline sempre cheio: diferentes etapas processam tokens de requisições distintas ao mesmo tempo, e cada estágio ainda pode operar em micro-batches. Dessa forma, a plataforma equilibra baixa latência para cada chamada individual com alto throughput agregado.
A memória que sobra em cada wafer depois de acomodar a camada densa vira cache de chaves-valor (KV cache). É esse espaço que limita o número máximo de requisições simultâneas que podem atravessar o pipeline em paralelo.
Entenda o contexto
Modelos de fronteira com trilhões de parâmetros precisam de terabytes de memória só para guardar pesos, algo que extrapola com folga o que cabe em uma única GPU tradicional. A estratégia padrão no ecossistema de Gpt 4 e sucessores combina sharding de pesos entre várias GPUs e uso intenso de memória externa, o que aumenta a complexidade de engenharia e a latência.
A aposta da Cerebras é quase o oposto: em vez de empilhar GPUs menores, usar wafers gigantes com muita memória on-chip, a ponto de manter camadas inteiras dentro de um único chip, reduzindo acessos à memória externa e o custo de sincronização. Cada novo wafer acrescenta memória e computação de forma linear, permitindo escalar para modelos cada vez maiores seguindo o mesmo desenho de pipeline.
Como o avanço da Cerebras impacta o desenvolvimento de IA em comparação com o GPT-4?
O impacto principal está em abrir caminho para modelos open source gigantes com desempenho de ponta, fora do ciclo fechado de grandes provedores que hoje dominam o mercado com modelos na linha do GPT-4.
No caso do Kimi K3, os autores afirmam que “o modelo alcança 88,3% no Terminal-Bench 2.1, contra 88,8% do GPT-5.6 Sol, e 91,2% no BrowseComp, superando o GPT-5.6 Sol que tem 90,4%.” Em outras palavras, um modelo aberto, rodando em hardware especializado, aparece tecnicamente na mesma liga — e até acima — de um sistema proprietário em benchmarks de programação e navegação.
Na prática, isso pressiona fabricantes focados apenas em GPUs a acelerar inovações em memória e interconexão, e oferece aos laboratórios de pesquisa e startups a chance de trabalhar com modelos ultra grandes sem ficarem presos a APIs fechadas. Áreas como agentes autônomos, assistentes corporativos complexos, ferramentas avançadas de desenvolvimento de software e sistemas de pesquisa multimodal são as primeiras candidatas a se beneficiar dessa combinação de escala e abertura.
O método também serve de roteiro para próximos passos: repetir a mesma lógica de particionamento de camadas, mapeamento em wafers e pipeline para arquiteturas ainda maiores, ajustando apenas o número de wafers e a política de KV cache para manter a eficiência conforme os modelos crescem.