TokenGate acelera LLMs em até 11x cortando tokens irrelevantes
Pesquisadores de Stanford e UC Berkeley lançam o TokenGate, módulo que aprende a podar tokens irrelevantes em LLMs, acelerando o prefill em até 11,3x e reduzindo memória sem perda de precisão.
Tecnologia
Novo módulo otimiza o processamento de grandes modelos de linguagem, aumentando a velocidade e eficiência sem comprometer a precisão.
Leia também: Jack Clark prevê IA que se autoaperfeiçoa em 2027; veja impacto
Pesquisadores de Stanford e da Universidade da Califórnia em Berkeley apresentaram nesta semana o TokenGate, um módulo plug-and-play que aplica poda treinável de tokens para acelerar a fase de prefill em grandes modelos de linguagem, cortando custo e tempo de inferência em contextos longos sem perda de precisão.
TokenGate “ensina” o modelo a folhear o texto
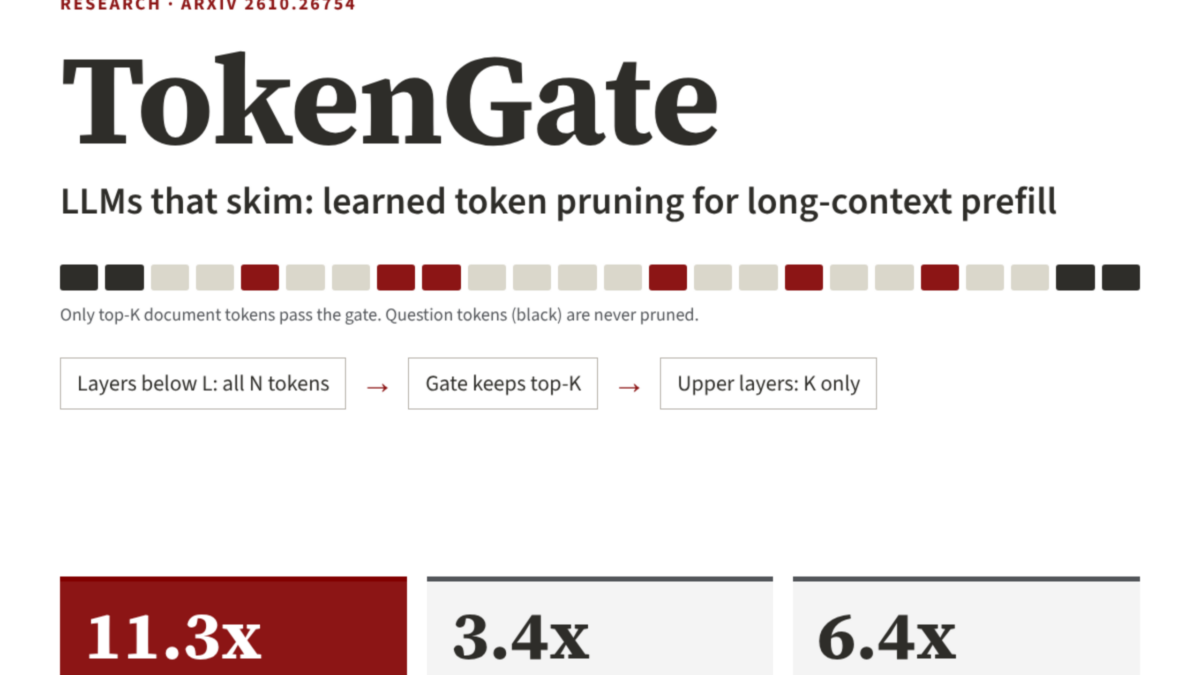
Na prática, o TokenGate permite que um LLM aprenda a “folhear” o próprio input, descartando cedo os trechos menos relevantes antes de processar tudo em todas as camadas do transformador. “TokenGate learned token pruning lets an existing LLM skim its input. Only the tokens that matter get full processing”, resumem os autores.
O módulo atua apenas sobre a parte de documento do prompt — a pergunta do usuário nunca é podada — e é inserido como um componente extra no modelo já pré-treinado. Ele calcula uma pontuação para cada token e decide, via seleção top-K, quais seguem adiante para processamento completo nas camadas seguintes.
O desafio técnico é que a seleção top-K, por natureza discreta, não é diferenciável, o que impediria o treinamento fim a fim. Para contornar isso, o TokenGate “empresta” uma ideia de roteadores de Mixture-of-Experts: “Top-K selection is not differentiable, which blocks end-to-end training. TokenGate borrows the Mixture-of-Experts router trick.” As pontuações dos tokens mantidos viram um viés nos logits de atenção acima do gate, abrindo caminho para o fluxo de gradientes até o seletor.
Esse viés é refinado com dois conjuntos de parâmetros aprendíveis: um ganho por cabeça de atenção e uma temperatura ajustável, que compensa o fato de cada consulta (query) passar a enxergar menos chaves (keys) após a poda.
Como o treinamento funciona
O treinamento do TokenGate segue o esquema padrão de modelos de linguagem, baseado em prever o próximo token, mas com um truque de orçamento variável. “Training uses plain next-token loss. Each step averages a full-context loss and a random-budget loss. So 1 trained gate works across budgets”, explicam os pesquisadores.
Na prática, a cada passo de treinamento o modelo é avaliado duas vezes: uma com o contexto completo e outra com um orçamento aleatório de tokens, o que ensina o gate a operar bem em diferentes níveis de poda. Assim, o mesmo módulo pode ser reutilizado depois com orçamentos mais agressivos ou conservadores, conforme a aplicação exigir.
Segundo a equipe, o procedimento “mirrors a TRL/PEFT recipe. Each step is 1.3x slower than plain LoRA. Runs converged faster on 4 of 5 tasks.” Em média, o treinamento do módulo levou 1,8 hora em GPU A100, contra 2,2 horas em um ajuste fino simples com LoRA no mesmo backbone, o que reduz o custo total apesar de cada passo ser um pouco mais caro.
Quais foram os ganhos de desempenho do TokenGate?
Nos experimentos reportados, o TokenGate acelerou de forma significativa o tempo até o primeiro token gerado, métrica conhecida como TTFT (time-to-first-token). “The research team reports 1.4x to 11.3x faster time-to-first-token (TTFT) with no accuracy loss”, afirma o trabalho.
Os testes usaram o modelo Qwen3-1.7B em tarefas variadas, como RepoBench-P, 2WikiMultihopQA, MultiNews, BioDEX e o benchmark de “agulha no palheiro” (NIAH), todas com contexto longo. O comparativo incluiu abordagens de poda e aceleração já conhecidas, como FastKV, SlimInfer, DASH, GemFilter, FlexPrefill e MInference, todas sobre o mesmo backbone ajustado com LoRA.
A redução de uso de memória seguiu a mesma linha. “Peak prefill memory drops 1.5x to 3.4x”, relatam os pesquisadores, o que alivia o gargalo de GPU na fase em que o modelo precisa carregar e processar todo o contexto de entrada.
Em configurações específicas, o TokenGate também superou a concorrência direta. “The learned selector beats FastKV’s heuristic at the same layer”, diz a equipe. Mesmo uma seleção aleatória de tokens (random-K), quando acoplada ao backbone já adaptado ao TokenGate, performou melhor do que a versão base com FastKV, efeito atribuído à coadaptação do modelo ao novo gate.
Resultados em modelos maiores
Os pesquisadores também aplicaram o método em um modelo mais robusto, o Qwen3.5-2B, que mistura camadas com arquiteturas de atenção diferentes. Em um cenário de contexto de 32 mil tokens no benchmark NIAH, o módulo manteve a acurácia do prefill completo em uma das camadas intermediárias. “TokenGate at layer 3 matched full-prefill accuracy. It ran 3.8x faster than full prefill and 2.1x faster than FastKV”, detalham.
Quando o gate foi movido para camadas ainda mais rasas, o ganho de velocidade aumentou, com pequeno custo em desempenho. “Gating at layers 1 or 2 reached 7.8x, within 6% accuracy”, registra o relatório. Na prática, isso abre espaço para que aplicações escolham entre máxima fidelidade ou máxima velocidade, dependendo da sensibilidade da tarefa à perda de alguns pontos percentuais de acurácia.
O que muda para desenvolvedores e empresas de IA?
Os números indicam impacto direto em custos e experiência de uso em aplicações que dependem de leitura de textos longos, como análise de contratos, pesquisa jurídica, atendimento ao cliente com base em bases documentais extensas e assistência a pesquisa acadêmica. Ao reduzir o tempo até o primeiro token em até 11,3 vezes e o pico de memória em até 3,4 vezes, o TokenGate torna mais viável rodar LLMs com contexto extenso em menos GPUs ou em hardwares mais modestos.
Isso se traduz em menor latência para o usuário final e maior densidade de sessões por servidor, dois fatores centrais em produtos comerciais baseados em modelos de linguagem. A possibilidade de treinar um único gate que funciona em múltiplos orçamentos de tokens também simplifica a engenharia: a mesma arquitetura pode operar em modo “econômico” ou “premium” conforme o plano de uso ou a criticidade da tarefa.
Há, porém, um custo inicial. O treinamento do módulo é cerca de 1,3 vez mais lento por passo que um ajuste fino simples como LoRA, o que exige investimento adicional de GPU na fase de preparação. Em contrapartida, a convergência mais rápida na maioria das tarefas reduz o tempo total de treinamento e antecipa o retorno em inferência mais barata.
Entenda o contexto
Modelos de linguagem baseados em transformadores sofrem com o custo quadrático da atenção: à medida que o contexto de entrada cresce, o modelo precisa comparar cada token com todos os outros, o que multiplica o uso de memória e o tempo de cálculo. Até agora, boa parte das tentativas de acelerar essa etapa envolvia heurísticas de poda sem treinamento, que perdiam precisão em taxas de corte mais agressivas, ou mudanças profundas na arquitetura, que exigiam pré-treinamento do zero.
O TokenGate ocupa um meio-termo atraente ao adicionar um componente aprendível sobre modelos já existentes, sem reescrevê-los do início. O código e os checkpoints foram liberados em um repositório público sob licença Apache-2.0, exigindo Python 3.10 ou superior e PyTorch com CUDA recente, com suporte opcional ao FlashAttention-2 para ainda mais velocidade em alguns backbones.
A abertura do código deve acelerar a adoção tanto no meio acadêmico quanto na indústria. Pesquisadores podem testar o módulo em modelos e benchmarks próprios, enquanto times de engenharia avaliam a integração em pipelines de produção para reduzir custos e latência. A tendência, a partir de agora, é que surjam variações e extensões do conceito de poda treinável de tokens, disputando espaço como solução de eficiência em um cenário em que LLMs de contexto cada vez maior se tornam padrão.