Dharma-AI lança modelo que reduz em 147x custo para extrair dados
Dharma-AI lança o Dharma Field Extractor, IA de 2 bilhões de parâmetros focada em extrair campos específicos de documentos e devolver tudo em JSON, com mais precisão e muito menos custo que modelos generalistas.
Inteligência Artificial
Nova solução da Dharma-AI oferece extração de dados mais precisa e econômica para documentos em formato JSON.
Leia também: Tencent lança Hy4 openrouter com 770 bilhões de parâmetros hoje
A Dharma-AI lançou o Dharma Field Extractor, um modelo de inteligência artificial especializado em extrair campos estruturados de documentos e devolver o resultado direto em JSON, prometendo mais precisão e um custo até 147 vezes menor que o de modelos de linguagem generalistas usados hoje em APIs.
Modelo foca em campos, não no texto inteiro
Diferente do OCR tradicional, que apenas lê e transcreve todo o texto da página, o novo modelo foi desenhado para buscar exatamente os dados que o usuário precisa em documentos como faturas, contratos, formulários, extratos bancários e documentos de identificação. “OCR dá o texto na página, fiel à formatação original, ideal para leitura integral de documentos”, explica a Dharma-AI. Já o novo sistema, segundo a empresa, vai direto aos pontos de interesse.
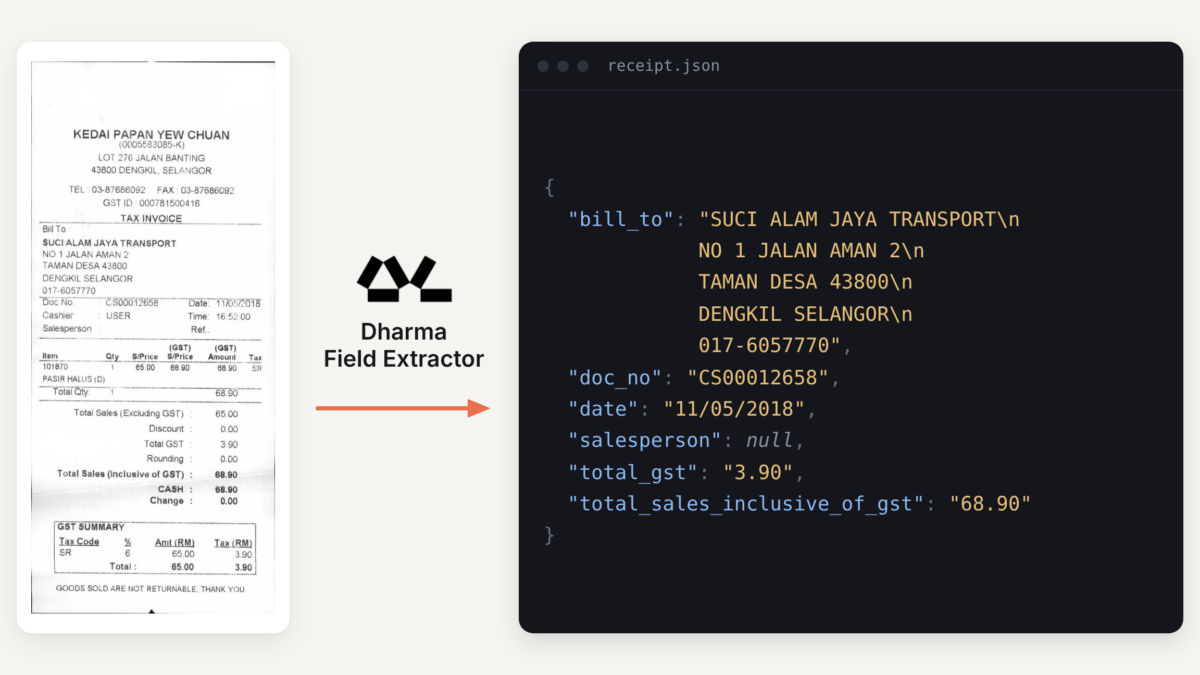
Na prática, o usuário envia a imagem do documento e uma instrução sobre quais campos deseja extrair. Essa instrução pode ser aberta — quando não se sabe exatamente o que há no documento — ou seguir um esquema rígido, com a estrutura exata que o sistema de destino espera. “O Field Extractor retorna JSON estruturado, com campos tipados e aninhados conforme o documento”, afirma a Dharma-AI.
O modelo tem 2 bilhões de parâmetros e roda em infraestrutura própria (self-hosted), por exemplo em uma GPU L40S dedicada, com custo estimado de US$ 2,24 por hora de GPU. Isso permite que empresas integrem a solução diretamente em seus fluxos internos, sem depender de APIs externas cobradas por volume de tokens.
Como funciona a extração em JSON
Quando recebe um pedido aberto, o Field Extractor tenta encontrar todos os campos relevantes do documento e devolve um JSON completo, com chaves que descrevem cada informação. Ao receber um esquema pré-definido, ele preenche exatamente aquela estrutura, mantendo os mesmos nomes de campos e sem adicionar extras, o que facilita a integração direta com bancos de dados e sistemas legados.
Os valores retornam tipados (por exemplo, números, datas ou textos) e, quando um campo solicitado não existe no documento, o modelo preenche o JSON com valor nulo. Isso evita pós-edições extensas e regras manuais de validação em sistemas de back office.
Segundo a Dharma-AI, o mesmo checkpoint é capaz de lidar com diferentes tipos de documentos — de recibos simples a formulários complexos, passando por IDs e documentos sintéticos — sem necessidade de ajuste específico por tipo.
Entenda o contexto
O Field Extractor é construído sobre a versão 1.1 do DharmaOCR-LITE, modelo de OCR especializado lançado em abril e já focado em leitura de contratos, faturas, petições, IDs e formulários. A nova versão do modelo base foi otimizada e continuou a ser treinada com supervisão e técnicas de preferência (como DPO) para melhorar a leitura e a compreensão de layout.
Sobre esse modelo base, a Dharma-AI treinou um adaptador adicional com 43.384 exemplos anotados em múltiplos domínios, todos organizados em fluxos de dados com anotações no nível de campo. O conjunto inclui recibos, faturas comerciais, formulários, extratos bancários, documentos de identificação e documentos sintéticos, o que amplia a capacidade de generalização para diferentes formatos usados em empresas.
O benchmark interno usou 546 documentos e 1.638 casos de extração, cobrindo três cenários: pedidos sem esquema, pedidos com esquema parcial e pedidos com esquema que inclui campos inexistentes. O desempenho foi medido por F1 no nível de campo — considerando a posição em tabelas — combinado com similaridade de Levenshtein para os valores e com a taxa de respostas em JSON válido.
Ganho de qualidade e corte de custo
Nos testes divulgados pela empresa, o Dharma Field Extractor superou quatro configurações de modelos de linguagem generalistas de ponta em qualidade de extração e custo operacional. “Contra LLMs generalistas, a qualidade do nosso modelo é de 1,8 a 9,3 pontos superior no F1, com custo de 6 a 147 vezes menor”, afirma a Dharma-AI.
O modelo de 2 bilhões de parâmetros registrou F1 de 0,834 no benchmark, à frente de todas as configurações generalistas avaliadas, enquanto rodava em uma única GPU L40S. A conta de custo compara o preço de APIs, que cobram por tokens de entrada e saída (incluindo raciocínio), com o valor de US$ 2,24 por hora da GPU dedicada para o Field Extractor, em um cenário de implantação self-hosted.
Na visão da empresa, o resultado reforça a tese de que modelos menores, altamente especializados e treinados para uma tarefa específica podem superar modelos gigantes e generalistas em tarefas bem delimitadas, a um custo muito menor.
Impacto para empresas e mercado de OCR
A tecnologia mira diretamente setores que lidam com grandes volumes de documentos e precisam extrair dados estruturados com rapidez e precisão, como financeiro, jurídico, saúde, logística e back offices em geral. Em vez de apenas digitalizar o texto, o modelo já entrega, por exemplo, os itens de uma nota fiscal em lista estruturada, os campos de um documento de identidade organizados nas colunas de cadastro ou os dados de requisições médicas prontos para alimentar agendas e sistemas clínicos.
Esse tipo de automação reduz a necessidade de digitação manual e de scripts complexos para mapear trechos de texto a campos específicos, diminuindo erros humanos e acelerando processos de cobrança, auditoria, compliance e atendimento. A extração consistente também tende a facilitar auditorias internas e externas, já que os dados chegam em formato padronizado.
Por outro lado, o movimento pressiona fornecedores tradicionais de OCR e APIs generalistas a oferecer soluções mais focadas em extração de campos, sob risco de perder espaço em projetos corporativos que exigem alta escala e controle de custo.
Disponível para testes e próximos passos
O Dharma Field Extractor já está disponível para testes imediatos em plataforma online, e pode ser implantado em infraestrutura própria para quem quer rodar o modelo em GPUs dedicadas. A expectativa é que empresas de diferentes setores iniciem projetos-piloto ao longo das próximas semanas para validar o desempenho em seus fluxos específicos de documentos.
A Dharma-AI indica que deve continuar ampliando o conjunto de documentos usados no treinamento, incluindo novos formatos e casos complexos, além de trabalhar em suporte para diferentes plataformas de hardware. Em médio prazo, soluções do tipo podem acelerar a digitalização de rotinas burocráticas e aprofundar a automação em áreas administrativas, mudando o desenho de equipes de back office e o papel de tarefas repetitivas em empresas de todos os portes.