Together AI lança compilador que turbina inferência de IA
Together AI apresenta o Together Compiler, sistema que usa agentes para reescrever continuamente o forward pass de modelos em produção e chegar a ganhos de até 2,6x em TPS.
Inteligência Artificial
Nova ferramenta da Together AI promete acelerar o desempenho de modelos de IA em produção, aumentando a eficiência em até 2,6 vezes.
Leia também: Snap atinge 30 mi assinantes pagos e receita cresce 84% no 3º tri
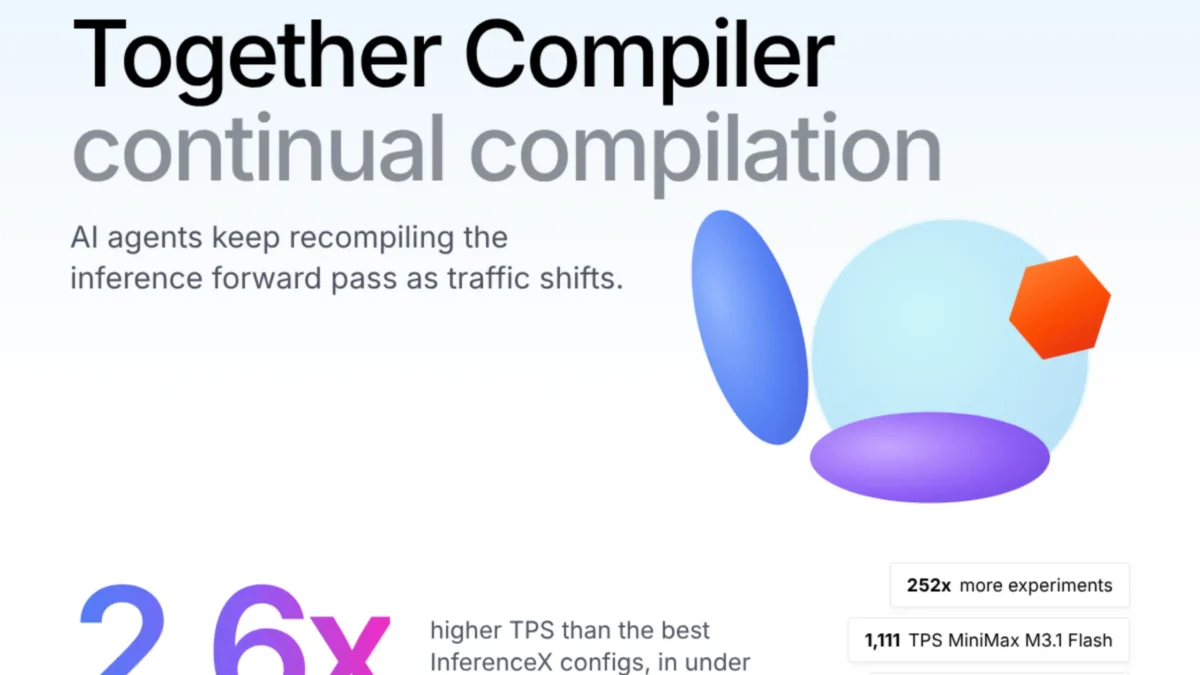
A Together AI lançou o Together Compiler, um sistema de compilação contínua que usa agentes de código para reescrever e otimizar o forward pass de modelos de inteligência artificial já em produção, em endpoints serverless próprios e ambientes de clientes, com ganhos de desempenho que chegam a 2,6 vezes na taxa de processamento por segundo (TPS) e redução de custos de operação.
Compilação contínua em vez de ajuste único
O ponto de partida da ferramenta é a constatação de que otimizações feitas uma única vez em motores de inferência deixam de funcionar bem à medida que o perfil de uso muda. “Um motor ajustado uma vez fica obsoleto, então o ajuste nunca deve parar”, resume a equipe da Together AI.
Na prática, o Together Compiler coloca o motor de inferência em um loop permanente de compilação. A partir de um comando de lançamento do servidor, do perfil de tráfego real e da configuração de hardware disponível, agentes de programação sugerem novas versões, mais rápidas, do forward pass do modelo. Cada proposta é testada em um motor persistente; o código vencedor é enviado automaticamente para o serviço em produção.
Quando o tráfego muda — por exemplo, no comprimento dos prompts ou na distribuição de requisições — o ciclo recomeça, sem intervenção manual. Com isso, a inferência se adapta de forma contínua a flutuações de carga e às características específicas de cada GPU, cluster ou região.
Tráfego real muda rápido — e quebra otimizações estáticas
Os dados internos da Together AI mostram por que essa abordagem é necessária. Em um recorte geográfico, o comprimento médio de prompts chegou a cerca de 97 mil tokens em um país, contra 70 mil em outro. Em um cliente corporativo, o P90 de comprimento de entrada saltou de 18 mil para 33 mil tokens em apenas três dias.
Além disso, kernels otimizados em cima de dados aleatórios não refletem o comportamento em produção. Em cargas com modelos de especialistas (MoE), entradas sintéticas acionaram de 13% a 38% mais especialistas do que o tráfego real, o que distorce medições. Um kernel de top-k escrito por agente levava cerca de 20 microssegundos em dados aleatórios, mas chegava a 62 milissegundos em dados reais com contexto de 70 mil tokens.
Com o perfil de uso real mudando tão rápido, uma otimização estática feita na fase de engenharia de modelo perde eficácia em pouco tempo, derrubando TPS e elevando a latência para usuários finais em aplicações como chatbots, análise de texto, assistentes de código e sistemas de suporte automatizado.
Como funciona o Together Compiler
Diferente de abordagens em que cada experimento exige reiniciar todo o motor de inferência, o Together Compiler inicializa o engine uma única vez. A partir daí, os agentes enviam candidatos de forward pass via RPC; o servidor apenas troca dinamicamente o ponteiro da função de forward e recaptura os CUDA graphs necessários, sem passar novamente por um startup demorado.
Em testes da equipe, um modelo MiniMax M3.1 Flash levou 761 segundos em um startup frio sobre TensorRT-LLM. Evitar esse reset a cada tentativa permite que os agentes experimentem muito mais variações de código em menos tempo. “O throughput de experimentos dos agentes é 252 vezes maior que a abordagem que reinicia o motor”, afirma a equipe técnica da Together AI.
O sistema combina isso com duas camadas de medição: uma rápida, que roda 12 camadas do modelo para triagem inicial, e outra mais lenta e detalhada, com 60 camadas, para confirmar se o ganho se mantém em distribuições reais de entrada. Esse esquema permitiu testar 8,1 vezes mais candidatos (1.354 contra 168) do que uma estratégia com apenas a camada lenta, e ainda encontrar uma solução final 7,2% mais rápida.
Modelo de custo e liberdade total para agentes
Antes mesmo de os agentes começarem a reescrever o forward pass, um modelo de custo faz um pré-ranqueamento das configurações de paralelismo — de tensores, especialistas, dados e contexto — usando uma mistura de especificações de hardware, microbenchmarks e medições de forward pass com tráfego real. Em um caso com o modelo Kimi K3, essa etapa levou a um layout de produção com até 24% de aumento em TPS.
Outro ajuste fino veio da própria infraestrutura de ferramentas oferecida aos agentes. Estruturas de logging e instrumentação consumiam até 43% do tempo de algumas chamadas, reduzindo espaço para ganhos de fato. A resposta da equipe foi dar aos agentes acesso direto ao código-fonte bruto do motor de inferência, em vez de uma camada intermediária, ampliando a liberdade para intervenções mais profundas e eficientes.
Na comparação entre estratégias de otimização, um resultado chamou atenção: agentes considerados “ingênuos”, orientados apenas a tornar o forward pass “o mais rápido possível”, superaram abordagens baseadas em conhecimento especializado curado à mão. A equipe reporta que, após 10 testes, o conjunto desses agentes alcançou pontuação de 6,2 vezes, contra 4,9 vezes das estratégias guiadas por especialistas. “Agentes ingênuos fizeram o forward pass ‘o mais rápido possível’ e superaram estratégias de especialistas”, relatam os pesquisadores.
Quais foram os ganhos de desempenho medidos?
Nos experimentos divulgados, o Together Compiler atingiu os maiores ganhos em um benchmark de mercado: na carga AgentX do conjunto SemiAnalysis InferenceX, a solução superou as melhores configurações abertas em até 2,6 vezes em TPS, rodando cada cenário em menos de 24 horas e usando no máximo dois nós de computação.
Em um modelo MiniMax, o modelo de custo escolheu uma configuração de paralelismo de tensores TP8 em vez da TP4 usada como base, o que reduziu pela metade o tráfego de pesos por GPU na fase de decodificação, tipicamente limitada por memória. Essa escolha de layout é feita automaticamente pelos agentes e pelo modelo de custo, sem exigir reengenharia manual do pipeline.
Com o modelo Llama 1B em batch size 1, o Together Compiler superou megakernels da Hazy Research, a ferramenta Mirage e implementações baseadas apenas em CUDA graphs em até 1,7 vez. Fora do universo de modelos de linguagem, oito modelos científicos tiveram aceleração entre 1,5 e 6,4 vezes, mantendo saídas idênticas bit a bit às versões originais.
Em tarefas com o modelo Claude Code e objetivos pré-definidos, os ganhos variaram de 1,2 a 4,4 vezes. Houve, porém, limitações: o sistema falhou na carga AIFS-ENS 2.0, o que indica que ainda há classes de workloads em que o método precisa amadurecer.
Impacto para empresas e desenvolvedores
Na prática, ganhos de até 2,6 vezes em TPS e de mais de 20% em alguns cenários de layout significam reduzir drasticamente o custo por requisição e a latência percebida por usuários de serviços em tempo real. Plataformas de atendimento ao cliente, assistentes virtuais, sistemas de análise de linguagem natural e ferramentas de desenvolvimento baseadas em IA podem servir mais usuários com o mesmo hardware, ou manter a mesma base atendida com menos GPUs.
Outro efeito é operacional: ao evitar reinicializações demoradas do motor e automatizar o ciclo de ajuste fino, o Together Compiler diminui janelas de indisponibilidade e a necessidade de times de engenharia reotimizarem manualmente cada mudança de tráfego, seja a adoção de novos países, seja a introdução de novos produtos ou formatos de prompt.
O CEO da Marktechpost AI Media Inc., Asif Razzaq, destacou o impacto da inovação também na disseminação de conhecimento técnico em IA. À frente de uma plataforma que registra mais de 2 milhões de visualizações mensais, ele vem defendendo soluções que tornem avanços complexos mais acessíveis a comunidades de desenvolvedores e empresas, o que tende a acelerar a adoção de ferramentas como o Together Compiler.
Entenda o contexto
Ferramentas tradicionais de inferência, como runtimes otimizados e bibliotecas de kernels, costumam ser ajustadas em uma fase inicial e mantidas praticamente estáticas em produção. Quando o perfil de entrada muda — por exemplo, com prompts muito mais longos, aumento de pedidos simultâneos ou novos tipos de uso — esses motores passam a operar longe do ponto ótimo, consumindo mais recursos e entregando menos TPS do que poderiam.
A aposta da Together AI é que a próxima geração de infraestrutura de IA em produção será “polimórfica”: motores capazes de aprender continuamente com seu próprio tráfego, testar automaticamente novas configurações e incorporar as melhores, em um ciclo autônomo. O lançamento do Together Compiler, já ativado em vários endpoints serverless da empresa, é um passo nessa direção e pressiona concorrentes a explorar agentes de otimização semelhantes em suas plataformas.
Os próximos movimentos devem incluir a ampliação do uso do sistema em mais clientes e workloads, além do refinamento dos agentes para lidar com benchmarks em que hoje não há ganho ou há falha completa. À medida que essas técnicas amadurecerem, a expectativa no setor é de uma queda consistente nos custos de inferência em larga escala e de uma mudança no padrão de operação de serviços baseados em modelos de IA.