Meta lança JiTTests com IA e evita 74 falhas graves em 2026
Meta leva ao ambiente de produção o JiTTests, sistema com IA que gera testes projetados para falhar quando um diff de código introduz bugs ou riscos de privacidade, cortando 70% da revisão humana.
Tecnologia
Sistema inovador da Meta usa IA para detectar falhas e reduzir revisões manuais em códigos de produção.
Leia também: Como knowledge graphs vão transformar a IA corporativa em 2026
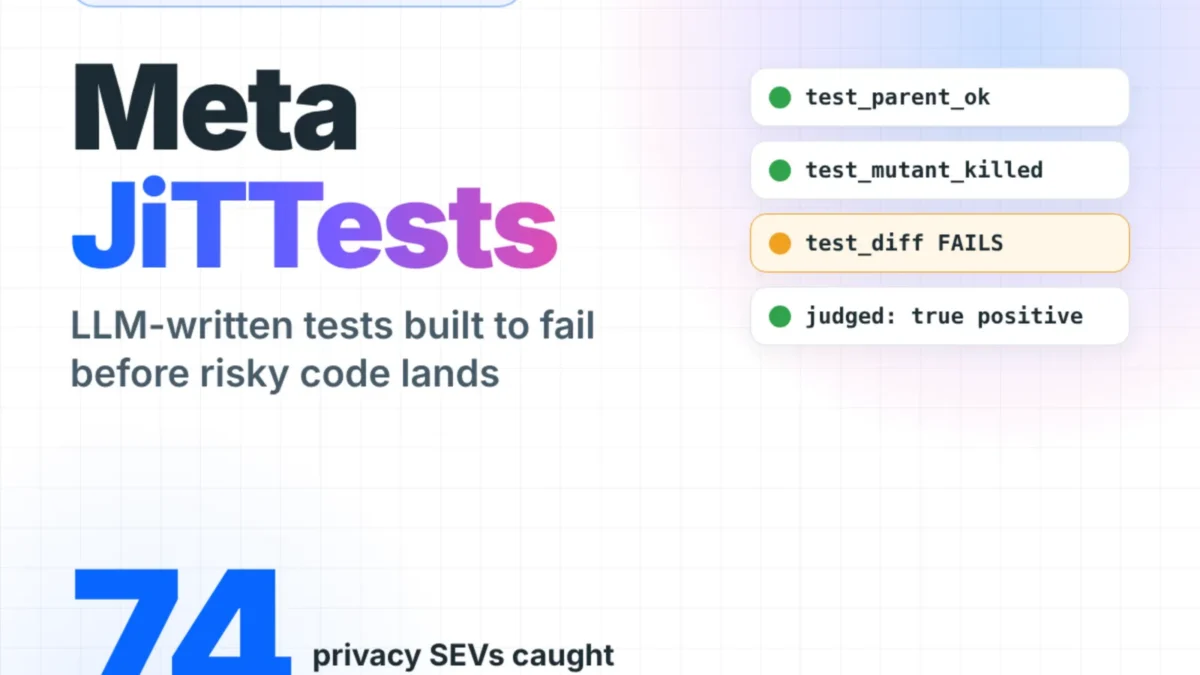
A Meta integrou em 2026 ao seu ambiente de produção o JiTTests, sistema que usa modelos de linguagem (LLMs) para gerar testes automatizados que devem falhar quando uma mudança de código introduz um bug ou comportamento arriscado, sobretudo em privacidade. A ferramenta atua antes da integração do código principal e já interceptou 74 falhas graves de privacidade apenas no primeiro semestre do ano, segundo a equipe de engenharia.
O que são os JiTTests da Meta?
JiTTests são testes gerados por IA, criados sob medida para cada diff – a mudança de código em revisão – e projetados para falhar se essa mudança alterar o comportamento do sistema de forma perigosa. Em vez de proteger apenas contra regressões futuras, como fazem testes tradicionais, eles miram a alteração recém-escrita.
Na definição da própria equipe, “a failing test is concrete evidence that a diff changed behavior”. Ou seja, um teste que falha não é apenas um alerta abstrato: é uma prova executável de que aquela mudança fez o software se comportar de outro jeito, potencialmente com impacto em privacidade, segurança ou confiabilidade.
A tecnologia foi descrita em detalhes no artigo apresentado na conferência FSE 2026 e se apoia em uma metodologia formalizada em 2025, no trabalho “Harden and Catch”, que separa testes em dois grupos: os que endurecem a base de código contra problemas futuros e os que “caçam” problemas na mudança em análise.
Como os JiTTests usam inteligência artificial para testar códigos?
O sistema parte sempre de um diff e passa por cinco estágios internos, que combinam geração de código de teste por LLMs, mutação do código original e filtros automáticos. Os modelos de linguagem escrevem testes executáveis, mas esses testes não chegam diretamente aos engenheiros: eles são primeiro avaliados por um conjunto de “juízes” baseados em regras determinísticas e em outros LLMs.
“The rule-based and LLM assessors cut human review load by 70%”, afirma a equipe. Isso significa que a maior parte dos testes ruins, redundantes ou irrelevantes é descartada automaticamente, e apenas uma fração dos casos mais promissores – os chamados candidate catches – é encaminhada para análise humana.
Na fase de pesquisa, foram analisados 22.126 testes gerados. Abordagens que levam o diff em conta produziram quatro vezes mais candidatos a falhas do que testes de endurecimento tradicionais e vinte vezes mais do que falhas ocorridas por coincidência, o que indica maior poder de detecção direcionada.
Entenda o contexto
Em trabalhos anteriores, a Meta já havia explorado o uso de mutação de código e geração automática de testes, com um método chamado ACH (mutation-guided hardening). Nessa abordagem, porém, o foco era ampliar a cobertura de testes existentes, e não mirar o diff específico em revisão.
Os JiTTests, por outro lado, são “just-in-time catching tests”: nascem colados à mudança de código, com o objetivo explícito de tentar quebrá-la antes que ela seja integrada à base principal. É uma mudança de postura em relação a ferramentas de IA que apenas “leem o código e deixam comentários”. Como resume a equipe: “Most AI bug tools act like faster human reviewers. They read the diff and leave comments. JiTTests instead execute code and show a concrete behavioral difference.”
Como funcionam os workflows dodgy diff e intent-aware
O JiTTests opera hoje com dois fluxos principais. O primeiro, batizado de “dodgy diff”, parte de uma suposição agressiva: toda mudança é potencialmente problemática. O sistema trata o novo código como um mutante de seu antecessor e pede aos LLMs que gerem testes capazes de distinguir um do outro. Se o teste passar no código antigo e falhar no novo, surge um alerta.
O segundo fluxo, “intent-aware”, tenta primeiro entender qual é a intenção da mudança. A partir do código, do título e do resumo do diff, o sistema infere o que ele deveria fazer, lista riscos associados e cria uma série de versões mutantes que materializam esses riscos. Em seguida, pede ao LLM que escreva testes para “matar” cada mutante. Quando esses testes, já depurados pelos filtros, falham no código real, são classificados como “weak catches” – indícios fortes de um problema na implementação.
Nos experimentos relatados, o fluxo intent-aware obteve taxas de weak catches em 6,4% dos testes gerados e em 7,9% dos diffs analisados. O dodgy diff atingiu 2,5% e 4,0%, respectivamente. O método ACH anterior, usado como base de comparação, marcou apenas 0,8% de weak catches entre os testes e 1,6% entre os diffs, mostrando vantagem consistente para as abordagens guiadas pelo diff.
Supervisão humana em modo “human-on-the-loop”
Embora o JiTTests seja amplamente automatizado, a Meta mantém supervisão humana no nível de políticas, em um modelo descrito como “human-on-the-loop”. “Human-on-the-loop means engineers set criteria and monitor results in aggregate. They intervene at the policy level, not on each test”, explica a equipe.
Na prática, isso significa que engenheiros monitoram métricas agregadas – como taxas de weak catches, volume de testes descartados, número de candidatos reportados – e ajustam regras, thresholds e escopo de atuação. Eles raramente precisam ler o código dos testes; a intervenção ocorre quando há padrões estranhos ou impactos inesperados nos fluxos de desenvolvimento.
Na implantação inicial, o sistema reportou 41 candidatos a falhas para engenheiros. Desses, 8 foram confirmados como verdadeiros positivos, o que representa uma taxa de acerto de 19,5%. Quatro desses casos poderiam ter causado falhas graves em produção se tivessem passado pela revisão tradicional.
Como os JiTTests podem melhorar a segurança do software na Meta?
Os números apresentados pela Meta indicam impacto direto na segurança de software, sobretudo em privacidade. No primeiro semestre de 2026, o JiTTests interceptou 74 incidentes graves de privacidade (privacy SEVs) ainda na fase de revisão de código. Esses problemas deixaram de avançar para os estágios seguintes da esteira de desenvolvimento, onde a correção costuma ser mais cara e, em casos extremos, pode exigir mitigação junto a usuários.
Além de encontrar mais problemas, a abordagem muda a natureza da evidência levada ao engenheiro. Em vez de uma sugestão textual, o revisor recebe um teste executável que demonstra a diferença de comportamento. Ao rodar o teste, o engenheiro vê, na prática, o cenário em que a mudança se comporta de forma divergente, o que torna a análise mais objetiva.
Internamente, áreas ligadas à segurança, privacidade e qualidade de código também se beneficiam da redução de carga manual. Com a revisão humana cortada em cerca de 70%, essas equipes podem concentrar esforço em casos de maior risco ou em decisões de alto nível, em vez de gastar tempo triando alertas pouco relevantes.
Quais os benefícios dos testes gerados por LLMs em comparação com testes tradicionais?
Os testes gerados por LLMs no JiTTests trazem duas vantagens centrais. A primeira é o foco contextual: como o modelo recebe o diff, o código ao redor e metadados como título e descrição, ele consegue escrever testes direcionados ao que realmente mudou, em vez de apenas ampliar a cobertura de forma genérica.
A segunda é a capacidade de explorar variações e hipóteses de risco de maneira mais ampla do que um engenheiro individual faria sob pressão de tempo. Ao criar mutantes para cada risco listado e gerar testes para “eliminá-los”, o sistema automatiza uma forma de pensamento adversarial – imaginar como a mudança pode dar errado – que costuma ser difícil de escalar em equipes grandes.
Os dados comparativos reforçam esse ganho: métodos sensíveis ao diff produziram quatro vezes mais candidatos a falhas do que testes de endurecimento tradicionais e vinte vezes mais do que falhas por coincidência. Ao mesmo tempo, a filtragem por juízes automáticos impede que esse aumento de sensibilidade se traduza em uma avalanche de falsos positivos para os revisores humanos.
Quando os JiTTests começaram a ser usados pela Meta?
O JiTTests chegou à infraestrutura de produção da Meta em 2026, após uma fase de pesquisa em que a metodologia foi definida no trabalho “Harden and Catch” e, depois, detalhada no artigo “Just-in-Time Catching Test Generation at Meta”, apresentado na FSE 2026.
Ao longo do primeiro semestre, o sistema já acumulava 74 falhas graves de privacidade interceptadas no estágio de diff. Em outubro de 2026, uma atualização da equipe de engenharia trouxe números mais robustos e descreveu a maturidade maior do pipeline, com supervisão humana reduzida ao nível de políticas e pouca necessidade de revisar manualmente o código dos testes.
Impacto na indústria e próximos passos
A Meta não transformou o JiTTests em produto público: não há código aberto, modelos disponibilizados nem API externa. “The answer is No. JiTTests is internal Meta infrastructure”, registrou a equipe ao comentar o interesse da comunidade. Ainda assim, o desenho geral – geração de testes guiada por diffs, uso de mutantes, conjunto de juízes LLM + regras e supervisão em modo human-on-the-loop – pode ser replicado por outras empresas.
Na prática, o movimento aponta para uma nova fase na relação entre desenvolvimento de software e IA: em vez de apenas acelerar tarefas humanas, como revisão de código, as ferramentas passam a executar o próprio código e fornecer evidências concretas de comportamento. Se a abordagem se popularizar, práticas de revisão em larga escala podem ser redesenhadas, com maior integração entre automação agressiva de testes e controle humano focado em políticas, risco e impacto ao usuário final.