Retenção de dados em IA: entenda os 2 modelos e riscos reais
Zero retenção de dados e armazenamento por batch jobs definem como APIs de IA lidam com o que você envia. Entenda quem controla, onde fica e quando é apagado.
Inteligência Artificial
Descubra como diferentes modelos de retenção de dados impactam a segurança e privacidade nas APIs de IA.
Leia também: Orquestração autônoma em Kubernetes reduz 80% do custo de IA
As dúvidas sobre o que acontece com os dados enviados a APIs de inteligência artificial levaram plataformas como OpenAI, Fireworks AI, Amazon Bedrock, Google e Anthropic a detalhar dois modelos padrão de retenção: um com zero retenção de dados (ZDR), típico de inferência em tempo real, e outro baseado em batch jobs, em que datasets ficam armazenados até o próprio cliente pedir a exclusão.
O que é retenção de dados em IA?
Retenção de dados em IA é o conjunto de regras que define o que uma plataforma guarda de cada requisição feita às suas APIs, onde esse material fica armazenado e por quanto tempo ele permanece antes de ser apagado ou anonimizado.
Na prática, isso envolve desde o prompt enviado para um modelo de linguagem até arquivos inteiros usados em treinamentos ou análises em lote. As políticas recentes revisadas em 15 de novembro de 2026 mostram que o desenho da API — e não apenas o texto de privacidade — é o que determina se o dado será descartado logo após o uso ou mantido em algum tipo de armazenamento.
Essas regras também se dividem em camadas. Documentações descrevem, por exemplo, uma camada de “estado da aplicação”, que inclui arquivos e datasets que o próprio recurso precisa guardar para funcionar, e uma camada de logs de monitoramento de abuso, mantidos por tempo limitado para fins de segurança. Uma API pode operar com zero retenção em uma camada e, ainda assim, registrar logs mínimos na outra.
Entenda o contexto
O tema ganhou fôlego após uma sequência de manchetes sobre segurança em IA, que deixaram muitos times de desenvolvimento com a pergunta mais básica: o provedor de IA guarda meu dado? A resposta, mostram o post de 13 de novembro de 2026 da cofundadora e CEO da Fireworks AI, Lin Qiao, e a documentação das principais plataformas checada em 15 de novembro, depende de como o cliente manda a informação.
Em linhas gerais, enviar um prompt para uma API de inferência em tempo real segue o modelo de zero retenção de dados, enquanto fazer upload de um arquivo para execução posterior se encaixa no modelo de batch jobs, com armazenamento até ordem em contrário. Para o CEO da Marktechpost AI Media Inc., Asif Razzaq, esse esclarecimento é central para restaurar a confiança em um momento em que a discussão sobre segurança e privacidade em IA está mais ruidosa do que técnica.
Quais são os dois designs padrão para retenção de dados em IA explicados na matéria?
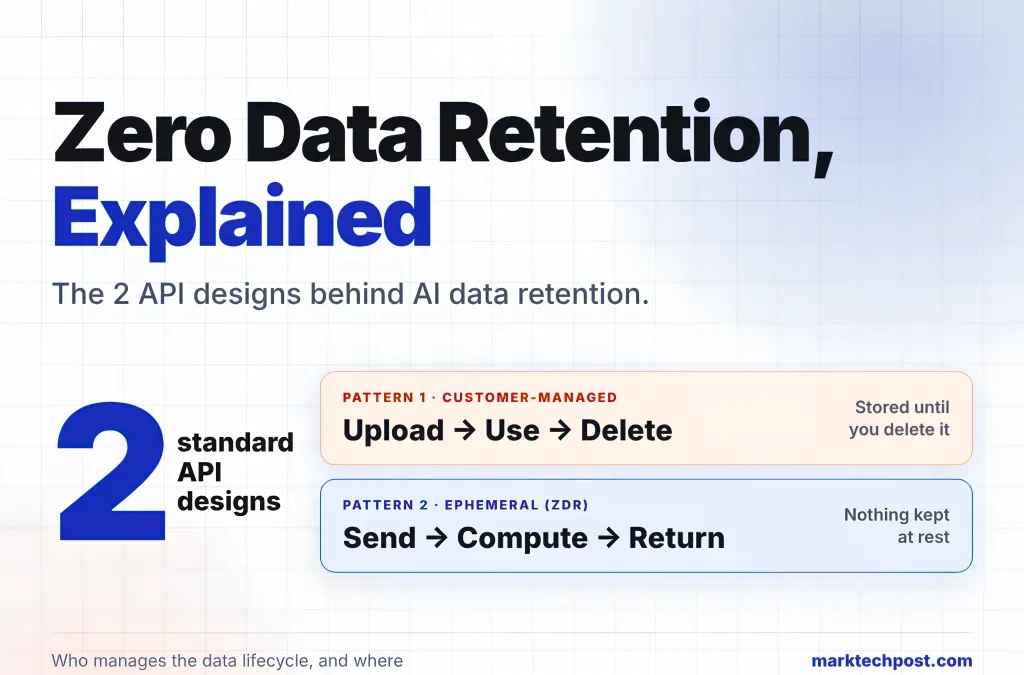
Os dois designs padrão são: o modelo de zero retenção de dados (ZDR), usado em inferência em tempo real, e o modelo de batch jobs, baseado em upload e armazenamento de datasets até que o cliente peça a exclusão.
No modelo de batch jobs, o cliente cria um arquivo ou dataset, envia para a plataforma, roda jobs em cima desse material e depois precisa mandar apagar. Enquanto isso não acontece, o dado fica guardado e acessível. A plataforma não tem como saber sozinha se aquele dataset ainda é útil ou não para a aplicação, por isso a responsabilidade pelo fim do ciclo de vida é do cliente, via APIs específicas de deleção.
É nesse padrão que se encaixam, por exemplo, os arquivos batch da OpenAI, que têm retenção padrão de 30 dias, e da Anthropic, com 29 dias. Há também variações em que o armazenamento ocorre na nuvem do próprio cliente: Amazon Bedrock e Google estruturam parte dos batch jobs lendo e escrevendo em buckets que o usuário controla diretamente em sua infraestrutura de nuvem.
Já a Fireworks AI adota um modelo em que datasets de treinamento gerenciados pelo cliente podem ficar armazenados sem limite de tempo. Eles só deixam de existir após um pedido explícito de exclusão, e a empresa afirma que, cumprida essa etapa, nenhum dado permanece guardado. Lin Qiao resume essa lógica dizendo que, nesse contexto, “once you delete the data, it is gone”.
Como funciona a zero retenção de dados nas APIs de IA?
No modelo de zero retenção de dados, o cliente envia a entrada, a plataforma roda o modelo, devolve a resposta e descarta o conteúdo, sem manter o histórico da aplicação ou qualquer estado adicional atrelado àquela requisição.
É o padrão das APIs de inferência síncronas quando estão configuradas com ZDR: a conversa, os prompts e as respostas ficam sob controle exclusivo da aplicação do cliente, que decide se e onde vai armazenar esse histórico. A plataforma de IA se limita a calcular e responder, sem guardar cópias persistentes do texto ou dos arquivos processados.
Documentações recentes apontam que Fireworks AI oferece zero retenção como padrão para modelos abertos em suas APIs de inferência efêmera, no Training SDK e no produto Nexus, com a garantia de que prompts e gerações não são persistidos em repouso. Outras plataformas permitem modos semelhantes, como o “none mode” da Amazon Bedrock, que não escreve dados de requisição e resposta em armazenamento durável quando ativado.
Um ponto de atenção é que ZDR vale por endpoint, não por plataforma inteira. Em alguns serviços, um único parâmetro muda o comportamento: na Interactions API do Google, por exemplo, o parâmetro de armazenamento vem ativado por padrão. Já em certos endpoints da OpenAI, zerar a flag de armazenamento não equivale automaticamente a ZDR integral, e a própria empresa condiciona esse modo a aprovação específica.
Logs, exceções e conteúdo sensível
Mesmo em cenários de zero retenção de dados, há exceções ligadas a segurança. A OpenAI informa que mantém logs de monitoramento de abuso por até 30 dias, mesmo quando o fluxo principal é desenhado como efêmero. Esses registros servem para investigar uso malicioso, fraudes e ataques às APIs.
OpenAI e Amazon Web Services também registram, em suas políticas, que conteúdos sinalizados como material de abuso infantil (CSAM) podem ser preservados, ainda que o restante da requisição siga um regime de zero retenção. A justificativa é o cumprimento de obrigações legais e de cooperação com autoridades. Ou seja, ZDR não significa ausência total de qualquer cópia transitória ou evidência em casos extremos.
Impacto para desenvolvedores e empresas
A clarificação desses dois modelos muda a forma como times técnicos desenham suas arquiteturas. Em setores como saúde e finanças, em que dados sensíveis são regra, o processamento efêmero reduz a superfície de ataque e a chance de vazamentos decorrentes de falhas humanas — como esquecer um dataset em produção ou deixar de acionar um endpoint de deleção.
Regulações como o GDPR, na União Europeia, reforçam essa direção ao prever, no artigo 5, o princípio da limitação do armazenamento. Processar dados de forma efêmera, sem gravação em disco, ajuda a cumprir esse requisito. Mas a minimização real ainda depende do que a própria aplicação envia: prompts que incluem informações pessoais desnecessárias continuam gerando risco, mesmo em fluxos de ZDR.
Por outro lado, o modelo de batch jobs é indispensável quando o objetivo é fazer fine-tuning com datasets volumosos, rodar análises históricas ou treinar recursos sob medida. Nesses casos, empresas precisam investir em processos internos claros para revisar o que já não é necessário, agendar deleções e auditar seus próprios armazenamento e acessos, sob pena de acumular bases esquecidas que se tornam passivos de segurança e de conformidade.
Por que é importante esclarecer a retenção de dados em IA?
Esclarecer a retenção de dados em IA é importante porque define o nível de risco, a responsabilidade legal e o grau de controle que empresas e usuários têm sobre tudo o que enviam às APIs.
Na ausência de informação clara, organizações tendem a supor o pior — que todo dado enviado será armazenado indefinidamente pelo provedor — e acabam restringindo usos legítimos e seguros da tecnologia. Com os dois modelos bem delimitados, cada time pode alinhar requisitos de compliance, como GDPR e leis nacionais de proteção de dados, ao desenho técnico mais adequado.
Lin Qiao defende que o processamento efêmero seja a primeira opção: “ephemeral processing is preferable whenever the workflow allows it”. A lógica é simples: quanto menos cópias existirem, menos itens será preciso proteger, rastrear e, mais tarde, excluir. Isso também reduz a margem para erro humano, como uma rota de deleção que falha ou uma rotina de expiração mal configurada.
Ao mesmo tempo, o debate em torno de logs de abuso, retenção de conteúdo sensível e tempos padrões de expiração mostra que não há solução única. As políticas seguem em evolução e devem continuar sendo ajustadas diante de novas regras, como o avanço de normas europeias específicas para IA, e de novas pressões por transparência.
Principais diferenças entre os dois modelos
A linha que separa os dois padrões é quem gerencia o ciclo de vida do dado e onde esse ciclo acontece. Nos batch jobs, o ciclo é explícito: o cliente sobe o dataset, roda jobs, depois manda apagar. O armazenamento é uma parte declarada do fluxo, com tempos padrões como 30 dias, no caso de arquivos batch da OpenAI, e 29 dias, na Anthropic, além de opções sem prazo na Fireworks AI ou com uso da nuvem própria do cliente em Amazon Bedrock e Google.
Na inferência em tempo real com ZDR, o ciclo de vida acontece totalmente dentro da aplicação do cliente. A plataforma não sabe — e não precisa saber — nada sobre o histórico de conversas ou a jornada do usuário; ela apenas recebe, calcula e descarta. Isso elimina a etapa de limpeza do lado do provedor, mas exige que o desenvolvedor saiba exatamente o que está armazenando em seus próprios sistemas e por quanto tempo.
Para especialistas como Asif Razzaq, a tendência é que o processamento efêmero se torne padrão em todos os fluxos em que o armazenamento não é estritamente necessário. Já os casos em que guardar dados é inevitável devem vir acompanhados de controles mais rígidos, logs auditáveis e garantias técnicas de exclusão completa após o fim do uso declarado.