Bland lança Tofu-1, IA que atende chamadas com voz natural
Bland, startup de São Francisco, lança o Tofu-1, modelo de IA full-duplex que ouve e responde em áudio direto na chamada, sem transcrição, mirando bancos, saúde, seguros e governo.
Tecnologia
Startup de São Francisco apresenta IA que interage por áudio em tempo real, revolucionando atendimento em setores como bancos e saúde.
Leia também: Como knowledge graphs vão transformar a IA corporativa em 2026
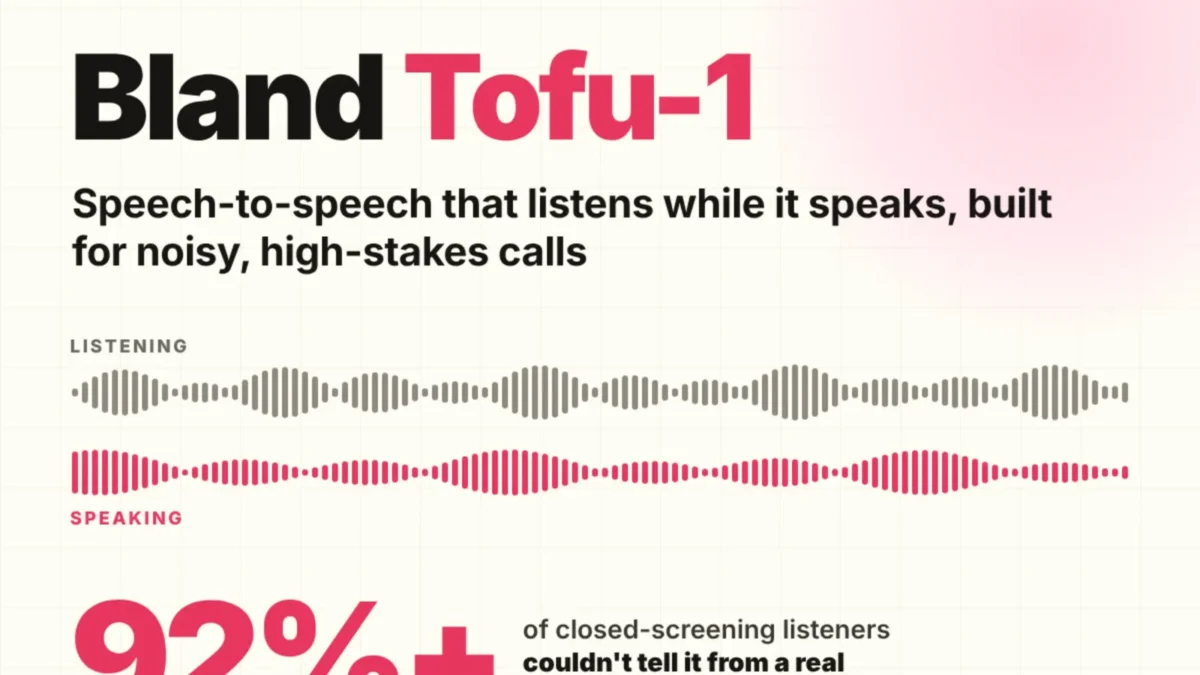
A Bland, startup de inteligência artificial de voz sediada em São Francisco, lançou o Tofu-1, um modelo de fala para fala full-duplex que atende chamadas telefônicas ouvindo e respondendo apenas em áudio, sem passar por transcrição de texto e com mira em setores como bancos, saúde, seguros e governo.
Modelo ouve e fala ao mesmo tempo, sem texto no meio
O Tofu-1 foi apresentado em prévia de pesquisa como o primeiro modelo de uma família de soluções de fala para fala da Bland. A proposta é substituir os agentes de voz em cascata — que convertem fala em texto, processam com um modelo de linguagem e depois reconvertem em áudio — por um sistema capaz de operar diretamente sobre o som da chamada.
“Tofu-1 listens to the audio directly, so tone, hesitation and background sound stay available to the model”, afirma a Bland em material de lançamento. Ao trabalhar assim, o modelo preserva nuances da voz, pausas e ruídos de fundo, elementos que costumam se perder quando tudo é convertido para texto.
Segundo a empresa, o Tofu-1 escuta enquanto fala e “reasons while it talks”, o que permite interações mais próximas de uma conversa humana, inclusive em linhas com sinal fraco ou ambientes ruidosos, como carros em movimento e quartos de hospital.
Chamadas mais naturais, com interrupções e correções
Um dos diferenciais enfatizados pela Bland é a capacidade do sistema de lidar com a conversa em tempo real, aceitando interrupções e correções sem travar o fluxo. “Callers can interrupt or correct Tofu-1 mid-sentence. While it works on a request, it keeps the conversation moving. It reports the result only when the work is done. It never claims a task is finished early”, descreve a empresa.
Na prática, isso significa que o usuário pode mudar de ideia no meio da explicação, acrescentar um dado ou ajustar uma instrução, e o modelo se adapta sem precisar esperar o fim da frase ou um novo comando separado, reduzindo frustrações comuns em centrais telefônicas automatizadas.
A Bland também destaca que o modelo é treinado para fazer triagem de sons de fundo e focar no que é relevante da fala principal, algo crítico em serviços de atendimento em casa, em trânsito ou em ambientes compartilhados.
IA simula ambiente da ligação, inclusive ruído de linha
Além de entender o áudio de forma mais rica, o Tofu-1 tenta reproduzir a experiência sonora de uma chamada real. “Because Tofu-1 models the sound of a call, it can also produce one. That includes a second speaker, the room around them and line noise”, afirma a Bland.
Isso inclui simular a voz do atendente artificial, o ambiente ao redor e até ruídos típicos de linha telefônica, criando uma sensação de conversa contínua, e não de mensagens soltas geradas por uma máquina. A empresa posiciona essa característica como um passo importante para tornar a interação com IA mais crível em contextos delicados, como atendimento bancário ou médico.
Para testar a robustez do modelo em cenários ruidosos, a Bland criou o chamado “TV Test”. “The TV Test asks one question: can the model follow the caller while ignoring speech from another scene? TV audio is often louder than the caller”, resume o material. As demonstrações divulgadas são descritas como ilustrativas, não saídas gravadas diretamente do modelo.
Entenda o contexto
Hoje, a maior parte dos sistemas de atendimento por voz depende de uma cadeia de processamento: primeiro a fala é transformada em texto, depois passada a um modelo de linguagem, e só então vem a resposta sintetizada em áudio. Cada etapa adiciona latência e aumenta a chance de erro, principalmente quando há ruído, sotaques fortes ou falas sobrepostas.
Ao trabalhar diretamente com áudio de ponta a ponta, o Tofu-1 tenta reduzir essa demora e preservar informações que não aparecem na transcrição, como tom de voz e hesitações — sinais que podem indicar, por exemplo, dúvida, urgência ou frustração. Para bancos, hospitais, seguradoras e órgãos públicos, isso pode significar atendimentos menos mecânicos e com melhor compreensão do contexto.
O movimento também pressiona fornecedores tradicionais de URAs e assistentes de voz baseados em texto a reverem suas arquiteturas ou buscarem parcerias, sob risco de ficarem para trás em naturalidade e desempenho em ambientes difíceis.
Acesso restrito e foco em grandes volumes de chamadas
O Tofu-1 está disponível em prévia de pesquisa para um número limitado de empresas, mediante cadastro. No formulário de inscrição, a Bland pede que as interessadas informem o volume mensal de chamadas, com faixas que vão de menos de 1.000 a mais de 50.000 ligações por mês, o que indica uma estratégia voltada sobretudo a operações de atendimento em grande escala.
A startup cita explicitamente bancos, saúde, seguros e governo como setores prioritários neste início. Detalhes técnicos mais finos e opções de implantação são oferecidos pela empresa em canais próprios, mas a Bland optou por não divulgar a arquitetura interna do modelo, o que pode indicar uma tentativa de proteger propriedade intelectual em um mercado cada vez mais competitivo.
O lançamento do Tofu-1 marca a estreia da família de modelos de fala para fala da Bland. A empresa aposta que, com esse tipo de tecnologia, o atendimento telefônico em cenários críticos — de centrais de fraude bancária a leitos de hospital — pode ganhar em velocidade, precisão e satisfação do usuário, à medida que a prévia evoluir e o acesso for ampliado.