NVIDIA lança Auto Ontology para tornar consultas de IA mais confiáveis
NVIDIA libera Auto Ontology, camada semântica open source que ajuda agentes de IA a gerar SQL preciso sobre dados corporativos, reduzindo erros e reforçando governança.
Tecnologia
Nova ferramenta da NVIDIA aprimora a precisão das consultas de IA em bancos de dados empresariais, fortalecendo a governança dos dados.
Leia também: Startup cria IA que aprende com você e economiza horas diárias
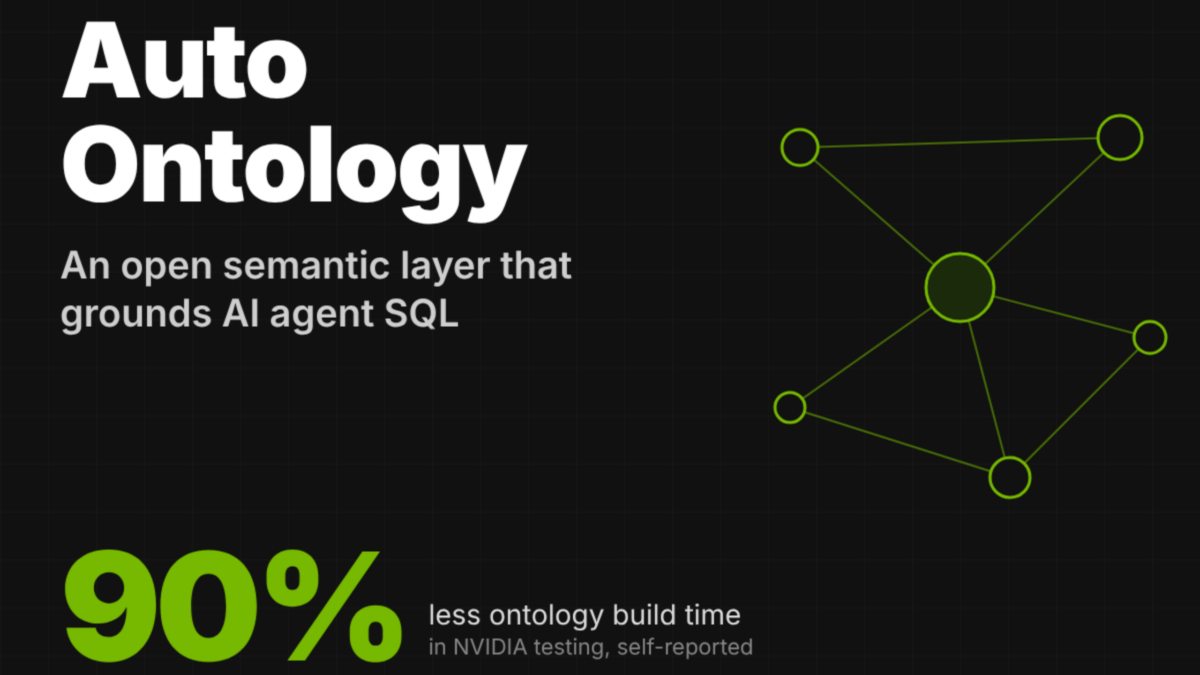
A NVIDIA lançou o Auto Ontology, um framework open source de camada semântica que promete tornar muito mais confiáveis as respostas geradas por agentes de inteligência artificial ao consultar bancos de dados corporativos por meio de SQL, ao amarrar cada pergunta a definições de negócios certificadas.
Como funciona o Auto Ontology
O Auto Ontology atua como uma camada intermediária entre o agente de IA e o data warehouse, construindo um contexto a partir de metadados empresariais. Em vez de o modelo de linguagem “chutar” consultas sobre esquemas brutos, ele passa a saber onde cada dado está, o que cada campo significa, quando deve ser usado e qual a origem da informação. O próprio repositório resume o problema que tenta resolver: “Um número rápido de receita é inútil se o número estiver errado”.
Na prática, a ferramenta gera uma ontologia inicial que depois é validada e refinada por especialistas de negócio. Essa camada se torna o vocabulário oficial que os agentes devem seguir para responder a perguntas em linguagem natural, reduzindo ambiguidades e divergências entre times sobre métricas e cálculos.
Arquitetura em quatro serviços
A solução é entregue como uma pilha modular com quatro serviços principais. Um frontend em Next.js 16 cuida da interface web e da autenticação na porta 3000. O backend, em FastAPI com LangChain, roda na porta 3001 e concentra o chat, a conversão de linguagem natural para SQL (NL-to-SQL) e as APIs de catálogo. Um worker de ingestão escreve embeddings na porta 3002. O armazenamento do catálogo, da ontologia e dos vetores fica em um banco Postgres com a extensão pgvector.
O sistema suporta múltiplas fontes de dados, incluindo Databricks, Postgres, Snowflake e DuckDB, o que facilita a adoção em ambientes de dados heterogêneos. Os modelos de linguagem são configurados por variáveis de ambiente que definem endpoint, chave e modelo, com suporte a qualquer endpoint compatível com a API da OpenAI. Há papéis separados para tarefas de raciocínio, não raciocínio, geração de embeddings e reranking.
Ferramentas para agentes e foco na camada semântica
O Auto Ontology expõe um servidor MCP (Model Context Protocol) com nove ferramentas de leitura. A principal delas, ask_question, devolve em campos separados a resposta para o usuário, o SQL gerado e as linhas do banco, com limite de 100 registros por consulta. Já a ferramenta check_readiness verifica se a camada semântica está compilada e se a conexão com o banco está ativa.
A documentação é explícita ao dizer: “Não há ferramenta para navegação de esquemas brutos porque queremos que agentes acessem dados pela camada semântica”. A ideia é forçar que todo acesso estruturado passe pelo vocabulário de negócio, evitando que modelos de IA se prendam a nomes de tabelas e colunas pouco intuitivos ou desatualizados.
A autenticação é feita via OAuth, e cada chamada carrega as permissões do usuário logado, permitindo controle fino sobre quem pode consultar o quê dentro da organização.
O que o Auto Ontology muda para empresas de dados?
Para empresas que já usam agentes de IA em data warehouses, o impacto direto é na confiabilidade. Em vez de uma IA que responde rápido, mas por vezes erra colunas, filtros e métricas, a camada semântica passa a orientar a construção do SQL com base em definições certificadas de negócio. O alvo são justamente cenários em que, por pressão de tempo, analistas e executivos aceitam respostas automatizadas sem conseguir auditar a lógica por trás.
Setores como finanças, saúde, varejo e tecnologia da informação, que dependem de dados sensíveis e decisões rápidas, tendem a se beneficiar de consultas complexas automatizadas com mais segurança. Times de BI e analytics, por sua vez, ganham uma forma estruturada de codificar e governar métricas, ainda que precisem se adaptar a manter essa ontologia viva e atualizada.
Ao proibir a navegação por esquemas brutos e exigir a camada semântica como porta de entrada, o Auto Ontology também empurra as organizações para um modelo de governança mais disciplinado, em que a linguagem de negócio é a referência — não apenas a estrutura física do banco.
Entenda o contexto
O lançamento chega em um momento em que agentes de IA são cada vez mais usados para responder perguntas sobre dados internos, mas ainda tropeçam em detalhes cruciais de contexto. Em muitos casos, modelos produzem SQL sintaticamente correto, porém conceitualmente equivocado, o que gera dashboards ou números de receita inconsistentes entre áreas.
Ao concentrar metadados, definições e regras de uso em uma ontologia versionada, a proposta da NVIDIA é reduzir esse tipo de descompasso e aproximar os agentes da forma como o negócio realmente mede e interpreta seus indicadores.
Como é feita a avaliação do Auto Ontology?
A NVIDIA disponibiliza junto com o framework um harness de avaliação chamado auto-ontology-eval, voltado a comparar de forma objetiva agentes que usam apenas o esquema bruto com aqueles ancorados na ontologia. O pacote roda dois “braços” em um ambiente de testes chamado NeMo Gym: um agente controle, guiado apenas pelo esquema, e outro que utiliza a camada semântica.
O critério de desempenho descrito na ferramenta é direto: “O scoring é uma correspondência determinística de execução, sem juiz LLM”. Ou seja, o que conta é se o SQL gerado roda corretamente e retorna o resultado esperado, sem depender da opinião de outro modelo de linguagem.
O auto-ontology-eval inclui vários conjuntos de dados públicos para teste: o BIRD Dev, com 1.534 perguntas distribuídas em 11 bancos; o Mini-Dev, com 500 perguntas; o FDABench-Lite, com 169 perguntas; e uma amostra padrão de 100 perguntas do BEAVER. O repositório observa que alguns recursos avançados, como exemplos few-shot e “value anchors”, são aplicados apenas ao braço com ontologia, o que significa que a diferença medida também captura esses elementos.
Implantação e comunidade técnica
O Auto Ontology é distribuído sob licença Apache 2.0 e pode ser instalado localmente com Docker Compose, após o preenchimento do arquivo de configuração .env. Para ambientes corporativos que usam Kubernetes, há um Helm chart e um guia detalhado em DEPLOYMENT.md. O backend também está disponível como container no catálogo NGC da NVIDIA, e o uso dos modelos padrão exige uma chave de API obtida na plataforma de desenvolvedores da empresa.
O projeto está hospedado em um repositório público no GitHub e dialoga com uma comunidade já ampla em torno de IA e machine learning — só uma das comunidades ligadas à divulgação soma mais de 150 mil membros em um fórum técnico. Na divulgação, Asif Razzaq, CEO da Marktechpost AI Media Inc., destaca que a ferramenta atende à demanda crescente por soluções que conciliem velocidade de análise com exatidão dos resultados em ambientes corporativos.