NVIDIA lança Nemotron 3.5 Super VL com 120B parâmetros para IA
NVIDIA apresenta o Nemotron 3.5 Super VL, modelo multimodal aberto de 120 bilhões de parâmetros para agentes de IA, e anuncia os modelos de borda Bolt 74B-A9B e Bolt E4B.
Inteligência Artificial
NVIDIA revela novo modelo multimodal com capacidade avançada para agentes de IA e apresenta atualizações em seus modelos de borda.
Leia também: SpaceXAI lança Grok Voice 3.0, líder em índice de fala
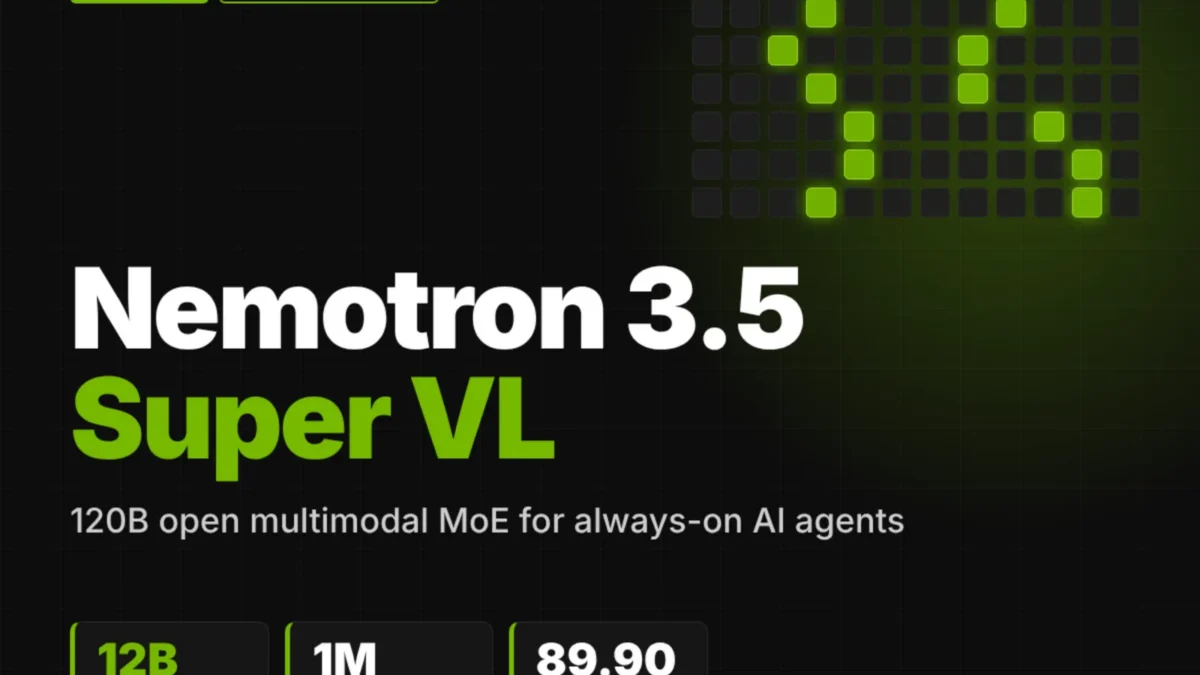
A NVIDIA lançou o Nemotron 3.5 Super VL, um modelo multimodal aberto de 120 bilhões de parâmetros projetado para agentes de IA empresariais sempre ativos, capaz de unificar em uma única arquitetura o processamento de texto, imagens, documentos e vídeos curtos, com foco em alta velocidade, eficiência e personalização.
Nemotron NVIDIA mira agentes empresariais multimodais
Pensado para substituir o uso combinado de modelos separados de texto e visão, o Nemotron 3.5 Super VL segue a arquitetura mixture-of-experts (MoE), ativando 12 bilhões de parâmetros por token. O modelo lê texto, interpreta imagens, páginas de documentos e clipes de vídeo em MP4 de até 2 minutos, além de raciocinar, chamar ferramentas externas e escrever código dentro do mesmo sistema.
O backbone intercala camadas Mamba-2, MoE com 512 especialistas roteados e atenção, enquanto um codificador de visão C-RADIO e um conector alimentam os frames visuais no núcleo de linguagem. Na prática, isso permite que um agente empresarial analise relatórios em PDF, planilhas convertidas em imagem e vídeos de operação industrial em uma mesma conversa, reduzindo a complexidade de integração para equipes de TI.
Segundo a equipe de pesquisa da empresa, o Super VL foi destilado a partir do Nemotron 3 Ultra e treinado com cerca de 26 trilhões de tokens. O pós-treinamento usou aproximadamente 3,8 milhões de amostras, combinadas com aprendizado por reforço em dezenas de ambientes, além de um pré-treinamento contínuo que adicionou 10 bilhões de tokens de idiomas do grupo Indic para ampliar a cobertura linguística.
Desempenho: mais rápido e menor que o Nemotron 3 Ultra
Nas avaliações internas em cenários agentivos, o Nemotron 3.5 Super VL supera o Nemotron 3 Ultra, mesmo sendo consideravelmente menor em número total de parâmetros. “Super VL beats Nemotron 3 Ultra with 63,44% on Hermes Bench versus 56,33%”, afirma a equipe da NVIDIA, destacando que o Ultra carrega cerca de 4,6 vezes mais parâmetros.
Em testes com o ecossistema LangChain, focados em uso com agentes e ferramentas, o Super VL atinge 87,05%, ante 84,3% do Nemotron 3 Ultra. Os números são todos reportados pela empresa, que posiciona o novo modelo como sucessor mais eficiente da família Nemotron AI para uso em aplicações complexas.
O ganho mais visível aparece na velocidade. “NVIDIA reports over 600 output tokens per second on Artificial Analysis agentic tasks”, diz a equipe, em referência a testes via endpoint de produção. Em gráficos internos, o Super VL aparece até cinco vezes mais rápido que o modelo concorrente Inkling Small em cenários similares.
Para operação em larga escala, as chamadas receitas Dynamo adicionam roteamento de cache KV-aware, técnica que otimiza o reaproveitamento de contexto entre usuários. Em um cenário com 16 GPUs B200 e geração de 50 tokens por segundo por usuário, a companhia reporta ser possível atender oito vezes mais clientes simultâneos, com redução de 85% na latência do primeiro token.
Entenda o contexto
O Nemotron 3.5 Super VL chega em um momento em que empresas disputam espaço com modelos abertos e fechados para agentes de IA cada vez mais complexos. Até aqui, muitas soluções combinavam um modelo de linguagem para texto, outro especializado em visão e, em alguns casos, um terceiro para vídeo — o que elevava custo, latência e esforço de engenharia.
Com o novo modelo, a NVIDIA tenta consolidar tudo em um único checkpoint aberto, licenciado para uso amplo, com foco especial em agentes corporativos que precisam operar 24 horas por dia, conectados a ferramentas internas, bancos de dados e fluxos de trabalho críticos. A empresa também publica conjuntos de dados, receitas de treinamento e ambientes de aprendizado por reforço no NeMo Gym, sinalizando uma estratégia de ecossistema para acelerar a adoção.
Nemotron 3 Ultra segue como referência de comparação
O Nemotron 3 Ultra, que serviu de base para destilação do Super VL, permanece como referência de comparação em termos de capacidade bruta, por ter aproximadamente 4,6 vezes mais parâmetros totais. Na prática, porém, os resultados divulgados indicam que a combinação de arquitetura MoE, otimizações de treino e ajustes de pós-treinamento permitem ao novo modelo entregar melhor desempenho em tarefas agentivas com custo computacional menor.
Para desenvolvedores que já trabalham com a linha Nemotron Ultra, a mudança mais direta é a possibilidade de migrar para um único modelo multimodal, em vez de orquestrar diferentes componentes para cada tipo de entrada. Isso simplifica o desenho de agentes complexos, como assistentes de suporte corporativo que recebem anexos, vídeos de tela, fotos de equipamentos e comandos em linguagem natural.
Onde o Nemotron 3.5 Super VL está disponível?
O Nemotron 3.5 Super VL já está disponível em plataformas de modelos abertos como Hugging Face, OpenRouter e ModelScope, além de ser oferecido como serviço na forma de NVIDIA NIM, o que facilita a integração em ambientes corporativos e aplicações em nuvem.
O modelo é suportado por runtimes de alto desempenho como vLLM, SGLang e TensorRT-LLM, com otimizações direcionadas a GPUs das arquiteturas Blackwell e Hopper. Para quem prefere rodar localmente, há caminhos de implementação via projetos como llama.cpp e Unsloth, o que abre espaço para uso em laboratórios de pesquisa, startups e equipes de inovação com infraestrutura própria.
Na camada de personalização, o ecossistema NeMo oferece o AutoModel, que permite fine-tuning supervisionado e via LoRA (técnica que ajusta o modelo com eficiência de memória), e o NeMo RL, focado em aprendizado por reforço para alinhar o comportamento do agente a necessidades específicas de cada negócio.
Modelos de borda: Bolt 74B-A9B e Bolt E4B
Junto com o Super VL, a NVIDIA apresentou dois modelos de borda da linha Bolt, voltados para agentes locais e assistentes de voz, com foco em rodar em hardware mais limitado sem depender sempre da nuvem.
O Nemotron 3.5 Bolt 74B-A9B é descrito como uma versão destilada do Super VL, com quantização nativa em 2 bits, o que permite encaixá-lo em 24GB de memória — faixa compatível com placas RTX de topo e sistemas DGX Spark. Segundo a equipe, “Nemotron 3.5 Bolt 74B-A9B ranks #1 among open models in its class on PinchBench”, aparecendo ainda em segundo lugar no benchmark BrowseComp entre modelos abertos.
O Bolt 74B-A9B está disponível em repositórios de modelos como Hugging Face, com suporte a runtimes populares no universo de uso local, como llama.cpp, Ollama, LM Studio, Unsloth e vLLM. O objetivo é permitir que empresas montem agentes privados, que rodam dentro do próprio data center ou até em estações de trabalho avançadas, reduzindo preocupações com latência e privacidade de dados.
Já o Bolt E4B, com cerca de 4GB de footprint, tem lançamento previsto para 23 de outubro e mira diretamente assistentes de voz e agentes embarcados em dispositivos com GeForce RTX, placas e módulos Jetson e sistemas RTX ou DGX Spark. A proposta é levar parte das capacidades multimodais e agentivas para o mundo dos dispositivos IoT, robótica leve e interfaces de voz em larga escala.
Impacto para empresas e desenvolvedores
Na avaliação de especialistas em tecnologia, o pacote Nemotron AI — com o Super VL no centro e os modelos Bolt na borda — tende a acelerar a adoção de agentes de IA multimodais em setores como atendimento ao cliente, análise de documentos, automação industrial, mídia digital e ferramentas internas para equipes de TI e negócios.
A possibilidade de usar um modelo aberto, com suporte a múltiplas plataformas e runtimes, interessa especialmente a empresas que querem evitar dependência total de modelos fechados na nuvem. Por outro lado, provedores de soluções menos eficientes ou focadas apenas em texto podem ver pressão competitiva adicional, à medida que aplicações multimodais se tornarem padrão.
Para a comunidade de IA, o lançamento amplia o acesso a modelos de alto desempenho com pesos abertos, além de dados e receitas de treinamento, o que deve impulsionar novas pesquisas em agentes, alinhamento via reforço e otimizações de inferência. Em declarações públicas, o CEO da Marktechpost AI Media Inc., Asif Razzaq, tem destacado a importância de iniciativas desse tipo para “o avanço da inteligência artificial multimodal e o desenvolvimento de agentes inteligentes mais eficientes e acessíveis”.
Nas próximas semanas, a expectativa é que laboratórios de pesquisa, startups e grandes empresas comecem a reportar resultados de testes e pilotos com o Nemotron 3.5 Super VL em produção, enquanto o lançamento do Bolt E4B consolida a estratégia de levar agentes multimodais também para dispositivos embarcados e interfaces de voz no dia a dia.
Fonte: matéria original