OpenAI reduz 80% da latência de push em Git com Pando em Rust
Novo backend Git em Rust passa a servir o monorepo da OpenAI, lida com quase 1 petabyte de dados por dia e reduz em cerca de 80% a latência mediana de push, destravando o desenvolvimento paralelo.
Tecnologia
OpenAI implementa backend em Rust que melhora significativamente a eficiência do Git no gerenciamento de grandes volumes de dados.
Leia também: Bug em modelo UMT5 faz Transformers mudar estratégia de testes
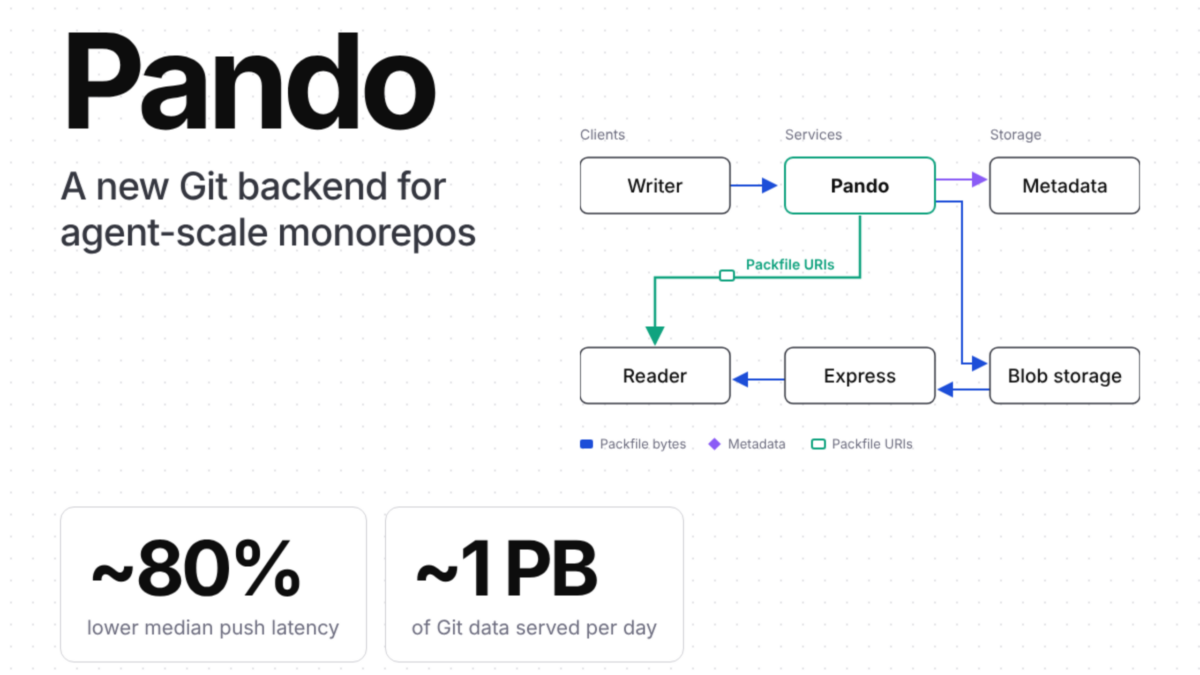
A OpenAI colocou em produção o Pando, um backend compatível com Git que assume o comando do monorepo interno da empresa, reduz a latência mediana de push em cerca de 80% e mantém a infraestrutura de versionamento de código estável mesmo com quase 1 petabyte de dados Git trafegando por dia.
Backend em Rust troca o servidor, não o Git do desenvolvedor
Na prática, nada muda para quem desenvolve: o cliente Git e o protocolo seguem os mesmos, com engenheiros e agentes Codex rodando git push e git fetch como sempre. A mudança está do lado do servidor, onde o Pando passou a escalar operações concorrentes de push e fetch no gigantesco monorepo da OpenAI.
“O Pando foi escrito em Rust e entrou em produção em 10 semanas”, informou a equipe de engenharia da OpenAI. O desenho central ficou a cargo de um engenheiro principal, apoiado por equipes de agentes Codex. Desde então, todo o tráfego de desenvolvimento interno passa pelo novo backend.
Com o crescimento acelerado do repositório e da quantidade de contribuições, o modelo tradicional de servidor Git virou gargalo. Segundo a própria OpenAI, “a latência mediana de push caiu quase 80%” após a adoção do Pando, aliviando um ponto crítico para a produtividade dos times que trabalham em paralelo no mesmo código.
Explosão de commits derrubou a confiabilidade
O monorepo da OpenAI reúne milhões de branches e operações intensas de integração contínua. A combinação de engenheiros humanos e agentes automáticos multiplicou o ritmo de trabalho. “Commits no branch master subiram 1.378% no terceiro trimestre de 2026 em relação ao primeiro trimestre de 2024”, descreveu a equipe. A estimativa interna aponta para um aumento de 2.442% até o quarto trimestre de 2026.
Cada novo push aciona diversas pipelines de CI, que por sua vez disparam vários fetches. No fim de 2025, esse volume começou a estressar o servidor Git tradicional. Fetches e pushes ficaram lentos, fusões falhavam com mais frequência e, em alguns momentos, “a confiabilidade caiu abaixo de 90% em alguns momentos devido a gargalos no servidor Git tradicional”, reconheceu a OpenAI.
A análise interna concluiu que o problema não estava no Git em si, mas na forma como o servidor tentava manter o repositório consistente e como produzia pacotes para cada cliente.
Entenda o contexto
Monorepos gigantes vêm se tornando padrão em grandes empresas de tecnologia, concentrando dezenas ou centenas de projetos num único repositório. O modelo facilita o compartilhamento de código e a coordenação entre equipes, mas pressiona o sistema de controle de versão, especialmente quando milhares de desenvolvedores e agentes automatizados fazem commits e builds concorrentes.
No limite, o servidor Git clássico passa a ordenar e empacotar tantas atualizações ao mesmo tempo que pushes e fetches ficam encadeados e lentos, o que gera fila, falhas e perda de produtividade.
Como o Pando funciona para escalar um monorepo massivo
O Pando rompeu duas suposições comuns em servidores Git tradicionais para lidar com esse cenário: a exigência de consistência global do repositório e a criação de um pacote único por cliente a cada operação.
No modelo anterior, o servidor ordenava toda atualização de referência (ref) em nível de repositório, o que fazia pushes sem relação entre si esperarem na fila. O Pando passa a usar consistência causal: cada branch é serializado de forma independente, e os clientes só entram em conflito ao tentar atualizar a mesma ref. A consequência é que um leitor que olha vários branches ao mesmo tempo pode vê-los em momentos ligeiramente diferentes, mas a maioria das operações ganha em velocidade.
Em vez de montar um packfile novo para cada fetch, o Pando armazena cada pacote enviado em um push como um blob imutável. Cada versão de ref vai para um sistema de metadados escalável, que registra de quais pacotes o cliente precisa. Assim, um push exige apenas um número constante de leituras e escritas de metadados; um fetch, por sua vez, precisa de uma quantidade de leituras que cresce de forma logarítmica conforme a diferença entre a versão local e a do servidor.
Num monorepo com milhões de branches, anunciar todas as refs em um fetch pode passar facilmente de 100 MiB. Para evitar esse custo, o Pando anuncia apenas o branch principal, o trunk, como base para novos branches de funcionalidade. Qualquer leitor que tenha o histórico do trunk consegue buscar um branch inteiro a partir de um único pack armazenado. No cenário atual da OpenAI, o tamanho mediano desses pacotes fica abaixo de 20 KiB.
Cache regional Express e compactação em níveis
Para distribuir os pacotes com eficiência global, o Pando usa o recurso packfile-uri do protocolo Git. Em vez de enviar o pack diretamente, o servidor devolve um link de download, acompanhado de um pack vazio embutido. Um serviço de entrega batizado de Express faz o cache regional desses pacotes, com hashing consistente para distribuição e taxa de acerto acima de 99%.
Cada push gera inicialmente um pacote de nível L0. Processos em background agrupam esses packs em conjuntos cada vez maiores, formando níveis sucessivos até L4, em uma lógica parecida com a compactação de árvores LSM. Essa organização atua como uma espécie de skip list para pacotes, permitindo selecionar rapidamente o conjunto mínimo necessário para atualizar o cliente.
O resultado desse desenho é um backend capaz de sustentar quase 1 petabyte de dados Git servidos por dia, com alta taxa de cache e latências mais previsíveis mesmo quando centenas ou milhares de operações concorrentes acontecem sobre o mesmo monorepo.
Teste com mil escritores e suíte de conformidade
Antes de consolidar a arquitetura, a OpenAI rodou simulações com mil escritores simultâneos para comparar modelos alternativos de commit, incluindo desenhos com commit em três fases e log de escrita antecipada. A empresa classifica esses modelos mais como ferramentas didáticas do que benchmarks, mas eles ajudaram a validar as escolhas de consistência e serialização por branch.
Para garantir que o novo backend continuasse fiel ao comportamento esperado do Git, a equipe montou uma suíte própria de conformidade, alimentada por agentes que exploram cenários e especificações formais. Segundo a OpenAI, agentes baseados no modelo GPT-6 Astra escreveram especificações em linguagens como Lean e TLA+ para encontrar bugs de forma sistemática.
Implantação gradual, cliente customizado e impacto para a comunidade
O Pando foi colocado em produção de forma conservadora: primeiro como um proxy de leitura e escrita à frente do servidor Git original. Nessa fase, o tráfego passava pelo novo backend sem tirar o sistema antigo do ar, o que permitiu medir comportamento e corrigir falhas sem downtime.
Hoje, a OpenAI já distribui uma versão customizada do cliente Git para as máquinas de desenvolvedores internos e para o aplicativo desktop do ChatGPT. Esse cliente traz suporte a downloads concorrentes de pacotes, retomada de downloads interrompidos e rastreamento específico para packfile-uri, além de melhorias como indexação paralela de packs e o uso de “explicit haves” para otimizar a negociação de objetos com o servidor.
Várias dessas correções já foram enviadas para o projeto Git principal; outras seguem reunidas em um repositório público de patches mantido pela OpenAI. A documentação técnica sobre o Pando e os detalhes de implementação do backend e do cliente também estão disponíveis em materiais públicos da empresa.
Em nota, a OpenAI resumiu o efeito da nova infraestrutura: “A latência mediana de push caiu quase 80%”, com manutenção de alta confiabilidade mesmo sob o novo patamar de commits e dados trafegados.
As reações internas apontam que o Pando virou peça central da produtividade dos times de engenharia, ao destravar o fluxo de desenvolvimento paralelo em um monorepo de escala rara na indústria. A expectativa na empresa é seguir refinando o cliente Git, mantendo o serviço de cache Express e, ao mesmo tempo, influenciar o ecossistema mais amplo de Git ao liberar correções e conceitos que podem ser aproveitados por outras organizações com repositórios gigantescos.