NVIDIA e IIT Madras lançam megacorpus em 22 línguas indianas
NVIDIA, IIT Madras e AI4Bharat anunciam o Nemotron-pretraining-Indic-v1, corpus de 2,8 trilhões de tokens em 22 línguas indianas e pipeline aberto para gerar dados sintéticos.
Tecnologia
Nova iniciativa reúne enorme base de dados multilíngue para avançar pesquisas em inteligência artificial na Índia.
Leia também: NVIDIA lança RTX Spark em 16/10 e revoluciona PCs com IA local
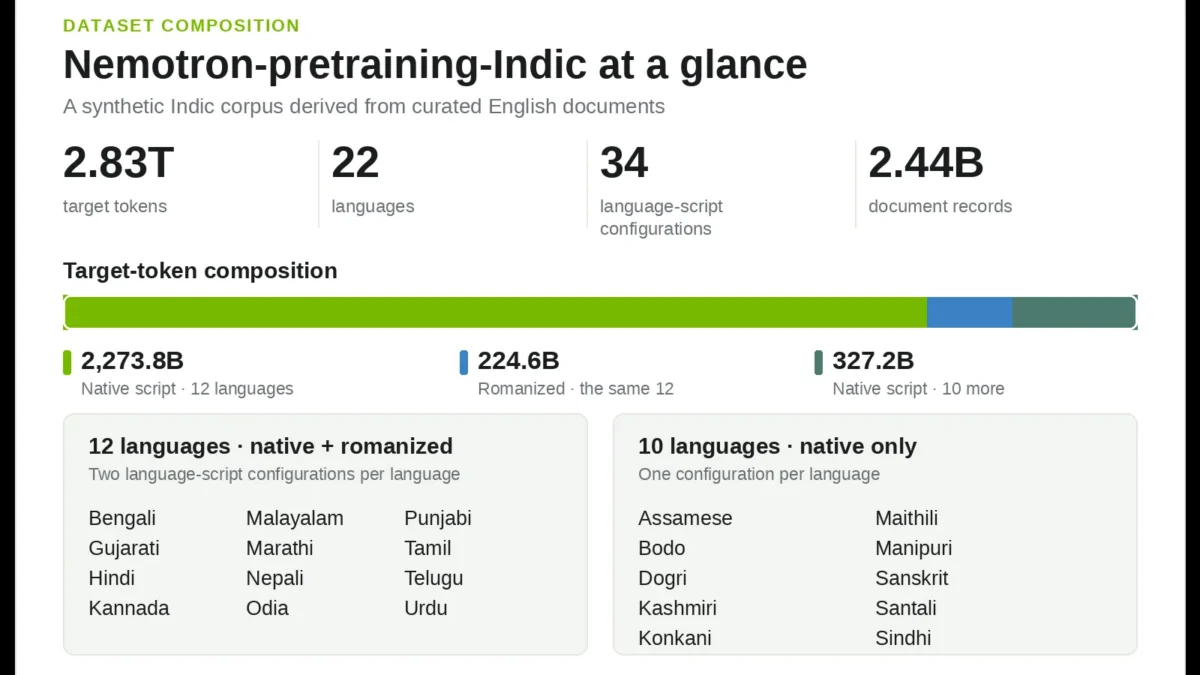
A NVIDIA, em parceria com o IIT Madras e o laboratório AI4Bharat, anunciou o Nemotron-pretraining-Indic-v1, um megacorpus de cerca de 2,8 trilhões de tokens em 22 línguas indianas, acompanhado de um pipeline aberto para geração de dados sintéticos que promete mudar o patamar da inteligência artificial nos idiomas do país.
Corpus mira 97% da população da Índia
O Nemotron-pretraining-Indic-v1 reúne dados em todas as 22 línguas listadas na Constituição indiana, faladas por cerca de 97% da população — algo em torno de 1,2 bilhão de pessoas. O material inclui 2.601 bilhões de tokens em escrita nativa e outros 224,6 bilhões em texto romanizado, o que resulta em 34 combinações diferentes de idioma e sistema de escrita.
A iniciativa nasce para atacar um gargalo histórico: a falta de dados em línguas indianas para treinar modelos avançados de linguagem. “O problema central é que não temos dados suficientes para línguas indianas”, resume Mitesh Khapra, chefe do AI4Bharat, que lidera o projeto pelo lado do IIT Madras. A parceria com a NVIDIA busca justamente destravar esse avanço com um volume inédito de informação e uma “receita” aberta para gerar ainda mais.
O corpus combina uma ampla gama de conteúdos originalmente em inglês — incluindo matemática, código e bases de perguntas e respostas — traduzidos para as línguas indianas. A ideia é permitir que modelos consigam explicar conceitos técnicos, resolver problemas e responder dúvidas nesses idiomas, algo crucial para aplicações em educação, serviços públicos, saúde e atendimento ao cidadão.
Pipeline aberto e acelerado por GPU
O lançamento não se limita aos dados. NVIDIA, IIT Madras e AI4Bharat estão liberando também o pipeline completo de geração, avaliação e reparo de dados sintéticos, acelerado por GPU. Toda a “receita” de produção é documentada: prompts usados, fluxo de trabalho com grandes modelos de linguagem e checagens de qualidade.
Na prática, desenvolvedores podem pegar esse pipeline, conectar às suas próprias fontes de texto em inglês e gerar grandes volumes de dados em línguas indianas, adaptando critérios de qualidade e passos de revisão conforme a necessidade. Cada registro do corpus fica vinculado ao documento-fonte original, e o texto sintético é checado para manter fidelidade às informações de origem.
Para doze línguas, o fluxo principal traduz documentos inteiros, avalia a qualidade da tradução e faz reparos direcionados quando necessário, em um processo de quatro etapas. Em seguida, uma parte das traduções aprovadas é convertida para escrita romanizada — sempre preservando a distinção entre tradução e mera troca de alfabeto. O pipeline também inclui mecanismos para manter intactos elementos complexos, como equações, tabelas e trechos de código.
As outras dez línguas seguem um fluxo próprio, com ajustes para documentos longos e estabilidade de script, mas sob o mesmo princípio: tradução em nível de documento, avaliação automatizada e retenção apenas de saídas que atingem um patamar mínimo de qualidade.
Entenda o contexto
A carência de dados em línguas indianas é apontada há anos como o principal fator que coloca o ecossistema de IA do país em desvantagem frente ao inglês. Sem volume e diversidade de textos, modelos de linguagem tendem a funcionar pior para consultas em idiomas locais, sobretudo em temas técnicos ou com forte carga cultural.
Projetos anteriores, como corpora abertos desenvolvidos pelo próprio AI4Bharat, ajudaram a abrir caminho para pesquisa em larga escala, mas ainda ficavam aquém do volume usado em grandes modelos internacionais. O Nemotron-pretraining-Indic-v1 chega como um salto de ordem de grandeza, tanto em quantidade quanto em qualidade do processo de geração.
Outro diferencial é a presença simultânea de variantes em escrita nativa e romanizada para doze línguas. Como muitos usuários digitam em alfabeto latino mesmo ao escrever em um idioma indiano, essa duplicidade permite treinar sistemas que entendam e respondam bem nos dois formatos, sem perder nuances culturais e linguísticas.
Impacto em modelos e aplicações práticas
O novo corpus já começou a ser usado em modelos comerciais. A NVIDIA aplicou cerca de 10 bilhões de tokens indicados do Nemotron-pretraining-Indic-v1 no pré-treinamento contínuo do modelo Nemotron 3.5 Super VL, em combinação com textos naturalmente produzidos em línguas indianas. Segundo a empresa, os resultados mostram ganhos consistentes em benchmarks de conhecimento e raciocínio nesses idiomas.
Na ponta, a expectativa é que ferramentas como assistentes virtuais, sistemas de busca, chatbots de serviços públicos, plataformas de ensino e aplicativos de saúde passem a oferecer respostas mais precisas e contextualizadas em línguas locais, reduzindo a dependência do inglês em serviços digitais básicos.
No ambiente de pesquisa e startups, o impacto tende a ser direto: grupos que antes não tinham estrutura para montar bases massivas agora podem partir de um corpus pronto e de um pipeline reproduzível, usando infraestrutura de GPU local ou em nuvem. Isso deve aumentar a competição, atrair novos projetos e acelerar a criação de modelos especializados para setores como agricultura, finanças populares e programas sociais.
Colaboração aberta e próximos passos
O trabalho reúne uma equipe ampla de pesquisadores do AI4Bharat e da NVIDIA, incluindo Mohammed Safi Ur Rahman Khan, Mitesh Khapra, Anoop Kunchukuttan, Niket Agarwal, Raviraj Joshi, Anusha Kamath, Markus Kliegl, Yev Meyer, Sriharsha Niverty, Kiran Praveen e Utkarsh Vaidya. A meta agora é que a comunidade acadêmica, empresas e órgãos públicos passem a usar o corpus e a adaptar o pipeline, produzindo novas versões para outros domínios e até para mais línguas.
A expectativa é que o Nemotron-pretraining-Indic-v1 funcione como base para futuras gerações de modelos da família Nemotron e para iniciativas abertas de modelos indicados. Também é provável que os dados e o processo influenciem políticas de inclusão digital e estratégias de governo eletrônico, à medida que órgãos públicos busquem oferecer serviços em idiomas nativos com qualidade semelhante à do inglês.
Ao combinar escala, abertura e foco em línguas historicamente subatendidas, o projeto se coloca como uma das principais apostas atuais para reduzir a distância entre o que a IA consegue fazer em inglês e o que passa a ser possível nos idiomas falados pela imensa maioria da população indiana.
Fonte: matéria original