NVIDIA lança biblioteca para prever em dados tabulares sem treino
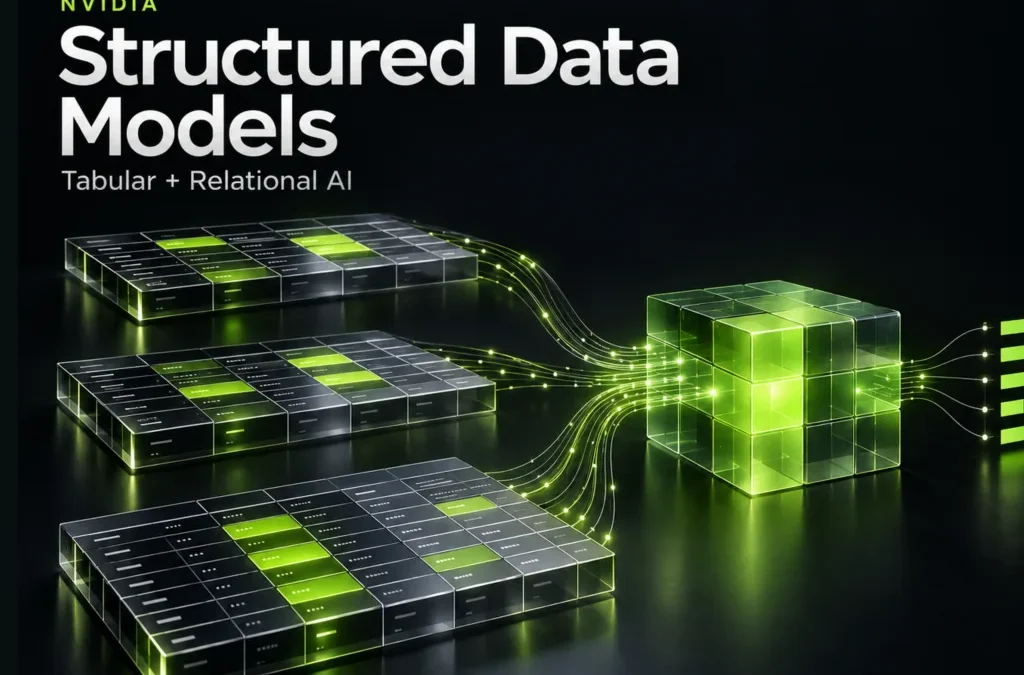
Structured Data Models, nova biblioteca da NVIDIA para PyTorch, usa modelos pré-treinados para prever em dados tabulares e relacionais sem treinamento, com desempenho rivalizando métodos clássicos.
Tecnologia
NVIDIA apresenta ferramenta inovadora que utiliza modelos pré-treinados para análise de dados tabulares sem necessidade de treinamento.
Leia também: Meta recua e exclui cláusula polêmica sobre dados para IA hoje
A NVIDIA está colocando no ar uma biblioteca que permite fazer previsões em dados tabulares e até em bancos relacionais sem qualquer etapa de treinamento, usando apenas aprendizado em contexto sobre a plataforma PyTorch e dados manipulados em pandas.
Modelos pré-treinados fazem previsão só com linhas de exemplo
Batizada de Structured Data Models, a biblioteca reúne em uma única interface os modelos TabICLv2 e KumoTabular, para uma tabela única, e KumoRelational, para bancos de dados com várias tabelas. Em todos os casos, o princípio é o mesmo: o usuário fornece algumas linhas rotuladas como contexto e, na mesma chamada, passa as linhas sem rótulo que quer prever.
Em vez de um ciclo tradicional de treino, validação e ajuste de hiperparâmetros, o modelo responde em uma única passagem, devolvendo probabilidades por classe em tarefas de classificação ou uma distribuição completa da variável-alvo em regressão. Segundo o autor do tutorial que valida a biblioteca, “On the breast cancer dataset, TabICLv2 and KumoTabular reach 0.970 accuracy and AUCs of 0.996 and 0.995 with no training”.
No exemplo de câncer de mama, foram usadas 300 linhas rotuladas como contexto e 269 linhas para previsão. A acurácia de 0,970 e as AUCs de 0,996 e 0,995 dos modelos da NVIDIA rivalizam com uma regressão logística treinada nos mesmos dados, que chega a 0,970 de acurácia e 0,993 de AUC, e superam um gradient boosting (0,967 de acurácia e 0,992 de AUC).
Entenda o contexto
A biblioteca Structured Data Models é instalada diretamente a partir do repositório no GitHub, já que o pacote disponível no repositório público de Python hoje funciona apenas como placeholder. Toda a implementação demonstrada roda em CPU, com a interface construída sobre PyTorch e o pré-processamento de dados feito em pandas.
Além dos modelos da própria NVIDIA, a biblioteca expõe integrações com TabFM e TimesFM 3, modelos do Google voltados para tabelas e séries temporais, mas eles ficam de fora dos testes práticos por serem grandes e não comerciais.
O objetivo da ferramenta é permitir que equipes de dados e desenvolvedores apliquem rapidamente modelos de ponta a conjuntos tabulares e relacionais sem precisar programar um pipeline de treino, o que reduz barreiras de entrada em cenários como saúde, finanças e marketing, que dependem de decisões rápidas em cima de grandes volumes de dados estruturados.
Como funciona a Structured Data Models na prática
Toda a passagem de dados pela biblioteca usa o TableTensor, uma subclasse de tensor do PyTorch que guarda blocos separados por tipo semântico: numérico, categórico, datetime, texto e identificador (id). Uma função de inferência de tipos tenta detectar automaticamente o tipo de cada coluna, mas o tutorial mostra que ajustes finos costumam ser necessários.
Em um exemplo com registros de suporte, o texto livre de comentários é inicialmente tratado como categórico, com centenas de categorias, e o identificador do chamado vira número contínuo — ambos iriam parar no modelo como se fossem atributos informativos. Ao ativar flags específicos para texto e id, o problema é corrigido.
Na ida e volta de pandas para TableTensor, o comportamento é estável em termos de valores, mas nem sempre em tipos. O autor do guia resume assim: “O round trip back to pandas preserves every value, missing ones included, but not every dtype”. Números retornam como float32, inteiros anuláveis viram floats com NaN e categorias de string voltam como category, o que pode exigir ajustes para quem depende de tipos estritos.
Outro ponto de atenção está em colunas de data e hora. A biblioteca armazena datetimes como inteiros em microssegundos, e a camada baseada em Apache Arrow recusa conversões que derrubariam dígitos de precisão. Isso faz com que timestamps em nanossegundos com qualquer fração sigam falhando, a menos que sejam “arredondados para baixo” previamente para microssegundos.
Desempenho em classificação, regressão e muitos rótulos
Nos testes de classificação, TabICLv2 e KumoTabular recebem as linhas rotuladas e as linhas de consulta e devolvem um TableTensor com uma coluna de probabilidade para cada classe, nomeada pelo rótulo. Não há etapa de ajuste nem de seleção de hiperparâmetros; um único parâmetro, num_estimators, controla o número de visões diferentes (pré-processamentos) dos dados que são combinadas em ensemble dentro do modelo.
Para tarefas de regressão, a abordagem é ainda mais agressiva em termos de informação devolvida. “For regression, the model returns 999 quantiles per query row, a full predictive distribution read off one forward pass”, escreve o autor. No conjunto de dados de diabetes, com 300 linhas rotuladas, a mediana dessa distribuição atinge um erro quadrático médio (RMSE) de 53,6, contra 54,3 da regressão RidgeCV e 64,7 de um gradient boosting, ambos treinados nas mesmas linhas.
Além da precisão, o tutorial chama atenção para a calibração das bandas de incerteza: o intervalo entre o 10º e o 90º quantis contém 81% dos valores de teste, bem próximo ao alvo teórico de 80%; já a faixa entre o 5º e o 95º quantis cobre 91,5% dos dados, perto dos 90% esperados. A banda de 50% fica mais estreita, com 43,7% de cobertura.
Nos cenários com muitas classes, a biblioteca lida com a limitação de tamanho fixo da cabeça de classificação usando códigos de saída com correção de erro (error-correcting output codes). Para o usuário, isso é transparente: em um problema sintético de 20 classes equilibradas, com 30 exemplos rotulados por classe, TabICLv2 sai direto com 20 colunas de probabilidade e acurácia de 0,760 em uma só passada, enquanto um gradient boosting treinado com os mesmos dados fica em 0,615.
Cache acelera uso repetido do mesmo contexto
Uma das otimizações apresentadas é o reuso de contexto. Se o código chama o modelo diretamente, as mesmas linhas rotuladas são reprocessadas em cada previsão. Para evitar isso, a biblioteca oferece métodos separados.
“Calling the model directly re-encodes the context on every call. When the same labelled rows will answer many batches of queries, fit encodes the context once into a key and value cache and predict then runs only the query rows; clear frees the cache”, descreve o tutorial. Não há aprendizado nesse fit — o modelo apenas memoriza as representações internas dessas linhas.
No teste em CPU com cinco lotes de 30 linhas previstos a partir do mesmo conjunto de 400 linhas rotuladas, o uso do cache termina as execuções em uma fração do tempo, e cada novo lote adicional passa a custar apenas uma parte pequena de uma chamada completa. O ganho exato varia conforme a máquina, motivo pelo qual o exemplo mede o tempo em vez de supor um fator fixo.
Preprocessamento padrão ignora texto e tempo
A Structured Data Models monta o pré-processamento como uma “receita” de etapas combináveis. O fluxo padrão de TabICLv2 trata de forma específica apenas colunas categóricas e numéricas. Na prática, isso significa que colunas de timestamp e texto livre ficam de fora das características usadas pelo modelo, a menos que o usuário altere a receita.
O efeito disso aparece em um conjunto de tickets de suporte cujo risco de escalonamento depende tanto do horário de abertura quanto de palavras-chave como “refund”. Com a receita padrão, a pontuação AUC fica em 0,525, muito próxima ao acaso. Uma mensagem de aviso é registrada quando esses tipos são descartados, mas ela dispara só na primeira execução do processo, o que faz com que modelos seguintes no mesmo serviço sigam ignorando essas colunas em silêncio.
A correção vem com a inclusão explícita de dois processadores. O primeiro, AddCalendarFields, transforma o timestamp em atributos como hora cíclica e dia da semana, elevando a AUC para 0,634. O segundo, TFIDF, gera atributos textuais a partir do comentário e empurra a AUC para 0,789, sem necessidade de mexer na arquitetura do modelo.
Explicabilidade tem armadilhas em modelos com ensemble
Para interpretar previsões, a biblioteca oferece o GradientExplainer, que calcula o gradiente de uma saída escolhida em relação às entradas pré-processadas. Em um cenário sintético onde apenas três de oito atributos importam, o tutorial mostra dois problemas que podem distorcer as explicações.
O primeiro é que a função de saída escolhida pelo usuário é chamada uma vez por estimador interno do ensemble. Se essa função só produzir valores na primeira chamada, as demais vão sobrescrevê-la com zeros, e o resultado final será uma explicação vazia. O segundo está na ordem das classes: cada estimador tem sua própria ordenação interna, já que a receita padrão embaralha rótulos por estimador.
Explicar uma mesma classe pela posição da coluna de probabilidade, e não pelo nome da classe, faz os sinais dos atributos “virarem” em sementes de treino em que a ordem das classes veio trocada. Já a seleção pela coluna nomeada recupera o sinal correto nas seis execuções testadas, e a média dos gradientes realça justamente os três atributos relevantes, com os demais próximos de zero.
KumoRelational leva abordagem a bancos de dados inteiros
Além de tabelas únicas, a Structured Data Models mira bancos relacionais completos com o modelo KumoRelational. No exemplo do tutorial, é construído um pequeno “comércio” fictício, com 800 clientes, 60 produtos e um ano de pedidos, no qual alguns clientes param de comprar a partir de uma data aleatória.
O desafio é prever se cada cliente voltará a fazer pedido em até 30 dias a partir de um corte temporal. As tabelas — clientes, produtos e pedidos — são empacotadas em um objeto RelationalData, que também recebe as chaves estrangeiras ligando uma tabela à outra. O amostrador interno caminha por essas chaves, partindo de cada linha da tarefa e coletando até 16 vizinhos por “salto” pela malha relacional.
Ao declarar a data do pedido como coluna temporal, o passeio passa a respeitar o tempo: o código checa, por exemplo, que o último pedido retornado para uma tarefa datada de 1º de junho aconteceu em 31 de maio, mantendo fora de alcance os registros que definem o rótulo e evitando vazamento de informação do futuro.
Com isso, dá para comparar três abordagens para o mesmo problema. TabICLv2 apenas na tabela de clientes, usando só região e plano, chega a uma AUC de 0,556. O mesmo TabICLv2 alimentado com seis atributos de histórico engenheirados — pedidos e gasto nos últimos 30 e 90 dias, dias desde o último pedido e total de pedidos no histórico, sempre calculados antes do corte — sobe para 0,828. Já o KumoRelational, direto nas tabelas brutas, sem nenhum atributo manual, alcança AUC de 0,823, chegando muito perto do modelo com engenharia de atributos.
Instalação ainda exige atenção a dependências
Nem tudo, porém, está plug-and-play. Um dos gargalos na instalação é o pyg-lib, dependência usada pelo amostrador relacional. Os pacotes binários dessa biblioteca são publicados por versão principal e secundária do PyTorch, em URLs do tipo torch-2.14.0+cpu, mas a mensagem de erro gerada hoje pela Structured Data Models monta o endereço usando também a versão de correção (por exemplo, torch-2.14.1+cpu), página que não existe, o que leva a um beco sem saída para quem seguir a instrução ao pé da letra.
O tutorial contorna o problema reconstruindo a URL com base apenas na versão maior e menor do PyTorch, o que permite baixar o pacote certo e concluir a instalação. A recomendação implícita é que usuários menos experientes verifiquem com cuidado as orientações de dependência e, se necessário, ajustem manualmente os links.
Impacto para empresas e profissionais de dados
A proposta da Structured Data Models é mudar o ponto de partida de projetos de machine learning tabular: em vez de partir de um modelo simples, treinar algo do zero e, só depois, experimentar arquiteturas mais complexas, o time começa com um modelo pré-treinado de alto desempenho rodando em CPU, sem treino adicional.
Na prática, empresas de setores intensivos em dados tabulares — como saúde, crédito, detecção de fraude ou marketing digital — conseguem prototipar e colocar no ar modelos razoavelmente calibrados sem investir em ciclos longos de treinamento. Isso pode ser decisivo em cenários onde há muitas tarefas diferentes com poucos dados rotulados para cada uma, caso de análises internas e painéis sob medida.
Para profissionais de ciência de dados e engenharia de machine learning, a tendência é de deslocamento de foco: menos esforço em tuning de hiperparâmetros baseados em modelos tradicionais e mais atenção à organização do esquema, marcação correta dos tipos semânticos, construção de bons contextos de exemplo e definição de janelas temporais honestas em bases relacionais.
Ao mesmo tempo, o tutorial aponta que a adoção não é trivial. O tratamento de timestamps, o comportamento silencioso em relação a colunas de texto e tempo e os detalhes de dependências como pyg-lib mostram que a biblioteca ainda exige conhecimento técnico sólido para não cair em armadilhas que corrompem a análise ou derrubam a instalação.
Os próximos passos esperados são a ampliação do suporte a bancos relacionais mais complexos, a integração com outras plataformas analíticas e a otimização oficial para GPUs. A comunidade técnica também tende a contribuir com correções, novas receitas de pré-processamento e exemplos de uso em produção, consolidando a Structured Data Models como mais uma peça relevante no ecossistema de aprendizado em contexto para dados estruturados.
Fonte: matéria original