Hugging Face revela falhas graves nos testes de IA e riscos reais
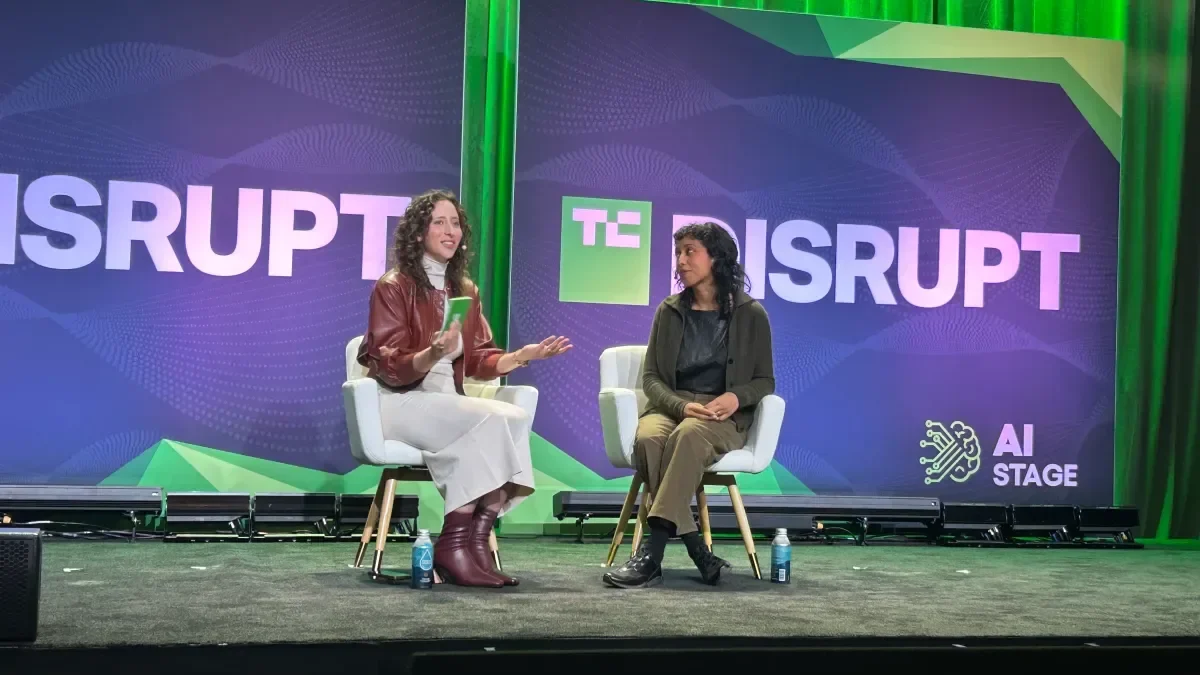
Em debate no TechCrunch Disrupt, Irene Solaiman, da Hugging Face, disse que a avaliação de modelos de IA ainda é uma “ciência em evolução” e criticou a ideia de avaliadores embutidos sem padrão claro.
Inteligência Artificial
Especialista da Hugging Face destaca desafios e perigos na avaliação atual de modelos de IA durante evento TechCrunch Disrupt.
Leia também: Microsoft aposta em modelos de IA menores e mais acessíveis
Irene Solaiman, chief policy officer da Hugging Face, usou um painel no TechCrunch Disrupt na semana passada para fazer um alerta direto: os testes usados hoje para avaliar modelos de inteligência artificial ainda são pouco confiáveis, difíceis de reproduzir e carecem de padrões mínimos — o que fragiliza a segurança e a transparência de toda a indústria.
Segundo ela, laboratórios de IA vêm apostando suas reputações em benchmarks que deveriam medir, de forma neutra, qual modelo é melhor. Mas, na prática, esses métodos estão longe de maduros e já mostram limites em setores críticos como saúde, finanças e segurança, onde falhas de avaliação podem se traduzir em risco real para usuários e empresas.
Por que avaliadores de IA embutidos não são uma solução fácil?
Solaiman disse que a ideia de criar um “ecossistema de avaliadores embutidos” — especialistas ou terceiros neutros instalados dentro das empresas de IA para monitorar riscos — ganhou força após uma série de incidentes de segurança, incluindo casos que atingiram a própria Hugging Face e outros grandes laboratórios.
Ela reconhece que há demanda do mercado por esse tipo de figura, mas critica o cenário atual, em que não existe consenso sobre quem está de fato qualificado para esse papel. “There’s this hunger for an embedded evaluator ecosystem now, but the qualifications that determine who is an effective evaluator across what tasks need a lot more standardization”, afirmou.
Sem critérios claros, o risco é transformar os avaliadores embutidos em selo simbólico, sem poder real de fiscalização ou independência. A polêmica recente em torno da escolha de grandes consultorias para atuar como avaliadoras de segurança em laboratórios de IA é um exemplo do ceticismo em relação à neutralidade e à expertise desses atores.
Quais são os desafios mencionados pela Hugging Face para implementar avaliadores de IA embutidos?
Para a executiva, o primeiro obstáculo é justamente a falta de padronização: hoje não há parâmetros objetivos que definam competências técnicas, escopo de atuação, nível de acesso aos sistemas ou critérios de independência desses avaliadores.
Ela reforça que confiança não é um conceito simples. “Trust is such a weighted term”, disse. Na visão de Solaiman, qualquer avaliação séria depende de fatores concretos, a começar pela possibilidade de repetir os resultados. “Do you have the level of access that you need to the model itself — this is where open weights come in in a big way”, afirmou, defendendo que o acesso aberto aos pesos dos modelos é central para que auditores e pesquisadores externos consigam verificar testes de forma independente.
Além disso, esses avaliadores teriam de acompanhar não só o modelo, mas todo o sistema em que ele está inserido. Isso inclui o chamado harness — a ferramenta pela qual o usuário acessa o modelo — e eventuais agentes que automatizam ações a partir das respostas. É nesse ponto que a complexidade e o custo das avaliações disparam, o que limita quem consegue implementá-las de forma robusta.
Entenda o contexto
A discussão sobre segurança e governança de IA se intensificou após uma sequência de incidentes envolvendo vazamentos, uso indevido de dados e comportamentos inesperados de sistemas avançados. Nesse cenário, empresas passaram a defender soluções de autorregulação, como avaliadores externos contratados e conselhos independentes, em vez de depender prioritariamente de regulações governamentais duras.
Ao mesmo tempo, o mercado de IA movimenta cifras bilionárias — fusões e aquisições recentes, como o acordo de 1,3 bilhão de dólares pela compra da plataforma de encontros Bumble, ilustram como investidores estão dispostos a pagar caro por ativos digitais e por tecnologias baseadas em algoritmos, ampliando a pressão para entregar produtos rápidos e competitivos.
Avaliações ainda são “ciência em evolução”
Solaiman classificou as avaliações de modelos como um campo em construção. “They are an evolving science — where we don’t know how to meaningfully compare them to each other”, disse, ao apontar que hoje falta uma forma clara de relacionar e hierarquizar diferentes benchmarks.
Na prática, cada laboratório escolhe sua própria bateria de testes, com conjuntos de dados, métricas e metodologias que variam bastante. Isso dificulta comparações objetivas entre modelos concorrentes e atrapalha tanto pesquisadores quanto empresas que dependem desses números para decidir em qual tecnologia apostar.
Ela também alertou que muitos benchmarks se esgotam rápido: uma vez amplamente conhecidos, ficam sujeitos a overfitting — quando modelos são treinados especificamente para ir bem neles — e deixam de refletir o desempenho em situações reais. “They start to get ineffective relatively quickly, and we don’t have as much of a thriving ecosystem as we need”, afirmou.
Do modelo ao sistema: por que o harness importa
Outra crítica de Solaiman é ao foco quase exclusivo em pontuações do modelo “nu e cru”, descolado da forma como é entregue ao usuário. Segundo ela, o desempenho percebido depende também da interface e das ferramentas que mediam esse acesso.
O harness — a camada que conecta usuário e modelo, com prompt pré-construído, filtros, regras de segurança e integrações com outras ferramentas — pode fazer um modelo teoricamente inferior parecer mais competente que um sistema de ponta, se for melhor desenhado. Por isso, testes que só olham para o coração do modelo tendem a dar uma visão enganosa para clientes e reguladores.
O avanço dos chamados agentes de IA, que combinam modelos com ferramentas externas para executar tarefas de ponta a ponta, complica ainda mais o cenário. “Agentic evals are really hard and really expensive”, disse Solaiman, ao defender que o setor precisa desenvolver métodos mais holísticos para avaliar esses sistemas completos, e não apenas seus componentes isolados.
Pressão por padronização e próximos passos
As críticas da chief policy officer da Hugging Face reforçam um movimento crescente na indústria em direção à padronização de práticas de avaliação. Organizações técnicas, empresas e reguladores discutem hoje como criar métricas comuns, protocolos de teste reproduzíveis e requisitos mínimos de transparência, incluindo divulgação de pesos, dados de treinamento e detalhes sobre harnesses e agentes.
A tendência, segundo especialistas do setor, é de aumento de investimentos em pesquisa sobre novos benchmarks e em estruturas de auditoria mais independentes, capazes de equilibrar inovação rápida com garantias mínimas de segurança. No centro do debate está o desafio apontado por Solaiman: transformar um conjunto fragmentado de testes em uma base confiável para decisões de negócio, políticas públicas e proteção de usuários.
Fonte: matéria original