Google e Meta lançam TorchTPU para acelerar PyTorch em Cloud TPU
Google e Meta lançam o TorchTPU, backend nativo open-source do PyTorch para TPUs na nuvem. Ferramenta substitui PyTorch/XLA e é recomendada para novos workloads.
Tecnologia
Nova ferramenta open-source melhora performance do PyTorch em TPUs na nuvem, facilitando workloads avançados.
Leia também: Falha em certificados da eMudhra expõe milhões a ataques digitais
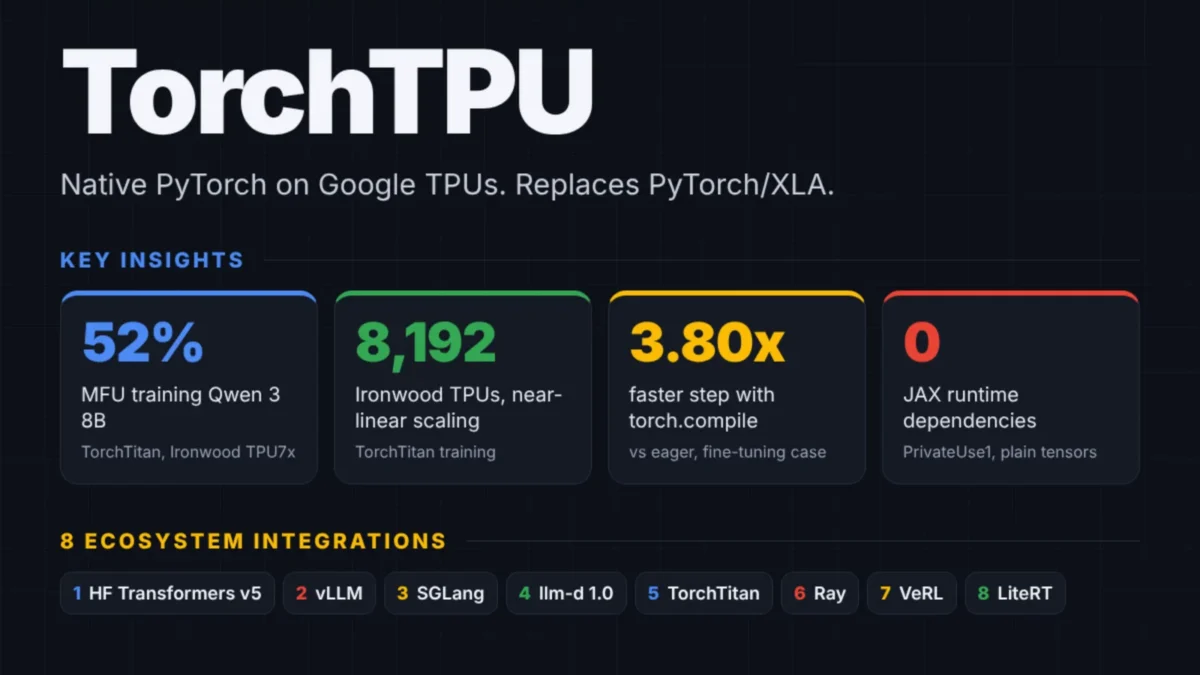
Google e Meta anunciaram nesta terça-feira (20), no PyTorch Conference 2026, o TorchTPU, um backend nativo open-source do PyTorch para Cloud TPUs que passa a ser a solução recomendada para todos os novos workloads e aposenta o uso do PyTorch/XLA nesse tipo de ambiente.
Com o TorchTPU, modelos escritos em PyTorch podem rodar diretamente em TPUs na Google Cloud Platform usando tensores comuns e a seleção do dispositivo padrão “tpu”, colocando os chips de Google TPU PyTorch no mesmo patamar de GPUs e CPUs dentro do ecossistema da biblioteca.
O que muda na prática para quem usa PyTorch em TPUs
O TorchTPU implementa um backend nativo que se conecta ao PyTorch pela interface PrivateUse1, permitindo que o desenvolvedor apenas aponte o código para torch.device("tpu") e passe a usar TPUs sem ajustar o modelo para APIs específicas. Segundo a equipe do Google, “TorchTPU replaces PyTorch/XLA and is recommended for all new workloads”.
Uma das principais diferenças em relação ao PyTorch/XLA é que o novo backend abandona o modelo de grafos lazy-tensor e as marcações manuais de regiões compiláveis. A equipe técnica destaca que “tensors are ordinary PyTorch tensors, with no subclasses or wrappers”, o que reduz a complexidade para quem já trabalha com PyTorch e quer migrar para TPUs.
O backend roda um processo por dispositivo e preserva comportamentos conhecidos da biblioteca, como views de tensores e mutações in-place. Além disso, o TorchTPU suporta tanto o padrão SPMD quanto execuções divergentes no modelo MPMD, ampliando o leque de estratégias de paralelização em cenários distribuídos.
Desempenho e modos de compilação
O TorchTPU oferece três modos eager de execução, incluindo um caminho otimizado de compilação via torch.compile(backend="tpu"). De acordo com o time do Google, “for peak speed, torch.compile(backend=”tpu”) captures the graph with TorchDynamo”, que então faz o lowering para StableHLO e OpenXLA, gerando código de máquina específico para TPU.
Os executáveis compilados são armazenados em cache entre processos, hosts e reinícios de job, o que reduz o tempo de inicialização em experimentos longos e em grandes clusters. Na prática, isso permite que pipelines de treinamento e inferência intensivos em computação aproveitem melhor a capacidade das Cloud TPUs sem exigir reconfigurações complexas a cada execução.
Outro ponto de destaque é o suporte a kernels customizados Pallas, que podem ser chamados como funções PyTorch padrão, além de kernels pré-construídos como Tokamax e Helion. Esses componentes permitem otimizar rotinas críticas de modelos avançados, mantendo a interface familiar da biblioteca.
Distribuição em larga escala e interconexão
Para treinamentos distribuídos, o TorchTPU usa o grupo de processos tpu_dist, com suporte às principais ferramentas do ecossistema: Distributed Data Parallel (DDP), Fully Sharded Data Parallel de nova geração (FSDP2) e DTensor. A arquitetura inclui uma malha aware da topologia do interconnect das TPUs, planejada para aproveitar a largura de banda entre nós físicos.
Essa combinação mira diretamente workloads de grande porte, como modelos de linguagem, visão computacional e sistemas multimodais, que exigem paralelismo em dezenas ou centenas de dispositivos. Ao reduzir o atrito entre o stack PyTorch e a infraestrutura de TPUs, o Google busca posicionar a Google Cloud Platform como destino natural para projetos de IA de alta escala.
Entenda o contexto
Até agora, a principal forma de usar TPUs com PyTorch era por meio do PyTorch/XLA, que registrava grafos lazy e pedia ao desenvolvedor que marcasse explicitamente regiões compiláveis. O modelo funcionava, mas era visto como mais complexo, especialmente na migração de código que já rodava em GPU.
Com o TorchTPU, Google e a equipe do PyTorch na Meta tentam aproximar a experiência de TPUs da experiência nativa de GPUs no PyTorch, diminuindo a curva de aprendizado. O pacote, open-source, está no GitHub com código, documentação e artigo técnico, em uma estratégia que reforça a aposta em soluções abertas para machine learning.
A versão recomendada hoje é a torch_tpu==0.2.0, que deve ser instalada em VMs com TPU. A orientação é fixar essa versão, alinhada ao índice de wheels CPU do PyTorch, para evitar conflitos com builds CUDA da biblioteca durante a instalação via pip.
Impacto para o mercado de IA e para a nuvem
O lançamento tende a mudar o equilíbrio no uso de aceleradores para quem trabalha com PyTorch. Ao simplificar o acesso a TPUs e prometer ganhos de desempenho com menor esforço de adaptação, o TorchTPU pode aumentar a adoção desses chips em empresas de tecnologia, laboratórios acadêmicos, startups de IA e provedores de serviços que já usam PyTorch como padrão.
Ao mesmo tempo, o movimento pressiona fornecedores de hardware concorrentes a oferecer integrações igualmente diretas com o ecossistema PyTorch, seja por backends nativos, seja por melhorias nas ferramentas existentes. Para o Google Cloud Platform, o efeito esperado é o fortalecimento da plataforma como ambiente de referência para workloads de IA pesados.
A comunidade de desenvolvedores deve acompanhar de perto a maturação do projeto, com a promessa de expansão da documentação, novos guias e suporte a mais kernels e estratégias de distribuição nos próximos meses.
Reação da comunidade e próximos passos
Nas apresentações do evento, as equipes de Google e PyTorch na Meta classificaram o TorchTPU como a nova base para projetos em TPUs dentro do ecossistema PyTorch, deixando claro que PyTorch/XLA tende a perder espaço à medida que o backend nativo evolui.
Fora do palco, vozes da comunidade de IA também destacam o potencial da mudança. Asif Razzaq, CEO da Marktechpost AI Media Inc., ressalta a importância de iniciativas que tornem o uso de aceleradores mais acessível e observa que a plataforma que dirige, focada em notícias técnicas de IA, já ultrapassa mais de 2 milhões de visualizações mensais, reflexo do interesse crescente por ferramentas desse tipo.
Os mantenedores do TorchTPU indicam como próximos passos a estabilização do pacote, a ampliação de exemplos práticos e tutoriais e a incorporação de novos kernels e estratégias de paralelismo. Documentação detalhada está disponível em torchtpu.readthedocs.io, enquanto código-fonte, paper e material adicional podem ser consultados no repositório oficial no GitHub.
Fonte: matéria original