Hugging Face lança Carbon-X, modelo aberto de DNA
Hugging Face apresenta Carbon-X, modelo aberto de DNA com 14,8 bilhões de parâmetros que integra genoma e texto, corta custo de análise em até 1.800 vezes e mira laboratórios e hospitais.
Tecnologia
Carbon-X une genoma e texto para revolucionar análises genéticas com eficiência e baixo custo.
Leia também: Economista diz que IA não gera lucro fora do setor de tecnologia
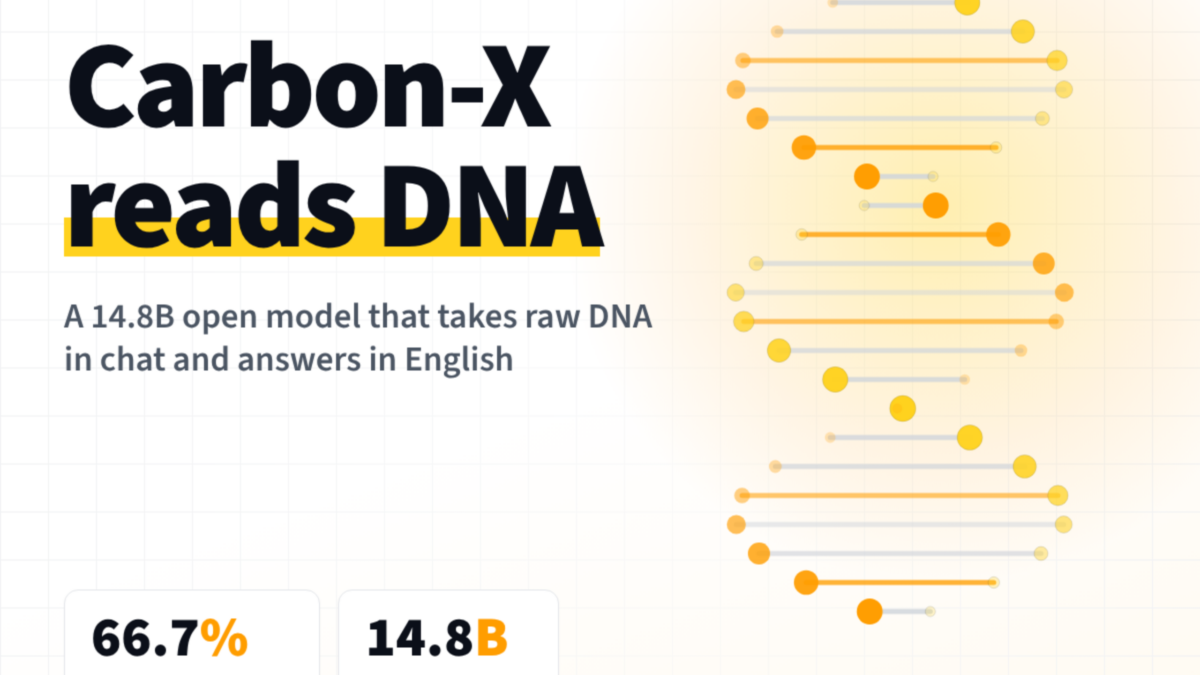
A Hugging Face lançou nesta semana o Carbon-X, um modelo aberto de linguagem de DNA com 14,8 bilhões de parâmetros que lê sequências genéticas em formato bruto e responde em inglês, com custo de inferência cerca de 1/1.800 menor que rivais de ponta. Desenvolvido em parceria com a Zhongguancun Academy e o TIGEM / Universidade de Nápoles Federico II, o sistema mira laboratórios, hospitais e centros de pesquisa que precisam analisar grandes volumes de dados genômicos mantendo as informações sensíveis dentro de casa.
Modelo integra DNA e texto em um só fluxo
O Carbon-X é um modelo do tipo decoder-only baseado na arquitetura Qwen3-14B e traz uma diferença importante em relação a trabalhos anteriores em genômica: DNA e texto compartilham o mesmo fluxo de tokens em um único decodificador, sem um codificador separado só para sequências biológicas.
O coração técnico da proposta é um tokenizador híbrido. Ele preserva o vocabulário BPE usado para texto e acrescenta 5.515 tokens específicos para DNA, incluindo 4.096 6-mers não sobrepostos, 1.364 tokens de cauda e 3 marcadores. Na prática, cada token de DNA representa 6 pares de bases, o que permite comprimir longas sequências em menos passos de inferência e reduzir o custo computacional.
Por baixo, o modelo usa uma pilha padrão Qwen3 com 40 camadas, tamanho oculto de 5.120 e atenção GQA com 8 cabeças KV. O treinamento foi feito em quatro estágios, com ajuste fino da taxa de aprendizado para que o modelo aprendesse bem o “idioma” do DNA sem desaprender inglês. Nos testes internos, o Carbon-X foi sempre executado com a opção de “thinking” desabilitada, configuração em que, segundo a equipe, o desempenho é melhor para esse tipo de tarefa.
Entenda o que o Carbon-X consegue fazer
O Carbon-X lê DNA diretamente em um chat e devolve respostas em linguagem natural. Entre as tarefas demonstradas estão previsão se uma mutação é benigna ou patogênica, identificação de regiões regulatórias, classificação de organismos e predição da próxima base em uma sequência.
Nos benchmarks reportados pela Hugging Face, o modelo “sits 27 points above Qwen3-14B and 0.8 points below GPT-6.1 Sol”, liderando em efeitos de variantes de codificação e predição da próxima base, embora modelos de fronteira ainda levem vantagem em variantes complexas e de base única. Ao mesmo tempo, o sistema preserva competências gerais de linguagem, com “79,3% prompt-level strict accuracy on IFEval”, o que abre espaço para usos multidisciplinares, que combinam explicações textuais com análise genômica.
Quanto custa usar o Carbon-X
Em termos de operação, a Hugging Face afirma que “prices Carbon-X at measured throughput on an H200 at $5 per hour”. Com essa referência, o custo de inferência por problema fica em torno de 1/1.800 do valor estimado para o GPT-6.1 Sol.
Um dos exemplos dados é a análise das 2,4 milhões de variantes ClinVar de significado clínico incerto, que poderia ser feita por cerca de US$ 300 usando o Carbon-X. “The same job costs $32,000 to $4 million on frontier models”, o que hoje torna esse tipo de varredura proibitiva em muitos ambientes de pesquisa e, sobretudo, em instituições de saúde com orçamento apertado.
O modelo pode ainda atuar como sub-agente em sistemas maiores. Em testes de integração, o índice de consultas de DNA do Kimi K3, por exemplo, subiu de 49,4% para 60,5% quando passou a consultar o Carbon-X como componente especializado.
Impacto para pesquisa e saúde
Ao oferecer um modelo de DNA aberto, com pesos completos liberados sob licença Apache 2.0, a Hugging Face e as instituições parceiras buscam democratizar o acesso a ferramentas de análise genômica avançada. A licença permissiva permite que laboratórios e hospitais rodem o Carbon-X em suas próprias GPUs, mantendo localmente dados altamente sensíveis, como sequências de pacientes e variantes raras, o que reduz riscos de privacidade e problemas regulatórios.
Áreas como pesquisa biomédica, diagnóstico molecular, farmacogenômica e desenvolvimento de terapias personalizadas tendem a ser as primeiras beneficiadas. Com custo mais baixo e maior eficiência, torna-se viável rodar painéis muito maiores de variantes, testar hipóteses em escala e reprocessar bancos inteiros de dados à medida que novos conhecimentos surgem, algo que hoje muitas vezes é limitado pelo preço de modelos proprietários.
Na outra ponta, provedores de soluções fechadas de IA para genômica devem sentir pressão competitiva. Além do custo agressivo, a combinação de desempenho competitivo com abertura de código e pesos deve incentivar universidades, centros de pesquisa e empresas de biotecnologia a colaborar em cima do Carbon-X, ajustando o modelo a nichos específicos, diferentes populações e novos tipos de dados.
A expectativa é que, a partir do lançamento, o modelo passe a ser adotado em projetos acadêmicos e pilotos clínicos, enquanto a comunidade testa limites, corrige vieses e explora novas aplicações. Repositórios oficiais da Hugging Face já disponibilizam documentação, pesos em diferentes formatos e código para facilitar essa integração.