Hermit lança framework aberto para adaptar agentes de IA
Infini-AI-Lab lança o Hermit, framework open-source que treina adaptadores externos para agentes de IA sem alterar modelo base nem harness, com foco em segurança e modularidade.
Tecnologia
Hermit facilita a personalização de agentes de IA com segurança e modularidade, sem modificar modelos base.
Leia também: Google lança Gemini 4 Carbon, IA que domina cibersegurança hoje
O Infini-AI-Lab lançou o Hermit, um framework open-source que treina um adaptador externo para agentes de IA enquanto o modelo e o harness permanecem congelados, abrindo caminho para adaptar sistemas como Codex e Claude Code a novas tarefas sem fine-tuning nem alterações delicadas na infraestrutura original.
Framework promete adaptação sem tocar no modelo base
Disponível globalmente via PyPI e GitHub, o Hermit teve a versão 0.1.0 liberada na semana passada e foi anunciado publicamente pelo pós-doutor Haizhong Zheng, da Carnegie Mellon University (CMU). Em mensagem de apresentação, Zheng resumiu o objetivo da ferramenta: “O pitch é simples: adaptar agentes Codex ou Claude Code para novas tarefas sem fine-tuning ou fork do harness”.
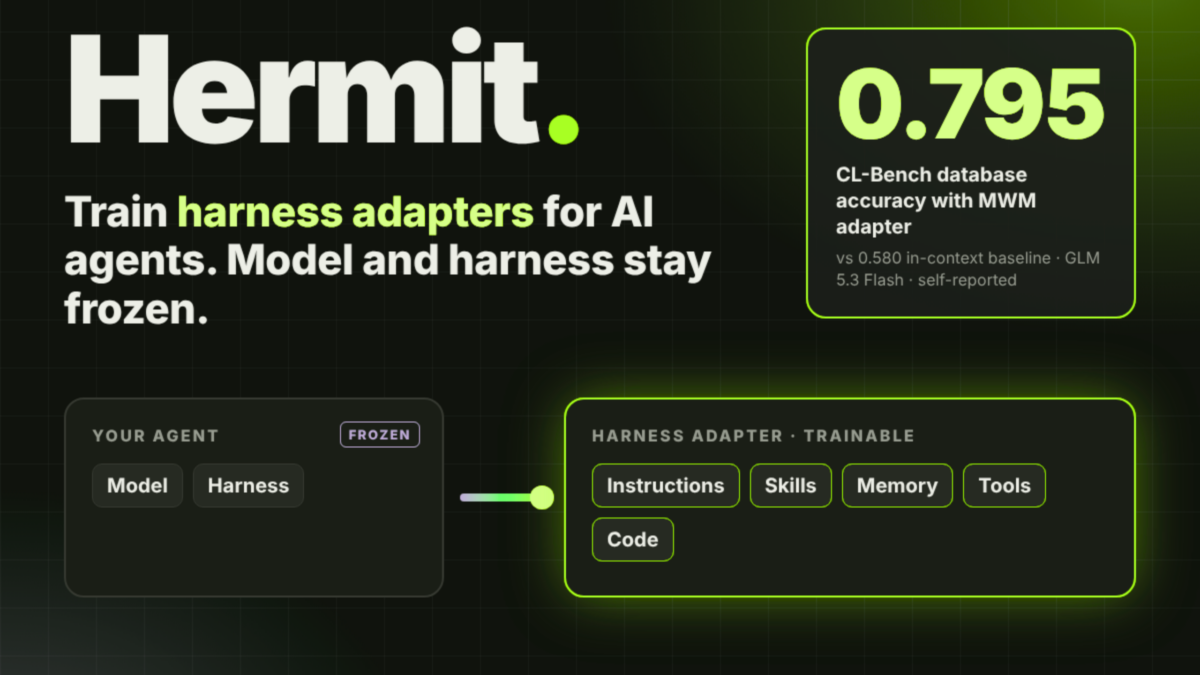
Na prática, o Hermit introduz o conceito de harness adapter, um adaptador treinável que funciona como um plugin com suporte nativo a treinamento. Em vez de mexer no modelo ou no harness que já estão em produção, o desenvolvedor treina esse componente externo para que o agente aprenda novas habilidades e fluxos de trabalho.
Segundo a especificação do projeto, “o adaptador pode conter instruções, habilidades, memória, ferramentas, código executável e lógica de coordenação”. Ele pode até ser um repositório inteiro, com partes marcadas como aprendíveis e um esquema explícito de como as atualizações são validadas. O modelo base e o harness original ficam intocados.
Entenda o contexto
A arquitetura do Hermit nasce de três problemas recorrentes apontados pela equipe do Infini-AI-Lab: muitos harnesses são fechados e não podem ser modificados; mexer nos que são abertos pode quebrar interações finamente ajustadas entre componentes; e um adaptador aprendido tende a ser reutilizável entre diferentes modelos e harnesses compatíveis. “O design foi pensado porque muitos harnesses são fechados, editar os abertos pode quebrar interações delicadas, e um adaptador aprendido pode se mover entre modelos e harnesses compatíveis”, resume a equipe.
Ao deslocar a adaptação para esse plugin treinável, o Hermit promete mais segurança e mobilidade: o mesmo adaptador pode ser movido de um backend para outro, desde que sejam compatíveis, e o risco de derrubar uma aplicação em produção ao editar o harness cai bastante. A abordagem também contorna o bloqueio de ferramentas proprietárias que não expõem o código do orquestrador de agentes.
Loop de treinamento em estilo RL
O treinamento dos adaptadores é organizado em um loop inspirado em reinforcement learning (RL). “O loop de treinamento RL consiste em Trainer, Judge e Evolver que iterativamente treinam e atualizam o adaptador”, descreve a documentação do Hermit.
O Trainer executa lotes de tarefas com o agente usando o adaptador atual e registra as trajetórias. O Judge avalia as saídas, atribuindo notas ou feedback qualitativo. O Evolver lê esses dados e propõe uma nova versão do adaptador com base no desempenho observado. O Trainer então verifica se a proposta respeita o template definido e, se estiver tudo certo, comita essa versão como o próximo estado do adaptador.
Cada versão fica registrada em um repositório git, o que permite inspecionar alterações, reverter regressões e promover releases estáveis. Para aumentar a segurança, os programas de aprendizado podem rodar em sandbox em sistemas Linux usando bubblewrap, isolando o ambiente de execução.
Métodos de evolução e primeiros resultados
A primeira leva do Hermit já chega com cinco métodos de evolução implementados: GEPA, SkillOpt, MetaWorld Model (MWM), Harness² e Continual Harness. A equipe promete integrar em breve novos métodos como ACE e ReHarness, ampliando o repertório para diferentes tipos de tarefa.
Nos exemplos publicados pelo projeto, o Hermit demonstra ganhos expressivos em benchmarks. No OfficeQA, que avalia respostas a 172 perguntas sobre boletins do Tesouro dos EUA, o método Harness² registra um aumento de +7,6 pontos em relação à referência, com intervalo de confiança de 95% entre +1,7 e +13,4. GEPA e SkillOpt treinam em 50 perguntas e são testados congelados, enquanto Continual Harness e Harness² continuam aprendendo à medida que recebem o fluxo de questões.
Na suíte CL-Bench, voltada para ambientes com estado, o MetaWorld Model (MWM) chega a 0,795 de acurácia em exploração de banco de dados, superando o baseline de aprendizado in-context, que marca 0,580. No mesmo conjunto, em poker explorável, o MWM vence 3,08 big blinds por mão, contra 2,51 do baseline, sinalizando que o adaptador consegue extrair mais valor em situações dinâmicas.
Outro destaque aparece no ServeLearnBench, que simula 624 solicitações de suporte no varejo sob uma política escondida e mutante. Nesse cenário, o MWM atinge 45,3 pontos, contra 28,7 do melhor método anterior na liderança. Um oráculo que conhece a política de antemão marca 89,2 pontos, servindo de teto teórico de desempenho.
Foco em modularidade, segurança e interoperabilidade
O Hermit foi desenhado para dialogar com diferentes modelos e infraestruturas. Os backends suportados na estreia incluem Fireworks, OpenAI, Anthropic, DeepSeek, vLLM, SGLang e Ollama. Os modelos são referenciados em um formato padrão combinando backend e identificador.
A linha de comando traz subcomandos para checar configurações, treinar, avaliar, implantar e converter adaptadores. O comando de deploy gera workspaces prontos para agentes como Codex, Claude Code ou Pi, enquanto o de conversão exporta adaptadores treinados como plugins nativos para esses agentes e para Hermes, facilitando uso em produção.
Um dos exemplos avançados disponíveis mostra um adaptador colaborativo para o sistema de provas Lean, capaz de coordenar cinco agentes Codex trabalhando juntos para demonstrar um teorema. A ideia é que a lógica de coordenação fique no adaptador, preservando o harness original do ambiente de provas.
Setores que dependem fortemente de agentes de IA — como automação corporativa, atendimento ao cliente, pesquisa científica e jogos — tendem a se beneficiar da estratégia. Com adaptadores treináveis e versionados, empresas e laboratórios ganham um caminho mais seguro para personalizar agentes rapidamente, sem tocar nos blocos mais sensíveis da pilha técnica.
Comunidade reage e pressiona modelos fechados
O lançamento do Hermit vem sendo recebido com entusiasmo por desenvolvedores e pesquisadores, especialmente entre comunidades online especializadas em aprendizado de máquina, que reúnem hoje centenas de milhares de integrantes ao redor do mundo. A abertura do código e o foco em modularidade facilitam experimentos colaborativos, forks de adaptadores e compartilhamento de receitas de evolução.
Ao mesmo tempo, a chegada de um framework aberto e interoperável tende a aumentar a pressão sobre fornecedores de modelos e harnesses proprietários, que podem ser cobrados por mais transparência e compatibilidade. Em vez de prender o desenvolvedor a um ecossistema fechado, a abordagem de adaptadores externos incentiva a portabilidade entre soluções.
A equipe do Infini-AI-Lab já sinaliza continuidade no desenvolvimento, com planos de incorporar os novos métodos ACE e ReHarness e ampliar a biblioteca de exemplos práticos. A expectativa é que, a partir de ferramentas como o Hermit, surja um ecossistema de adaptadores compartilhados para diferentes domínios, acelerando a evolução de agentes de IA em cenários cada vez mais complexos.
O Hermit pode ser instalado via PyPI com o comando de rotina para pacotes Python, e o repositório com código, documentação e exemplos está disponível no GitHub, de forma aberta, para quem quiser testar, contribuir ou integrar a ferramenta em pipelines corporativos e acadêmicos.