NVIDIA acelera Ling-3.0-flash 42,5% no DGX Spark e corta latência
NVIDIA detalha três otimizações que aceleram em 42,5% a inferência do modelo MoE Ling-3.0-flash no desktop DGX Spark, com 24,5% menos latência e sem perda de precisão.
Tecnologia
NVIDIA apresenta melhorias significativas no desempenho do modelo Ling-3.0-flash, reduzindo latência e aumentando a eficiência.
Leia também: Ballistic Ventures mira US$ 490 mi em novos fundos de cibersegurança
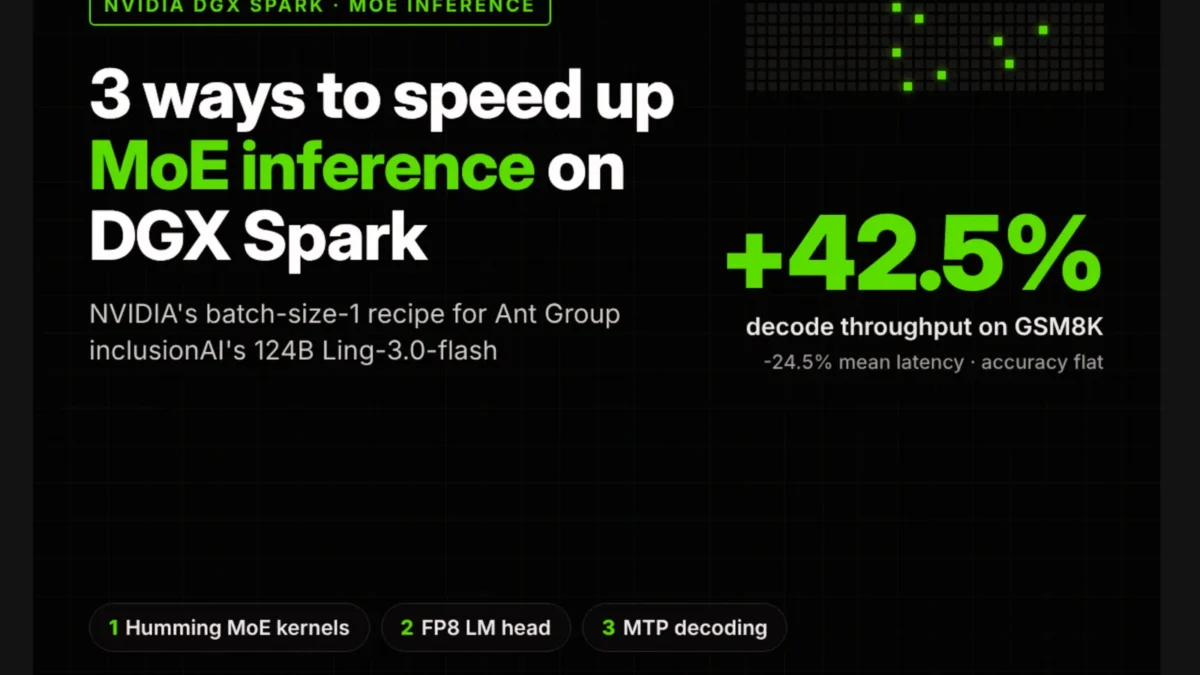
A NVIDIA acelerou em 42,5% o throughput de inferência do modelo gigante Ling-3.0-flash, da Ant Group inclusionAI, rodando no sistema desktop DGX Spark, e reduziu a latência média em 24,5%, sem alteração estatisticamente detectável na precisão das respostas.
Três otimizações empilhadas no desktop DGX Spark
No estudo técnico, a empresa mostra como empilhou três otimizações para servir um modelo mixture-of-experts (MoE) de 124 bilhões de parâmetros — com 5,1 bilhões ativos por passo — em um único DGX Spark, máquina de mesa equipada com o superchip GB10 Grace Blackwell, 128 GB de memória unificada, 273 GB/s de banda de memória e pico de até 1 petaFLOP em FP4 esparso.
O gargalo identificado estava na decodificação com batch size 1, cenário típico de atendimento a um único usuário em tempo real. A execução era limitada pela leitura dos pesos do modelo, principalmente em duas partes: o cálculo MoE e a camada LM head, responsável por pontuar todo o vocabulário a cada token gerado.
A primeira mudança foi trocar o backend de kernels MoE FlashInfer pelo Humming, biblioteca que compila kernels em tempo real para os formatos e para a GPU usada. Só essa troca elevou o throughput de 36,09 para 39,45 tokens por segundo, um ganho de 9,3%.
Na sequência, a NVIDIA quantizou apenas a camada LM head — uma matriz de 157.184 por 2.560 — para FP8 na carga do modelo, reduzindo pela metade as leituras de memória nesse ponto crítico. Com o novo backend Humming mais o LM head em FP8, o throughput chegou a 43,94 tokens por segundo, 21,7% acima do baseline.
A terceira peça foi a decodificação especulativa MTP usando a camada NEXTN já embutida no Ling-3.0-flash, dispensando um modelo auxiliar. Nessa configuração, o sistema gera três tokens de rascunho e verifica quatro posições de uma vez, aceitando em média 3,9 tokens por rodada nos testes sintéticos. Com isso, o throughput saltou para 102,88 tokens por segundo, alta de 185,1% em relação à linha de base.
Ganho real medido em benchmark de raciocínio
Como testes sintéticos tendem a favorecer esse tipo de técnica, a NVIDIA também rodou as 1.319 questões do benchmark GSM8K com prompting de cinco exemplos e cadeia de raciocínio, em regime de amostra (temperature 0,6, top_p 0,95 e top_k 29).
Nesse cenário mais próximo de uso real, o tempo por token caiu de 26,45 milissegundos para 18,56 milissegundos. O throughput de decodificação aumentou 42,5%, de 37,81 para 53,89 tokens por segundo, enquanto a latência média por pergunta passou de 15,21 para 11,49 segundos, redução de 24,5%.
A acurácia praticamente não mudou, passando de 96,89% para 96,82%. No blog técnico, a empresa resume o resultado: “Decode throughput rose 42,5% with no statistically detectable accuracy change.”
Mesmo com textos menos repetitivos e uso de amostragem, o sistema ainda aceitou em média 2,68 tokens por rodada na decodificação especulativa, bem abaixo dos 3,90 tokens dos testes sintéticos, mas suficiente para manter um ganho expressivo de desempenho.
Entenda o contexto
O DGX Spark é apresentado pela NVIDIA como um sistema de inferência de alto desempenho para ser usado ao lado da mesa, e não apenas em centros de dados. A combinação com o Ling-3.0-flash-fp4, otimizado para baixo custo por token e licenciado de forma aberta pela inclusionAI, mira justamente aplicações que exigem grandes modelos de linguagem mas querem fugir da dependência exclusiva de infraestrutura em nuvem.
A família Ling 3.0 inclui versões menores, como o Ling-3.0-tiny, e variantes especializadas em visão computacional, finanças e saúde, todas construídas sobre a mesma base técnica. O estudo da NVIDIA explora especificamente como extrair mais desempenho da variante flash no hardware Grace Blackwell.
Como funcionam as otimizações no Ling-3.0-flash
As três técnicas atuam em pontos diferentes do pipeline. O backend Humming recompila os kernels MoE sob medida para o formato MXFP4 e para o tamanho estreito da camada de especialistas (768 de largura), evitando o custo de compilar dezenas de alvos pré-definidos, como ocorre no fluxo original com CUTLASS.
A quantização da LM head para FP8, feita apenas nessa camada de saída, ataca o que mais pesa na memória: a cada token, o modelo precisa ler a matriz inteira para pontuar o vocabulário. Com metade dos bytes, a leitura fica mais rápida, com impacto mínimo na qualidade observada.
Já a decodificação especulativa MTP com NEXTN embutido reduz o número de passos de decodificação. Em vez de gerar e verificar um token por vez, o modelo antecipa vários e depois confere o que pode ser aproveitado. Segundo a NVIDIA, “Verification costs about 2.26x a normal decode step. The main cost is MoE, not attention.” A lógica é pagar mais caro por verificação, mas em menos passos.
Na prática, Humming e FP8 diminuem o custo de cada passo, enquanto o MTP reduz a quantidade de passos. Como não há sobreposição entre os ganhos, as três otimizações se somam.
Desafios de integração e riscos de queda de performance
Empilhar as otimizações, porém, não é trivial. Um dos principais riscos está na interação entre a LM head em FP8 e o MTP. Se o draft da decodificação especulativa não compartilhar o mesmo módulo de LM head, o framework pode interpretar silenciosamente pesos FP8 como BF16, derrubando o comprimento médio aceito por rodada para 1 token e fazendo o throughput cair abaixo da linha de base não otimizada.
O próprio time técnico alerta para esse cuidado: “The NVIDIA team advises checking at startup that each optimization is active.” A recomendação é validar, no início da execução, se o backend Humming foi carregado, se a camada LM head está de fato em FP8 e se o MTP está operando com a LM head correta.
Outro desafio é a exigência de equipes mais especializadas. A configuração dos caminhos de kernel, das flags de quantização e da decodificação especulativa exige conhecimento detalhado do stack de software (como SGLang e os cookbooks do Ling), o que pode limitar a adoção imediata em ambientes corporativos menos maduros em IA.
Impacto para desenvolvedores e mercado de IA
Para desenvolvedores e pesquisadores, o principal recado é que modelos MoE gigantes, como o Ling-3.0-flash de 124 bilhões de parâmetros, podem atender requisições individuais com alta velocidade em um sistema de mesa, desde que o hardware e o software sejam explorados no limite.
Na prática, o aumento de 42,5% no throughput e a queda de 24,5% na latência significam mais respostas por unidade de tempo e menor espera para o usuário final. Setores que dependem de processamento intenso de linguagem natural — de atendimento automatizado a análise financeira e aplicações médicas — podem considerar rodar modelos desse porte localmente, reduzindo custos recorrentes de nuvem e ganhando controle sobre dados sensíveis.
Ao mesmo tempo, a necessidade de configurar corretamente quantização, backends de kernel e decodificação especulativa tende a pressionar por mais suporte, documentação e ferramentas que automatizem essas escolhas. A NVIDIA indica que os próximos passos passam por incorporar essas otimizações em versões futuras do DGX Spark e do stack de inferência, além de estendê-las para outras variantes da família Ling 3.0.
No médio prazo, a demonstração de que um desktop especializado consegue servir um MoE de 124 bilhões de parâmetros com esse nível de eficiência deve estimular concorrentes a investir em soluções similares, com foco em alto desempenho fora dos grandes centros de dados.