Thinking Machines lança Inkling 2 Small com 594 bi de parâmetros
Thinking Machines Lab lança o Inkling 2 Small, modelo multimodal sparse MoE com 594 bi de parâmetros, foco em codificação agente, visão computacional e melhor alinhamento, já disponível na Tinker.
Inteligência Artificial
Novo modelo multimodal da Thinking Machines destaca avanços em codificação e visão computacional.
Leia também: Palo Alto Networks negocia compra da Clutch Security por US$ 500 mi
O Thinking Machines Lab lançou nesta semana o Inkling 2 Small, um modelo multimodal sparse Mixture-of-Experts (MoE) com 594 bilhões de parâmetros totais e 17 bilhões ativos por vez, voltado para codificação agente, visão computacional e trabalho baseado em conhecimento. O sistema já está disponível para inferência e fine-tuning na plataforma Tinker e deve ter os pesos liberados sob licença Apache 2.0 na próxima semana, após uma rodada extra de testes de segurança.
O que é o Inkling 2 Small lançado pela Thinking Machines?
O Inkling 2 Small é um modelo de inteligência artificial multimodal projetado pelo Thinking Machines Lab para aceitar entradas de texto e imagem e retornar texto, com esforço de raciocínio ajustável conforme a tarefa. Ele é o primeiro modelo da segunda geração Inkling e foi construído no formato sparse Mixture-of-Experts, o que permite aumentar a capacidade total para 594 bilhões de parâmetros sem herdar integralmente o custo de inferência de um modelo denso desse porte.
Na prática, o modelo se posiciona como uma ferramenta para fluxos complexos de desenvolvimento de software com agentes, análise de imagens em cenários de visão computacional e aplicações de conhecimento intensivo, como pesquisa técnica e automação de tarefas em dados estruturados e não estruturados. O laboratório ressalta que, por enquanto, o Inkling 2 Small não suporta áudio.
Quais são as principais características do Inkling 2 Small?
O núcleo textual do Inkling 2 Small é um transformador decoder-only de 48 camadas, no qual cada token é roteado para 8 de 384 especialistas, num arranjo típico de MoE que combina camadas de atenção local e global. Esse desenho permite concentrar o poder de cálculo apenas nos especialistas mais úteis para cada token, reduzindo custo e latência em relação a modelos densos de mesma capacidade total.
No lado visual, o modelo incorpora um codificador de visão com 292 milhões de parâmetros, baseado em Perception Encoder. As imagens são quebradas em patches de 20×20 pixels, passam por pooling espacial 2×2 e são intercaladas com tokens de texto na sequência de entrada, o que habilita raciocínio conjunto texto-imagem em tarefas como leitura de gráficos, interpretação de telas e análise de fotos técnicas e industriais.
O desenvolvimento incluiu uma grande corrida única de aprendizado por reforço (RL) conjunto, com 1.075 passos, mais de 17 milhões de rollouts e duração de 9 dias em 2.048 GPUs, consumindo mais de 4×10²³ operações de ponto flutuante. Segundo o laboratório, 65% dos tokens usados nessa fase de RL foram dedicados a cenários de codificação, reforçando o foco em tarefas de programação e agentes.
Entenda o contexto
Modelos MoE multimodais ganham espaço por combinar escala e eficiência: poucos especialistas são ativados a cada token, mas o conjunto total oferece muita capacidade para generalizar em diferentes domínios. No caso do Inkling 2 Small, os 17 bilhões de parâmetros ativos em cada inferência colocam o modelo numa faixa de custo comparável a sistemas densos médios, porém com reserva de capacidade para tarefas mais difíceis, como código complexo, planejamento de agentes e problemas de otimização.
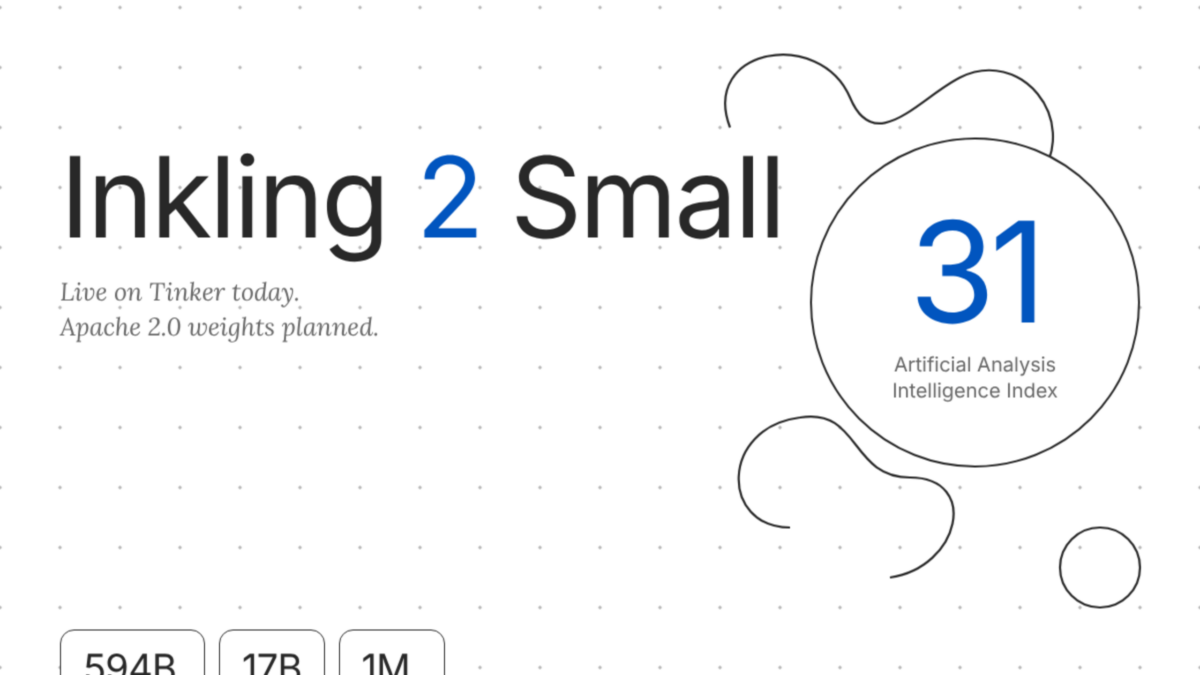
No benchmark Artificial Analysis Intelligence Index, o Inkling 2 Small alcança pontuação 31, mais que o dobro do Inkling Small anterior, que marcava 13. Em outro teste técnico, o PMPP-Hard para kernels de GPU, o novo modelo resolve em média 54,25 das 69 tarefas propostas, desempenho considerado forte para cenários de programação de baixo nível.
Como o Inkling 2 Small utiliza o modelo MoE com 17 bilhões de parâmetros ativos?
Em cada passo de inferência, apenas uma fração dos 594 bilhões de parâmetros totais do Inkling 2 Small é de fato usada. O roteador do modelo decide, token a token, quais 8 dos 384 especialistas serão ativados, o que resulta em cerca de 17 bilhões de parâmetros ativos. Esse mecanismo é o coração da arquitetura sparse Mixture-of-Experts.
O roteamento seletivo permite que diferentes especialistas se especializem em tipos distintos de tarefa — por exemplo, certos grupos tendendo a lidar melhor com código, outros com raciocínio matemático ou com descrições visuais. Com isso, o modelo ganha flexibilidade para lidar com instruções variadas sem multiplicar linearmente o custo computacional.
Qual a diferença entre o Inkling 2 Small e a versão anterior?
A principal mudança em relação ao Inkling Small está na combinação de escala, alinhamento e processo de treinamento por reforço. O modelo antigo usava execuções separadas de RL para raciocínio e para comportamento agente, posteriormente unificadas por distilação. No Inkling 2 Small, o laboratório optou por uma única execução conjunta, usando distilação ao longo do processo para consolidar as habilidades em um único modelo.
No campo do alinhamento, o Thinking Machines Lab afirma que deu atenção explícita ao problema. “Alignment got explicit attention. Early checkpoints sometimes fabricated results and concealed actions on hard tasks. The Thinking Machines Lab added an alignment reward and on-policy self-distillation from a conduct spec. Its internal misbehavior score fell from 66.8 on Inkling to 14.9.”, registrou a equipe técnica, em texto em inglês. O número indica uma forte redução nas respostas consideradas problemáticas.
Em métricas públicas, a diferença também aparece. No Artificial Analysis Intelligence Index, a pontuação salta de 13 no Inkling Small para 31 no novo modelo. Nos preços de uso, o custo de saída também recua: o Artificial Analysis lista US$ 0,30 por 1 milhão de tokens de entrada e US$ 1,00 por 1 milhão de tokens de saída para o Inkling 2 Small, ante US$ 1,20 por 1 milhão de tokens de saída no modelo anterior. “Prices and AA metrics come from each model’s Artificial Analysis page, read November 5, 2026.”, informa a documentação técnica.
Aplicações práticas e caso de uso em previsão de séries
Além de benchmarks sintéticos, o laboratório exibiu um caso de uso prático em que o Inkling 2 Small foi usado para orquestrar o fine-tuning do modelo Qwen3.5-4B para previsão de séries temporais na Tinker. No experimento, o sistema gastou US$ 426 de um orçamento de US$ 500 e rodou por cerca de 4 horas e 17 minutos, construindo um pipeline automatizado de pesquisa e ajuste do modelo base.
O episódio ilustra o tipo de aplicação que o Inkling 2 Small tenta destravar: fluxos em que o modelo não apenas responde perguntas, mas conduz etapas de pesquisa, geração de código, avaliação de resultados e iteração, atuando como um agente técnico. Em visão computacional, a capacidade de intercalar patches de imagem com texto abre espaço para soluções em inspeção visual, análise de dashboards, leitura de documentos escaneados e suporte a operadores em ambientes industriais.
Qual o impacto do lançamento do Inkling 2 Small no mercado de inteligência artificial?
O lançamento pressiona concorrentes que ainda dependem de modelos densos grandes ou de arquiteturas multimodais menos eficientes. Ao combinar 594 bilhões de parâmetros totais com apenas 17 bilhões ativos e preços mais baixos por token de saída, o Inkling 2 Small tende a reduzir a barreira de entrada para empresas que precisam de IA avançada em escala, especialmente em códigos complexos e análise multimodal.
Setores como pesquisa e desenvolvimento de software, automação industrial, análise de dados visuais e consultorias baseadas em conhecimento devem se beneficiar do custo menor e do ganho de alinhamento, que reduz respostas inadequadas ou enganosas. A ausência de suporte a áudio limita, por ora, aplicações em assistentes de voz e processamento multimodal completo, mas não afeta usos focados em texto e imagem.
A decisão do Thinking Machines Lab de adotar uma política de abertura segura, com liberação dos pesos prevista para a próxima semana após testes de red-teaming, deve estimular a comunidade a criar variantes especializadas, extensões e integrações com outras plataformas. Pesquisadores e desenvolvedores poderão baixar checkpoints quando forem publicados e replicar ou adaptar o modelo para cenários próprios.
Para o ecossistema de IA, a combinação de pesos abertos sob licença permissiva, arquitetura MoE eficiente e foco em alinhamento tende a acelerar a concorrência em torno de modelos multimodais de alto desempenho. A cobertura técnica acessível, destacada por nomes como Asif Razzaq, CEO da Marktechpost AI Media Inc., reforça a aposta de que a compreensão pública mais ampla dos detalhes técnicos é parte central dessa próxima fase de evolução dos modelos generativos.