Gigantes de IA adotam padrão único em robots.txt
Anthropic, OpenAI, Google, Microsoft e Meta apoiam um sinal comum em robots.txt para que sites indiquem se autorizam o uso de seus conteúdos no treinamento de modelos de IA.
Inteligência Artificial
Principais empresas de IA concordam em usar um padrão unificado para controlar o uso de conteúdos em treinamentos.
Leia também: Vaticano cria IA católica com ética e proteção infantil clara
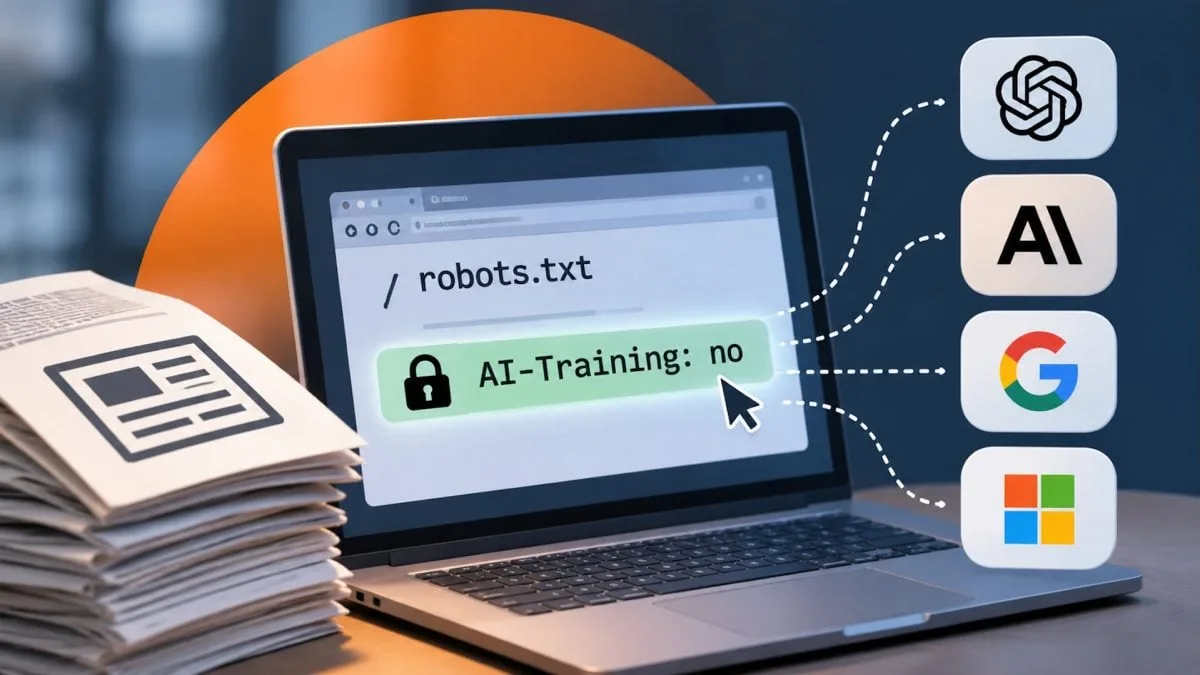
Anthropic, OpenAI, Google e Microsoft anunciaram nesta semana apoio a um padrão único no arquivo robots.txt que permite a sites e veículos de comunicação indicar, de forma padronizada, se autorizam o uso de seus conteúdos no treinamento de modelos de inteligência artificial, ampliando o controle editorial sobre materiais publicados na internet.
Como funciona o novo sinal para IA no robots.txt
O mecanismo se baseia em um “sinal” compartilhado dentro do robots.txt, arquivo já usado há anos para orientar robôs sobre quais páginas podem ou não ser acessadas em um site. A proposta foi apresentada pelo engenheiro Kevin Kelley, da Anthropic, no âmbito da IETF, grupo que discute e define padrões técnicos da infraestrutura da internet.
Na prática, em vez de criar regras específicas para cada empresa de tecnologia, administradores de sites poderão incluir uma única instrução para todos os grandes desenvolvedores de IA. Assim, “os veículos poderão comunicar uma mesma preferência a diferentes empresas de IA, sem precisar estabelecer uma regra separada para cada uma”.
A Anthropic afirma que já oferece suporte ao novo padrão em seus sistemas. A OpenAI diz que deve adotar o mecanismo nos próximos meses. Já Google e Microsoft informam que a implementação está prevista para 2027. A Meta declarou apoio à iniciativa, mas ainda não definiu prazo para começar a respeitar o sinal em seus processos de coleta de dados.
Entenda o contexto
A discussão ganha força em meio à preocupação crescente de veículos jornalísticos e outros produtores de conteúdo com o uso de seus textos, imagens e vídeos no treinamento de sistemas de IA generativa, muitas vezes sem autorização explícita ou compensação financeira.
Hoje, cada empresa de IA costuma operar com seus próprios rastreadores, que percorrem páginas públicas para alimentar bancos de dados. Para restringir esse acesso, editores de sites precisam identificar os robôs de cada companhia e escrever regras específicas no robots.txt, um processo trabalhoso e sujeito a falhas.
Com o novo padrão, a sinalização passa a ser unificada: uma mesma instrução vale, em tese, para todos os grandes modelos que aderirem à especificação. A expectativa é reduzir o esforço operacional dos sites e dar mais clareza sobre o que pode ou não ser usado nos treinamentos.
Impacto para veículos e empresas de tecnologia
Para redações e portais de notícias, o sinal comum representa uma forma mais simples de proteger reportagens, análises e outros conteúdos autorais. Em vez de perseguir mudanças constantes nos robôs de cada empresa, bastará ajustar uma regra central, que passa a valer para todo o ecossistema que aderir ao padrão.
Do lado das empresas de IA, a adesão implica rever fluxos de coleta de dados e sistemas de indexação para garantir que o novo comando seja respeitado. Isso pode reduzir o volume de material disponível para treinar modelos, especialmente se grandes grupos de mídia optarem por bloquear o uso de seus arquivos.
Especialistas avaliam que a mudança pode provocar uma reorganização no mercado de dados para IA, com maior peso para conteúdos licenciados diretamente e menos dependência de varreduras amplas da web. Ao mesmo tempo, o padrão é visto como um gesto de autorregulação do setor de tecnologia, em meio a pressões regulatórias em diferentes países.
Limites e próximos passos
Apesar do avanço técnico, o novo mecanismo está longe de ser uma barreira absoluta. Como reconhecem os próprios defensores do padrão, “o mecanismo, porém, não representa uma garantia técnica contra a coleta indevida: sua eficácia depende de as empresas respeitarem o sinal”. Em outras palavras, trata-se de uma regra de boa conduta, não de um bloqueio criptográfico.
Veículos e associações ligadas à indústria jornalística devem acompanhar de perto a implementação, cobrando transparência sobre como os rastreadores são configurados e quais conteúdos entram, de fato, nos conjuntos de treino. Em casos de descumprimento, a discussão tende a migrar para tribunais e órgãos reguladores, com base em leis de direitos autorais e proteção de dados.
Além da adesão já anunciada por Anthropic, OpenAI, Google, Microsoft e do apoio manifestado pela Meta, a expectativa é que outras empresas de IA e grandes plataformas sigam o mesmo caminho, consolidando o padrão como referência para a relação entre produtores de conteúdo e desenvolvedores de modelos na próxima geração de sistemas de inteligência artificial.