Análise compara arquitetura de principais modelos MoE
Levantamento técnico atualizado mostra como DeepSeek, Qwen, Llama, Kimi, gpt-oss e GLM divergem em cinco parâmetros centrais de Mixture-of-Experts, com impacto direto em GPU, memória e latência.
Modelos AI
Estudo detalha diferenças técnicas em MoE que afetam desempenho e recursos computacionais dos principais modelos.
Leia também: NAT type: como ele afeta seus jogos online em casa
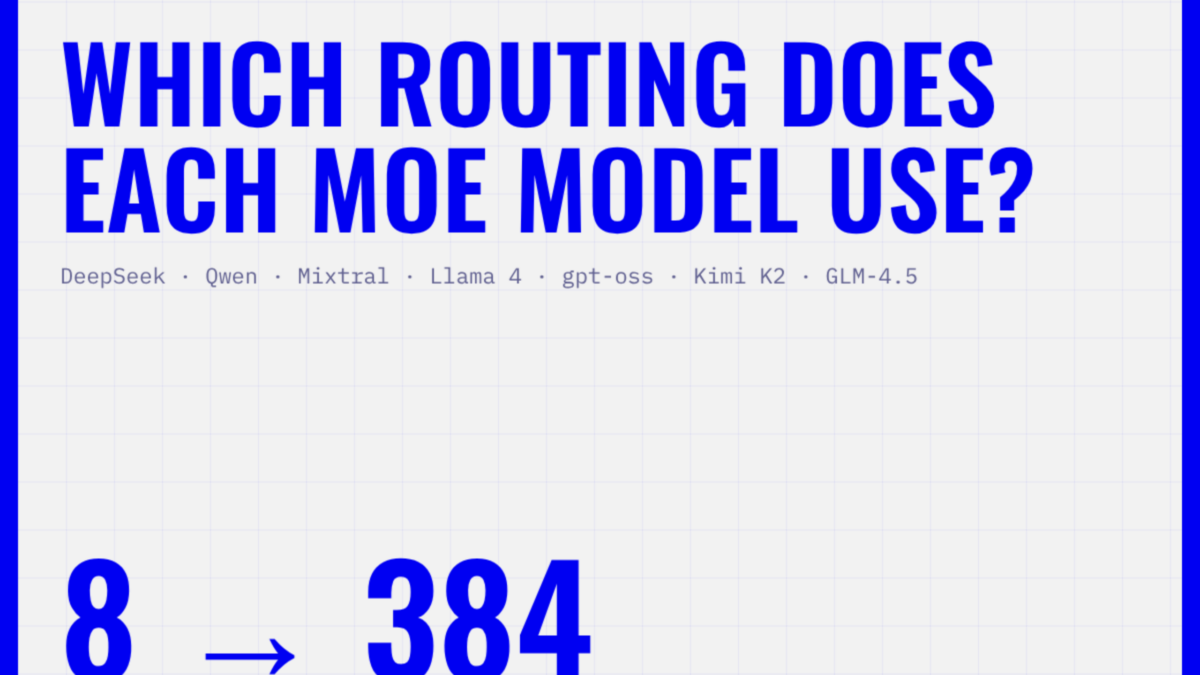
Uma análise técnica atualizada por Michal Sutter detalha como os principais modelos Mixture-of-Experts (MoE) abertos — como DeepSeek-V3, DeepSeek-V4, Qwen3, Qwen3.6-35B-A3B, Llama 4 Maverick, gpt-oss-120b, Kimi K2 e GLM-4.5 — divergem em cinco parâmetros centrais de roteamento e balanceamento de carga, com efeitos diretos em uso de memória, comunicação entre GPUs e custo de implantação.
Como os modelos MoE se diferenciam
Todos os modelos analisados seguem o mesmo princípio básico: cada token escolhe seus próprios especialistas. A comparação foca em cinco “botões” de projeto: número total de especialistas por camada, quantos especialistas cada token ativa (top-k), presença ou não de especialistas compartilhados, função usada para pontuar os especialistas e método de balanceamento de carga.
Segundo a análise, o número de especialistas varia de 8 a 384, enquanto o top-k vai de 1 a 8 por token. Em geral, mais especialistas significam mais pesos residentes em memória e mais tráfego de comunicação do tipo all-to-all entre GPUs, enquanto top-k menores reduzem o custo computacional e de comunicação por token.
DeepSeek-V3 e V4: mais especialistas e funções de pontuação diferentes
No DeepSeek-V3, o roteador trabalha com 256 especialistas roteados, usa uma função sigmoid para pontuar os especialistas e normaliza apenas as pontuações selecionadas. Um viés por especialista ajuda a direcionar a escolha dos top-8 sem alterar os pesos de mistura, e os especialistas são organizados em 8 grupos, com o roteador selecionando grupos antes de especialistas. O relatório técnico destaca que “One shared expert runs for every token”, criando um caminho denso compartilhado que sempre é executado.
O DeepSeek-V4 amplia esse desenho: sobe para 384 especialistas e reduz o top-k de 8 para 6 por token, trocando a sigmoid pela função sqrtsoftplus para o cálculo das pontuações. Outro ponto marcante é que “The first 3 MoE layers use hash routing, a fixed token-to-expert map”, ou seja, nas primeiras camadas o mapeamento de tokens para especialistas é fixo via hash. O modelo mantém um esquema de balanceamento baseado em viés, sem perda auxiliar adicional, o que tenta distribuir melhor a carga sem encarecer o treinamento.
Qwen3 e Qwen3.6: idas e vindas nos especialistas compartilhados
Os modelos originais da linha Qwen3 MoE usam 128 especialistas, com cada token roteado para 8 (top-8), mas sem especialistas compartilhados. De acordo com o relatório, “Qwen3 dropped the shared experts of Qwen2.5-MoE and adopted a global-batch balancing loss”, ou seja, abandonaram o caminho denso sempre ativo e passaram a usar uma perda de balanceamento calculada no lote inteiro, para uniformizar o uso dos especialistas.
Já o Qwen3.6-35B-A3B muda de direção: passa a 256 especialistas, com 8 roteados mais 1 compartilhado. Na prática, isso reintroduz um especialista que roda para todos os tokens, adicionando robustez e estabilidade ao custo de mais computação densa em cada passo.
Llama 4 Maverick: top-1 para cortar custo ativo
O Llama 4 Maverick adota uma estratégia híbrida, intercalando camadas totalmente densas e camadas MoE. Em cada camada MoE, um token vai para 1 especialista compartilhado e para 1 entre 128 especialistas roteados, em um esquema top-1 inspirado em arquiteturas como Switch Transformer. O anúncio do modelo resume: “Llama 4 Maverick alternates dense and MoE layers, keeping 17B active parameters despite 400B in total”.
Na prática, isso significa que, embora o modelo tenha cerca de 400 bilhões de parâmetros no total, apenas 17 bilhões ficam ativos em cada passo de inferência, o que reduz fortemente o custo de computação e facilita a execução em hardware com recursos mais limitados, desde que haja memória para armazenar os especialistas.
gpt-oss-120b: roteador linear e pesos compactos
No gpt-oss-120b, a arquitetura MoE combina 128 especialistas com top-4. A configuração descreve que “gpt-oss-120b uses a linear router over 128 experts and keeps the top 4”, sem especialistas compartilhados. O modelo tem 117 bilhões de parâmetros e envia os pesos MoE em formato MXFP4, o que permite acomodar tudo em uma única GPU de 80 GB.
Essa combinação — top-4, ausência de especialista denso compartilhado e quantização agressiva dos pesos — mira diretamente na redução de custo de inferência, mantendo a flexibilidade do roteamento token a token.
Kimi K2 e GLM-4.5: largura versus profundidade
O Kimi K2 segue de perto a arquitetura DeepseekV3ForCausalLM, mas empurra os limites na largura: usa 384 especialistas e top-8, no mesmo estilo de roteamento noaux_tc. O relatório técnico registra que “Higher sparsity lowered loss at fixed active compute”, ou seja, aumentar a esparsidade — mais especialistas totais, mantendo o mesmo número ativo por token — ajudou a reduzir a perda para o mesmo custo computacional efetivo.
O GLM-4.5, por sua vez, adota uma filosofia oposta: escolhe 160 especialistas e investe em mais camadas, priorizando profundidade em vez de largura extrema. A opção sugere uma busca por melhor capacidade de representação ao longo da pilha de camadas, sem levar o número de especialistas por camada ao limite máximo observado em outros modelos.
Entenda o contexto
Na prática, a análise de Michal Sutter mostra que pequenas diferenças nesses cinco parâmetros podem mudar completamente o perfil de implantação de um modelo MoE. A frase de uma das avaliações técnicas resume o dilema: “More experts per layer means more weights resident in memory and more all-to-all traffic”. Isso se traduz, na infraestrutura, em mais GPUs para acomodar os pesos e em interconexões mais rápidas para aguentar a comunicação.
Por outro lado, reduzir o top-k — como fazem Llama 4 Maverick (top-1) e DeepSeek-V4 (top-6, abaixo de top-8 do V3) — corta o custo por token e a pressão sobre a rede, o que ajuda em cenários de baixa latência. Já especialistas compartilhados, presentes em DeepSeek-V3, Qwen3.6-35B-A3B e Llama 4 Maverick, adicionam um caminho denso que todos os tokens percorrem: isso tende a estabilizar o comportamento do modelo, mas cobra um preço em FLOPs e tempo de resposta.
Para times de ciência de dados e engenharia de machine learning, a conclusão prática é clara: antes de escolher um MoE para produção, é preciso olhar além do tamanho total em parâmetros e avaliar especificamente a contagem de especialistas, o top-k, a existência de especialistas compartilhados e o método de balanceamento. Esses detalhes, expostos em arquivos de configuração e relatórios técnicos atualizados até 7 de novembro, definem se o modelo cabe ou não na infraestrutura disponível e quanto vai custar mantê-lo rodando em escala.