Google lança TPU 8i Max e TPU 8tx para turbinar IA segura
Google apresenta hoje TPU 8i Max, que dobra computação e memória em um único pacote, e TPU 8tx, voltado à inferência confidencial para empresas reguladas e governos.
Tecnologia
Novos chips do Google ampliam desempenho e segurança para inteligência artificial em setores regulados.
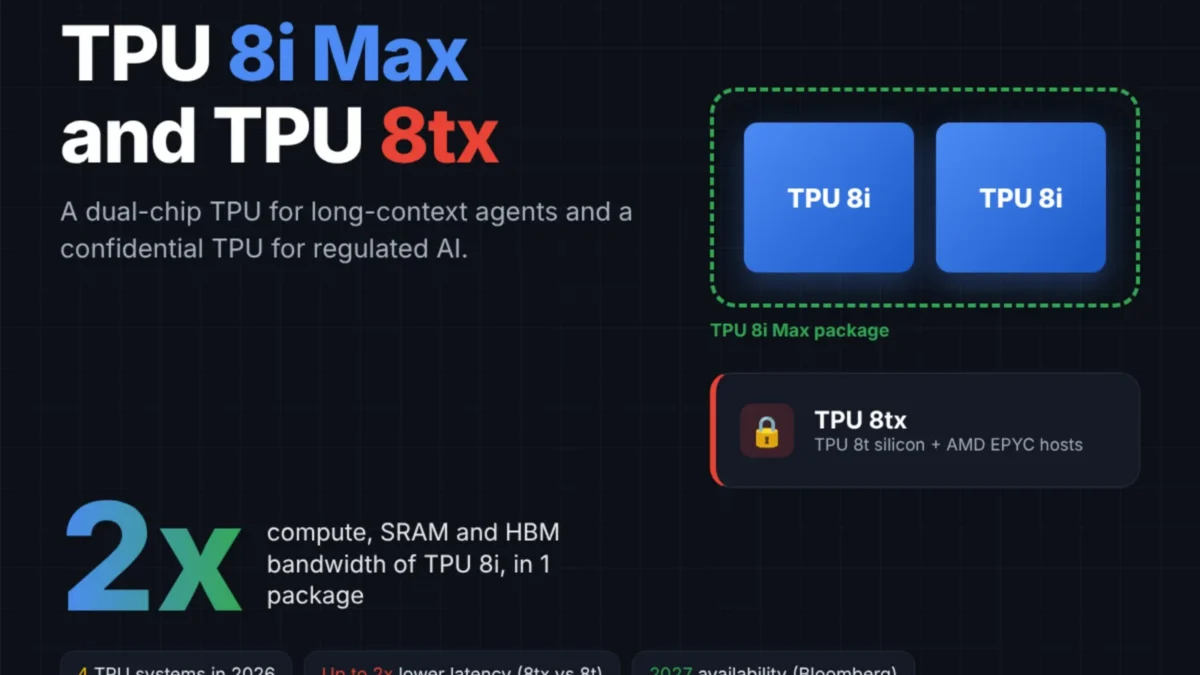
O Google anunciou nesta segunda-feira (9) duas novas configurações de sistema para sua oitava geração de TPUs: o TPU 8i Max, que dobra a capacidade de computação e memória em um único pacote para encarar janelas de contexto gigantes, e o TPU 8tx, voltado à inferência confidencial em empresas reguladas e órgãos de governo, mantendo dados protegidos mesmo durante o uso ativo.
TPU 8i Max dobra computação e mira janelas de contexto gigantes
O TPU 8i Max nasce da combinação de dois chips TPU 8i em um único pacote físico, sem aumentar a área ocupada no rack. Cada chip é especificado em 10,1 PFLOPS em FP4, 288 GB de memória HBM, 8.601 GB/s de largura de banda de HBM e 384 MB de SRAM on-chip. Somados, esses números levam o pacote a cerca de 20,2 PFLOPS FP4, 768 MB de SRAM e 17,2 TB/s de largura de banda de memória.
Segundo o Google, o TPU 8i Max “ataca a barreira da memória combinando dois chips TPU 8i em um pacote único”. A estratégia é oferecer mais computação e memória onde modelos avançados de IA costumam esbarrar em limitações de espaço e largura de banda, sobretudo em tarefas com janelas de contexto muito grandes.
Na prática, o alvo são agentes que precisam ler e raciocinar sobre bases de código inteiras ou horas de vídeo de uma vez, sem quebrar o processamento em partes menores. Ao encaixar o dobro de silício na mesma pegada de rack, o Google também aumenta a densidade de hardware em data centers, o que pode reduzir custos de infraestrutura para empresas que treinam e executam modelos em larga escala.
Apesar de não detalhar a capacidade total de HBM do pacote 8i Max, o Google destaca que a combinação do dobro de computação com o dobro de largura de banda de memória é pensada justamente para evitar gargalos, cenário conhecido na indústria como “memory wall”.
Entenda o contexto
As novas configurações não representam chips inéditos, mas um reaproveitamento do silício de oitava geração já existente. No TPU 8i Max, o ganho vem do empacotamento dual-chip e dos ajustes de arquitetura de sistema em torno de memória e rede, enquanto o TPU 8tx combina o silício atual com novos hosts de CPU e infraestrutura de rede para reduzir latência e reforçar segurança.
TPU 8tx mantém inferência confidencial em ambientes regulados
Voltado a setores que lidam com dados sensíveis, como finanças, saúde e administração pública, o TPU 8tx foi projetado para garantir que informações e pesos de modelos fiquem protegidos mesmo enquanto estão sendo processados. O Google descreve que o TPU 8tx “mantém dados e pesos do modelo protegidos mesmo durante o uso ativo”.
Tradicionalmente, dados criptografados acabam sendo descriptografados em memória na hora do processamento, abrindo uma janela de exposição. A proposta do 8tx é reduzir esse risco e permitir inferência confidencial em ambientes com forte regulação de proteção de dados, em que qualquer vazamento pode resultar em sanções legais e danos de reputação.
O sistema usa o mesmo silício do TPU 8t, mas é combinado a hosts com CPUs AMD EPYC de 5ª geração e à rede Boardfly, herdada do TPU 8i. Com isso, o Google afirma que o TPU 8tx “oferece até 2x menor latência que o TPU 8t, com quase nenhum impacto na segurança”.
Essa redução de latência é crucial para aplicações em que respostas rápidas são essenciais, como análise de transações financeiras em tempo real ou sistemas de atendimento automatizado que acessam prontuários médicos protegidos. Ao mesmo tempo, a arquitetura foi pensada para que operações sensíveis não precisem mais ser divididas entre clusters distintos, reduzindo o vai e vem de dados críticos.
Google aposta em IA segura de ponta a ponta
Um dos pontos destacados pelo Google é que, no TPU 8tx, equipes conseguem executar, no mesmo sistema, tarefas como fine-tuning, distilação de modelos e aprendizado por reforço, sem mover dados sigilosos entre diferentes infraestruturas. A centralização tende a simplificar a conformidade com leis de privacidade e a governança interna de dados.
Em testes anteriores de otimização de infraestrutura, com a tecnologia TPU Sync em outra geração de hardware (TPU v7x), o Google já havia observado ganhos importantes em latência: em um modelo Qwen3 235B, a latência mediana de transferência de chaves e valores caiu de vários segundos para cerca de 230 ms, com redução de 60% no tempo até o primeiro token. No modelo Qwen3 480B, o tempo até o primeiro token caiu 90% em cenários de baixa concorrência. Esses ensaios não foram feitos com o TPU 8i Max ou o 8tx, mas servem de referência para o tipo de melhoria que a empresa busca replicar nas novas configurações.
Com o 8i Max mirando desempenho e grandes contextos, e o 8tx focado em segurança e confidencialidade, o Google reforça sua estratégia de hardware sob medida para diferentes perfis de uso de IA — dos grandes provedores de nuvem a clientes corporativos e governos. A próxima etapa será a oferta comercial e a integração dos novos sistemas em serviços de nuvem e projetos específicos, num momento em que a pressão regulatória sobre dados cresce e a demanda por modelos cada vez maiores não dá sinais de arrefecer.