Astra reprograma redes neurais do zero e supera métodos clássicos
Modelo Astra lê e escreve diretamente pesos de redes neurais, corrige falhas sem usar gradiente e chega a multiplicar por três a capacidade de seguir instruções em outro modelo, apontam testes.
Inteligência Artificial
Novo modelo Astra revoluciona o treinamento de redes neurais ao eliminar o uso de gradiente e aumentar a eficiência.
Leia também: Marvell compra Lumentum por US$ 115 bi e domina chips ópticos
O modelo de linguagem Astra, liderado pelo pesquisador Rikiya Takehi, mostrou ser capaz de ler e escrever diretamente os pesos de redes neurais, identificar falhas internas e corrigi-las sem qualquer uso de gradientes, além de criar novas redes do zero que superam modelos treinados com métodos de otimização tradicionais.
LLM passa a mexer nos pesos como um “programador”
Os pesquisadores batizaram a técnica de Weight-Space Programming. A ideia é que o Astra receba, em linguagem natural, uma especificação do que a rede deve fazer, analise apenas a lista de números que compõe os pesos e faça edições cirúrgicas para alterar o comportamento do modelo, sem rodar loops de treinamento nem receber feedback do ambiente.
“We call this Weight-Space Programming”, disse Rikiya Takehi, ao descrever o procedimento. Segundo ele, o Astra usa raciocínio de alto nível para inferir o que cada parte da rede deveria estar computando e então ajusta diretamente os parâmetros numéricos.
Na prática, isso significa inverter a lógica predominante da última década no aprendizado de máquina, em que pequenos algoritmos simbólicos, como otimizadores baseados em gradiente, eram responsáveis por escrever e atualizar os pesos. A proposta agora é que grandes modelos de linguagem assumam esse papel de forma nativa, deliberando sobre a estrutura interna de outras redes.
Resultados em jogos e visão: entender o que a rede “pensa”
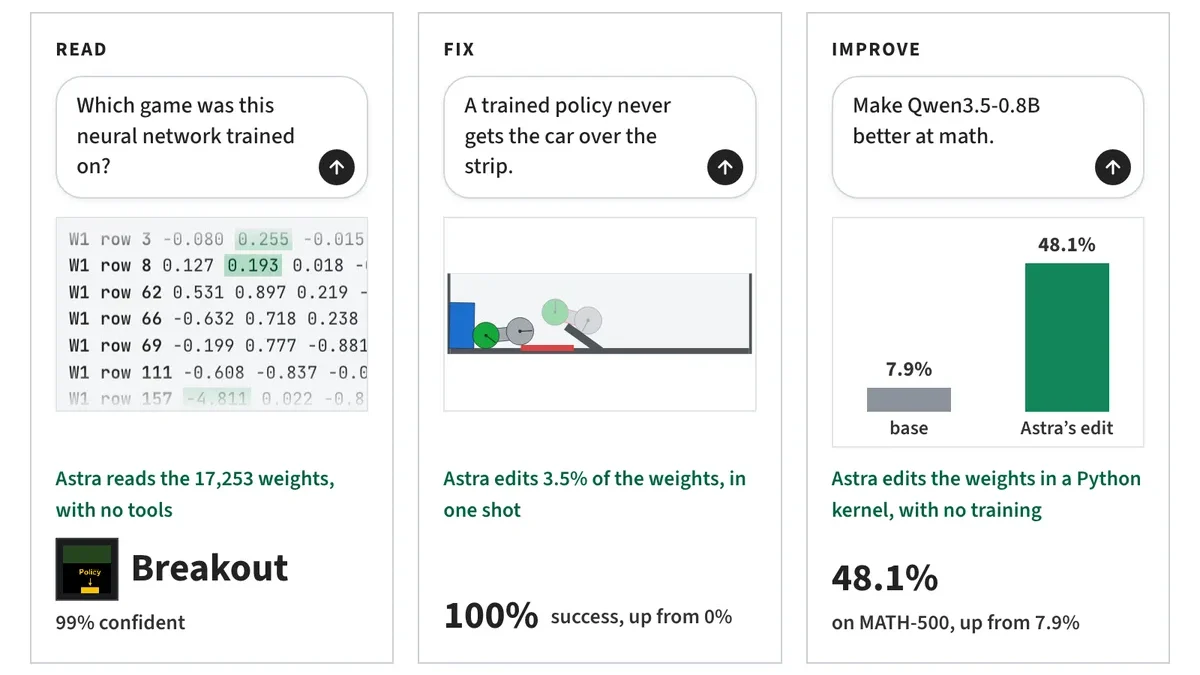
Em um dos experimentos, a equipe treinou redes com o algoritmo PPO para jogar quatro games diferentes. Todas usavam a mesma arquitetura, com os mesmos canais de entrada e o mesmo conjunto de ações, o que impede descobrir o jogo apenas olhando a estrutura da rede. Os pesquisadores então alimentaram o Astra apenas com os pesos brutos de cada política e perguntaram para qual jogo aquela rede havia sido treinada.
Sem receber a lista de jogos possíveis, o Astra acertou os quatro casos, só a partir de padrões presentes na matriz de pesos, como a forma como cada canal de entrada é usado na primeira camada e como as ações são discriminadas na saída. “Just by looking at the raw weights, GPT-6 Astra can tell what a network was trained to do”, afirmou Takehi.
Um teste semelhante foi feito com modelos de difusão treinados para gerar imagens simples de círculos, triângulos e quadrados. De novo sem rodar o modelo, o Astra identificou corretamente o que cada rede produzia, reconstruindo o contorno das formas a partir da geometria dos pesos na camada de saída. O fato de ter desenhado apenas o contorno, enquanto os modelos originais geravam formas preenchidas, é usado pelos autores como indício de que o Astra não está apenas simulando um forward pass escondido, mas de fato lendo a estrutura interna dos pesos.
Os pesquisadores foram além e esconderam as camadas de entrada e saída de pequenos modelos de linguagem treinados em três domínios distintos: código em Python, texto em japonês romanizado (romaji) e inglês. Com acesso apenas aos blocos intermediários de transformadores, o Astra teve de inferir tanto o idioma do treinamento como o papel das cabeças de atenção.
De acordo com a descrição do estudo, o modelo acertou os três idiomas nas duas tentativas e foi capaz de apontar precisamente as chamadas “induction heads”, cabeças responsáveis por copiar e repetir trechos vistos anteriormente, cruciais para completar padrões em código. No caso de romaji, o Astra teria notado que o último bloco usa menos direções distintas no espaço de representação, compatível com um alfabeto efetivamente menor.
Criação de redes do zero e correção de falhas
Além de ler, o Astra também escreve novas redes. Em experimentos com games, os pesquisadores pediram que ele projetasse, do zero, pequenos agentes de jogo, apenas seguindo uma descrição em linguagem natural do objetivo. As redes produzidas conseguiram superar políticas treinadas com PPO mesmo após 100 milhões de passos de interação com o ambiente, sem que o Astra rodasse qualquer ciclo de treinamento tradicional.
Outro teste mirou diretamente um problema conhecido em modelos de linguagem: loops de raciocínio, em que a resposta entra em ciclos repetitivos. Os pesquisadores pediram ao Astra que melhorasse a capacidade matemática do modelo Qwen3.5-0.8B, mas com uma restrição: nada de usar gradientes ou etapas adicionais de treinamento.
“Astra identifies an issue in its weights causing reasoning loops that Qwen’s own model card warns about, and fixes this by natively editing 0.016% of the weights”, relatou Takehi. Em outras palavras, o modelo leu os pesos do Qwen, encontrou um defeito interno relacionado a esses loops e o atacou com uma edição mínima: apenas 0,016% dos parâmetros foram modificados.
O impacto medido foi grande. “This weight correction raises MATH-500 from 7,9% to 48,1% and generalizes out of the box to instruction following, raising IFEval by 3x”, disse o pesquisador. No conjunto de testes matemáticos MATH-500, a precisão saltou de 7,9% para 48,1%. Em outro benchmark voltado à obediência a instruções, o IFEval, a capacidade do Qwen de seguir comandos aumentou três vezes, usando as mesmas configurações de amostragem de antes.
Entenda o contexto
Até agora, o ajuste fino de redes neurais depende majoritariamente de algoritmos de otimização baseados em gradiente, como Adam ou Muon, que percorrem o espaço de pesos subindo pequenas “encostas” de desempenho a cada iteração de treinamento. O processo exige grandes volumes de dados, muitos ciclos de atualização e acesso constante ao ambiente ou a um conjunto de validação.
A Weight-Space Programming propõe um atalho: em vez de milhares de passos de gradiente, um modelo de linguagem potente faz poucas, mas sofisticadas, alterações nos pesos, guiado por raciocínio em linguagem natural e conhecimento acumulado sobre como redes neurais funcionam por dentro. Em alguns experimentos descritos pela equipe, o Astra não tem autorização sequer para rodar a rede em um único exemplo de entrada.
A aposta dos pesquisadores é que, conforme essa capacidade amadureça, grandes LLMs possam se tornar otimizadores gerais de pesos, substituindo ou complementando algoritmos simbólicos tradicionais. “Throughout the history of deep learning, we encoded our simplistic inductive biases into tiny symbolic optimizers like Adam or Muon. This is changing: our neural network weights will soon be natively optimized by LLMs that deliberately reason about their weights”, resume Takehi.
Impacto potencial e próximos passos
Os resultados iniciais empolgam parte da comunidade de pesquisa em IA por apontarem para redes mais interpretáveis, fáceis de ajustar e potencialmente mais eficientes em custo de computação. Setores que dependem de modelos complexos — como assistentes de linguagem, sistemas de recomendação e agentes em jogos — podem ganhar com correções pontuais em vez de longos e caros ciclos de retreinamento.
Por outro lado, se a abordagem se consolidar, métodos de otimização clássicos tendem a perder protagonismo em alguns cenários, o que pode reorientar linhas inteiras de pesquisa focadas exclusivamente em gradientes e heurísticas algorítmicas.
Os pesquisadores indicam que os próximos passos devem incluir testes com modelos maiores, aplicação em tarefas de produção e exploração de cenários em que o próprio modelo cuida de sua auto-otimização contínua. A expectativa é que novas evidências, positivas ou negativas, venham de experimentos independentes ao longo dos próximos meses, à medida que outras equipes tentarem reproduzir e estender o comportamento observado com o Astra.