Buoyant lança Kinference para reduzir latência em Kubernetes
Buoyant lança o Kinference, plano de controle open source para inferência em Kubernetes e vLLM, com roteamento inteligente, limites por tokens e métricas por locatário.
Tecnologia
Buoyant apresenta solução open source para otimizar inferência e desempenho em ambientes Kubernetes com controle avançado.
Leia também: Startup dos EUA limpa propaganda de IA chinesa em novo modelo
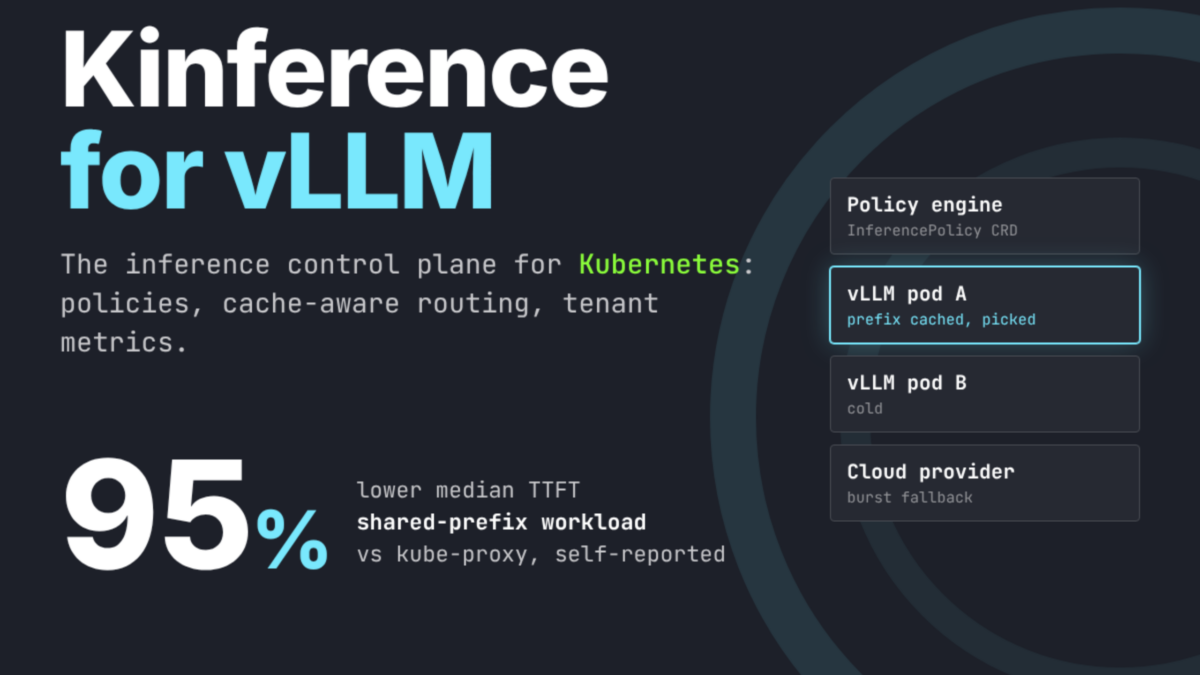
A Buoyant, criadora do Linkerd, lançou o Kinference, uma nova plataforma open source que atua como plano de controle para inferência em ambientes com Kubernetes e vLLM, com foco em cenários multi-inquilino e múltiplos modelos e prometendo cortes expressivos de latência e ganhos de capacidade em produção.
Kinference vira camada de controle acima do vLLM
Na prática, o Kinference se posiciona na frente de um conjunto de workers vLLM para decidir, requisição a requisição, para qual endpoint cada chamada de inferência deve ir. Em documento oficial, a empresa resume: “vLLM é o data plane e Kinference é o control plane”.
O projeto está na versão v0.1.0-alpha.7, com código disponível no GitHub sob licença Apache 2.0. O alvo são equipes que já usam Kubernetes e vLLM para servir modelos de machine learning em larga escala e precisam lidar com vários modelos e vários clientes internos ao mesmo tempo, mantendo isolamento, governança e desempenho.
Em vez de depender do balanceamento aleatório padrão do Kubernetes, o Kinference aplica políticas declarativas para roteamento e rejeição de requisições, considerando locatário, modelo solicitado, estado do pool de GPUs e tags semânticas. O sistema tenta minimizar o tempo até o primeiro token (TTFT) prevendo o tempo de resposta com base em sobreposição de cache e tamanho de fila.
Como funciona a arquitetura do Kinference
O Kinference é composto por duas partes principais: um gateway de tráfego e um handler de inferência com interface gRPC. O handler recebe a requisição, aplica as regras de política e devolve o endpoint escolhido, podendo também ajustar o corpo da chamada antes de encaminhá-la via um proxy compatível, como o Buoyant Gateway.
Para tomar decisões, a plataforma monitora eventos do cache KV do vLLM e métricas do motor de inferência, utilizando a biblioteca dynamo-kv-router da NVIDIA para processar esses eventos. Tudo é configurado com cinco Custom Resource Definitions (CRDs) no Kubernetes: GatewayBackend, InferencePolicy, InferencePool, InferenceProvider e InferenceWorkerSet.
As InferencePolicy concentram a lógica de governança: ali se define, por exemplo, quais modelos um determinado time pode usar, quais pools de GPU serão acessados, quais aliases de modelo apontam para quais versões e quais condições levam a uma rejeição precoce da requisição. As políticas ficam em repositórios Git e podem ser validadas offline com a CLI kinfctl, permitindo revisão de código e auditoria.
Ganhos de latência e capacidade em benchmark próprio
Para demonstrar o impacto dessa camada de controle, a Buoyant publicou benchmarks comparando o Kinference com o balanceamento padrão de um Service ClusterIP em Kubernetes, cenário em que o kube-proxy escolhe um pod de forma aleatória por conexão.
Nos testes, os dois lados usaram o mesmo setup: três pods rodando vLLM 0.31.0, cada um com uma GPU L40S, servindo o modelo Qwen3.8-27B-FP8. A carga foi gerada com GuideLLM 0.8.1, em dois padrões de uso: shared-prefix e multiturn.
Segundo os resultados, a latência mediana end-to-end caiu até 45% no padrão shared-prefix e 32% em multiturn quando o Kinference assumiu o roteamento, mesmo com o cluster já sob pressão. O percentil 95 do TTFT caiu de 21,46 segundos para 12,33 segundos, resultado atribuído ao balanceamento sensível a filas e ao estado do cache.
Na capacidade, medida em requisições por minuto que cumprem um SLO de TTFT, o Kinference atingiu picos de 103,0 requisições por minuto contra 14,0 no baseline em shared-prefix, um ganho de até 7,4 vezes. Em multiturn, o pico foi de 82,7 requisições por minuto contra 23,8 no baseline, cerca de 3,5 vezes mais. No cenário de referência, o Service padrão não chegou a cumprir o SLO em nenhuma das taxas de concorrência testadas.
A própria Buoyant ressalta que esses SLOs são voltados a agentes offline, não a chats em tempo real, e que a comparação foi feita com roteamento aleatório, não com outros roteadores cientes de cache, como llm-d ou Dynamo.
Foco em governança e multi-inquilino
Diferentemente de ferramentas que priorizam apenas desempenho bruto ou suporte ao maior número possível de engines, o Kinference tenta se posicionar como camada de governança para inferência. Além das políticas e aliases, ele oferece fallback entre provedores, limites de taxa por tokens e contabilização detalhada por locatário.
Esse desenho atende sobretudo organizações que rodam vários modelos de código aberto para múltiplos times internos, como áreas de produto, pesquisa e analytics em empresas de tecnologia, fintechs e saúde. Com as métricas segregadas por locatário, fica mais simples imputar custos de GPU e uso de modelos a cada área, apoiar decisões de capacity planning e definir prioridades em períodos de pico.
Profissionais de ciência de dados como Michal Sutter tendem a ser beneficiados indiretamente: a equipe de plataforma passa a ter ferramentas mais finas para controlar filas e cache, enquanto os times consumidores ganham SLAs mais claros e menos instabilidade causada por vizinhos ruidosos em clusters compartilhados.
Instalação integra controle de tráfego e observabilidade
A instalação do Kinference segue um roteiro enxuto em cinco etapas. Primeiro, a equipe aplica os CRDs da Gateway API v1.5.1 ao cluster Kubernetes. Em seguida, instala o Helm chart do Buoyant Gateway e, depois, o chart do próprio Kinference.
O pacote do Kinference já expõe métricas para Prometheus e painéis prontos para Grafana, com indicadores como TTFT, ITL (intervalo até o último token), latência end-to-end e proporção de tokens de prompt cacheados versus não cacheados, em geral segmentados por locatário. Com isso, times de DevOps e SRE conseguem enxergar rapidamente gargalos de GPU, padrões de cache e violações de SLO.
Como o projeto é open source e licenciado sob Apache 2.0, a Buoyant incentiva que a comunidade contribua com novos provedores, políticas, integrações e otimizações. A expectativa é que, à medida que o Kinference amadurece além da fase alfa, receba suporte a mais modelos, interfaces mais amigáveis e aprimoramentos no motor de decisão.
No médio prazo, se os ganhos relatados em governança e desempenho se confirmarem em ambientes reais, o Kinference pode se tornar referência para controle de inferência em clusters Kubernetes que já adotam vLLM como camada de execução.