Google lança TPUs 8tx e 8i Max para IA sigilosa e alta escala
Google amplia linha de aceleradores de IA com os TPUs 8tx, focado em computação confidencial, e 8i Max, voltado a cargas com muita memória, e chega a quatro variantes em um ano.
Tecnologia
Novos TPUs do Google ampliam capacidades para IA confidencial e aplicações de alta memória.
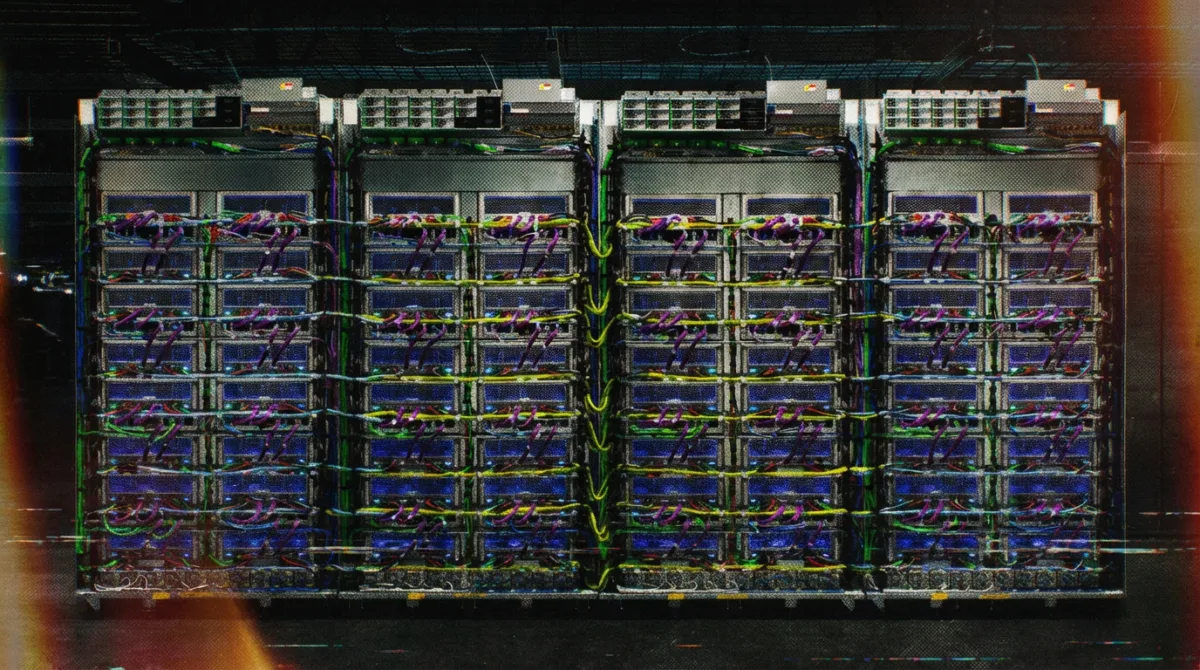
O Google lançou nesta semana duas novas variantes do seu acelerador de IA de oitava geração, o TPU 8tx e o TPU 8i Max, e alcança pela primeira vez a marca de quatro sistemas TPU entregues em um único ano, em uma guinada para transformar seus chips em plataforma comercial para empresas e órgãos públicos.
Google mira dados sigilosos e inferência em larga escala
Os novos sistemas chegam para atender demandas específicas: o TPU 8tx é voltado à computação confidencial, protegendo dados sensíveis e pesos de modelos durante o uso ativo, enquanto o TPU 8i Max dobra a capacidade de computação e memória para cargas de trabalho que esbarram no gargalo de largura de banda. Ambos usam o mesmo silício da oitava geração, mas em embalagens, redes e configurações de memória diferentes, o que permite ao Google criar variantes em meses, sem esperar uma nova geração de chip.
Com a expansão, o Google tenta ganhar espaço em um mercado hoje dominado pela Nvidia, especialmente em inferência — a etapa em que modelos já treinados são executados no dia a dia — e convencer empresas acostumadas às GPUs a considerar seus TPUs como alternativa viável.
TPU 8tx: foco em computação confidencial
O TPU 8tx foi desenhado para empresas e agências governamentais que lidam com dados sigilosos, como bancos, planos de saúde, órgãos de controle e Justiça. A proposta é fechar a brecha de segurança que costuma ocorrer quando os dados precisam ser descriptografados na memória para processamento.
Segundo o Google, no 8tx “dados e pesos do modelo permanecem protegidos e isolados mesmo durante o uso ativo”, o que aproxima o TPU do modelo de computação confidencial que a Nvidia já oferece em algumas GPUs. A proteção vale tanto para os dados de entrada quanto para os parâmetros do modelo, reduzindo o risco de vazamentos em ambientes compartilhados de nuvem.
O sistema usa a rede de baixa latência Boardfly, criada pelo Google para inferência em tempo real, e promete entregar “até duas vezes a redução de latência em comparação com o TPU 8t”, ainda de acordo com a empresa. Na prática, isso significa respostas mais rápidas em aplicações sensíveis, como atendimento automatizado, análise antifraude e tomada de decisão em tempo quase real, sem que os dados precisem circular entre diferentes clusters.
Com esse desenho, o Google afirma que clientes podem fazer fine-tuning (personalização), destilação de modelos grandes em versões menores e treinamento por reforço no mesmo sistema, mantendo os dados sempre dentro do mesmo ambiente protegido.
TPU 8i Max dobra computação e memória
Enquanto o 8tx ataca o problema da segurança, o TPU 8i Max mira o gargalo de memória típico de aplicações em que vários agentes de IA trabalham em paralelo sobre grandes bases de código, longos vídeos ou documentos extensos.
Para isso, o Google integrou dois chips TPU 8i em um único pacote. De acordo com a empresa, “o resultado é o dobro do poder computacional, da memória e da largura de banda no mesmo formato de rack”, o que aumenta significativamente o desempenho por metro quadrado de data center e pode reduzir o custo operacional por tarefa de IA.
Esse perfil interessa especialmente a empresas de tecnologia, plataformas de desenvolvedores e companhias de mídia que rodam modelos grandes o tempo todo, em tarefas como revisão automática de código, geração de conteúdo em vídeo e análise massiva de dados corporativos.
Entenda o contexto
Os lançamentos do TPU 8tx e do 8i Max completam um ciclo em que o Google chegou a quatro variantes de TPU da oitava geração em um ano, algo inédito na história da linha. A estratégia é modular: manter o mesmo processador e variar embalagem, rede e memória para atender nichos específicos com mais rapidez.
Até pouco tempo atrás, os TPUs eram usados principalmente dentro do próprio Google. Agora, a empresa afirma ter quase 100 clientes externos de TPU, entre companhias privadas e órgãos públicos, e passa a tratar os chips como produto estratégico para competir com Nvidia e também com rivais que desenvolvem aceleradores próprios, como Amazon e Microsoft.
Esse movimento acompanha a mudança do foco do mercado de IA: o investimento pesado em treinamento de modelos gigantes segue existindo, mas a prioridade de muitas empresas hoje é a inferência, que ocorre continuamente em aplicações de atendimento, busca, análise de riscos e automação de rotinas.
Software aberto e ecossistema para atrair clientes
Para facilitar a adoção, o Google tem reforçado o lado de software. A empresa abriu o TorchTPU, que permite rodar códigos em PyTorch — um dos frameworks mais usados por desenvolvedores de IA — nos TPUs com poucas modificações. Também há suporte a frameworks de inferência populares, como vLLM e SGLang, voltados a modelos de linguagem em larga escala.
Ao tornar essas ferramentas disponíveis em código aberto, o Google tenta reduzir o atrito de migração de quem hoje roda seus modelos em GPUs tradicionais, encurtar o tempo de testes e ampliar o número de projetos que podem ser levados rapidamente para produção em TPUs.
No médio prazo, a disputa prometida é intensa. Nvidia seguirá defendendo sua liderança com novas gerações de GPUs e recursos de inferência, enquanto grandes empresas de nuvem investem em chips próprios para não depender de um único fornecedor. Para usuários finais, a competição tende a acelerar a oferta de serviços de IA mais eficientes, com custos menores e maior proteção a dados confidenciais, especialmente em setores regulados.