Google testa StreamVibe, assistente de vídeo que fala na hora certa
Pesquisadores do Google e universidades dos EUA criaram o StreamVibe, assistente de vídeo que observa o usuário e decide sozinho quando falar, com ganhos de até 10,7% na qualidade das respostas.
Tecnologia
Novo assistente de vídeo do Google interage de forma inteligente, melhorando a experiência do usuário com respostas mais precisas.
Leia também: Impressora 3D vira aliada para cortar gastos com hobbies
Pesquisadores do Google, de Stanford, de Oxford e de universidades dos Estados Unidos apresentaram o StreamVibe, um assistente de vídeo que observa o usuário em tarefas práticas — como cozinhar ou montar móveis — e decide sozinho quando deve falar para oferecer ajuda, mesmo diante de pedidos vagos ou mudanças de objetivo ao longo da atividade.
Como funciona o assistente de vídeo StreamVibe
No lugar do modelo tradicional, em que o usuário precisa dar comandos muito claros, o StreamVibe foi projetado para entender frases amplas como “me ajuda se eu tiver dificuldades” e acompanhar o andamento da tarefa em tempo real. O sistema analisa o vídeo continuamente e, a cada segundo, escolhe entre permanecer em silêncio ou intervir com uma instrução objetiva.
O coração do projeto é o modelo StreamVibe-VL, baseado no Qwen3.5-9B, da Alibaba. Depois de um primeiro treinamento, os pesquisadores aplicaram aprendizado por reforço para tornar o agente mais contido, reduzindo interrupções desnecessárias. Um sistema de memória separado registra quais pedidos do usuário ainda estão pendentes e quais etapas já foram concluídas, enquanto o modelo principal decide o momento e o conteúdo da fala.
Segundo os autores do estudo, “StreamVibe-VL melhora o tempo e a qualidade das respostas em 10,7% sobre outros modelos”. Já o sistema de memória “aumenta a interação proativa em 12,3% e reduz interrupções desnecessárias”, ao ajudar o agente a não repetir instruções ou perder mudanças de objetivo no meio da tarefa.
Benchmark com 4.100 exemplos e 183 horas de vídeo
Para treinar e avaliar o StreamVibe, o grupo montou um benchmark específico para o problema da “fala na hora certa”. A base reúne cerca de 4.100 exemplos extraídos de mais de 183 horas de gravações de situações do dia a dia e uso de software.
Cada exemplo descreve um cenário em que o assistente precisa decidir se deve intervir e o que dizer, passando por três tipos de situação: instruções claras, metas vagas e pedidos que mudam com o tempo. Todas as sugestões de resposta foram revisadas por quatro avaliadores humanos antes de entrar na base.
Um caso citado pelos pesquisadores é o de uma pessoa desmontando um brinquedo e pedindo atualizações de progresso. Depois de alguns minutos, o usuário muda a solicitação para um “check-up” de qualidade, e o agente precisa perceber essa alteração e ajustar o tipo de ajuda que oferece.
Exemplos práticos em cozinha e edição de imagens
Nos testes, o StreamVibe-VL superou seu modelo-base e outros sistemas abertos em cenários práticos. Em um tutorial de GIMP para converter uma foto em preto e branco, um assistente de comparação erra e afirma que a imagem já foi salva, mesmo sem o usuário ter aberto o arquivo. O StreamVibe, por outro lado, indica o próximo passo no momento certo, sugerindo que a pessoa clique em “Colors” e depois em “Desaturate”.
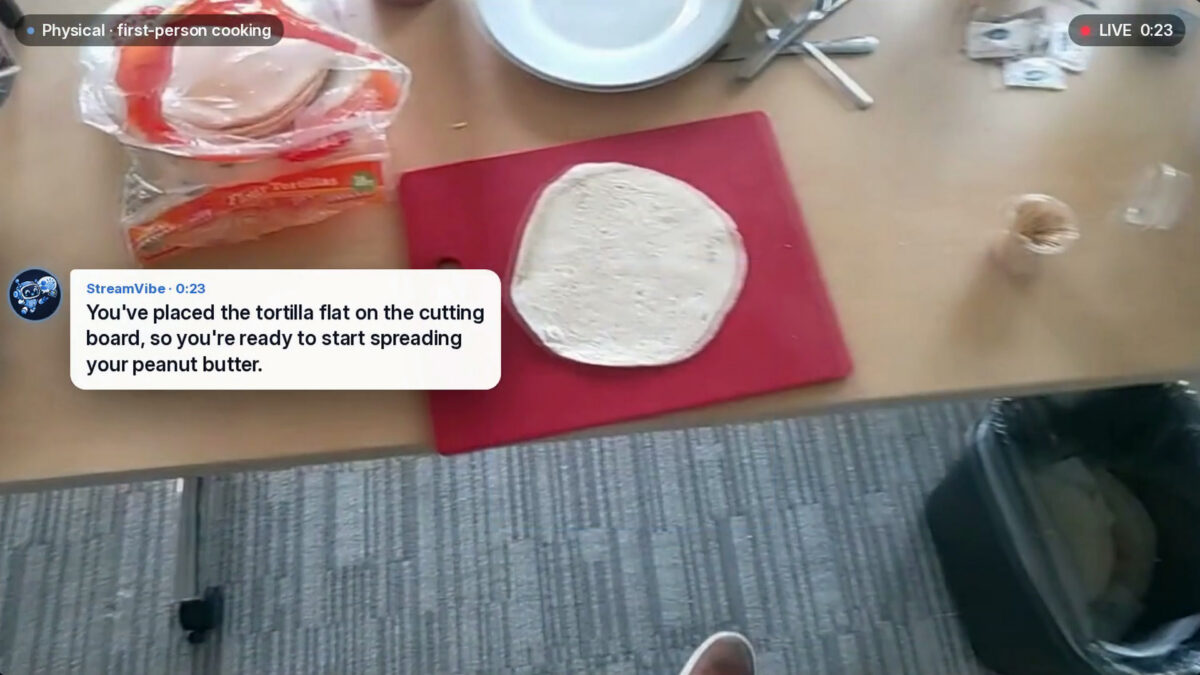
Em uma receita de torrada enrolada com geleia, outros modelos se limitam a narrar o que acontece na tela — como o pão sendo achatado. O StreamVibe-VL orienta uma ação útil antes disso, sugerindo cortar a borda do pão, aproximando a interação de uma ajuda real de cozinha.
De acordo com o time de pesquisa, o assistente é “projetado para entender o que está acontecendo a qualquer momento e reconhecer quando sua ajuda é realmente necessária”, algo que os sistemas atuais ainda fazem com dificuldade, sobretudo quando o usuário muda de ideia no meio do processo.
Entenda o contexto
Assistentes de vídeo disponíveis hoje em celulares, smart displays e computadores costumam depender de comandos muito específicos: avisar quando a água ferver, pausar um vídeo em um ponto exato, repetir um trecho de receita. Eles raramente interpretam intenções implícitas, têm dificuldade para acompanhar o progresso de uma tarefa e tendem a se prender à primeira instrução recebida, mesmo se o usuário mudar o pedido.
O StreamVibe tenta atacar justamente esses pontos. Ao combinar visão computacional com linguagem natural e memória de longo prazo, o sistema busca oferecer um tipo de companhia mais fluida: o usuário deixa um pedido geral no início — como “me avisa se eu fizer algo errado” — e o agente assume o papel de observador atento, intervindo apenas quando julga necessário.
A pesquisa se encaixa em uma linha mais ampla de desenvolvimento de agentes de vídeo autônomos pelo Google, que inclui sistemas como o Gemini 3.8 Flash e modelos voltados a robótica, capazes de acompanhar sequências longas de ações e identificar erros em tempo real.
Limitações em vídeos longos e histórico de conversa
Apesar dos avanços, os próprios resultados mostram que o problema está longe de resolvido. Quando os modelos precisam analisar um vídeo inteiro e construir novas respostas com base nas interações anteriores, o desempenho cai de forma acentuada.
Os pesquisadores relatam que há “queda de até 61,5% na qualidade das respostas quando [os modelos] precisam construir interações baseadas em histórico”, à medida que pequenos erros vão se acumulando ao longo da conversa. Em gravações com mais de cinco minutos, os agentes quase nunca escolhem o momento ideal para falar e têm dificuldade especial em acompanhar mudanças de instruções espalhadas pelo tempo.
Além disso, o StreamVibe-VL, embora supere outros modelos de código aberto, ainda fica atrás do Gemini 3.8 Flash em parte dos testes internos, o que indica espaço para melhorias em raciocínio espacial, compreensão temporal e capacidade de pedir informações extras quando o que aparece no vídeo não é suficiente.
Próximos passos e impacto no dia a dia
Os autores afirmam que sistemas como o StreamVibe ainda são simplificações da vida real, onde o ambiente é mais caótico e as tarefas se misturam. A ideia agora é investigar como preferências individuais — como o nível de proatividade desejado — e fatores do ambiente influenciam a dinâmica de interação ao longo do tempo.
Na prática, a tecnologia abre caminho para assistentes mais úteis em várias áreas: tutoriais em vídeo, suporte remoto para manutenção doméstica, ensino prático à distância, treinamento profissional e até acompanhamento de tarefas de pessoas idosas ou com pouca familiaridade com tecnologia. Setores que hoje dependem de instruções em vídeo estáticas podem migrar para experiências interativas, em que o sistema observa, intervém e adapta as orientações ao ritmo do usuário.
Ao mesmo tempo, modelos que não combinam visão, memória e decisão autônoma tendem a perder relevância à medida que cresce a expectativa por interações mais naturais. A colaboração entre Google, Stanford, Oxford e outras instituições indica que a corrida por agentes de vídeo mais inteligentes deve se intensificar, com impacto direto no mercado de inteligência artificial aplicada ao cotidiano.