IBM lança Granite Speech 5.0 2B para transcrição avançada
IBM apresenta o Granite Speech 5.0 2B, modelo aberto de fala para texto e tradução em seis idiomas, com foco em alta precisão, baixa latência e ampla compatibilidade para desenvolvedores.
Tecnologia
IBM revela modelo inovador para transcrição e tradução em múltiplos idiomas, otimizando precisão e velocidade.
Leia também: Recursive lança Flint, modelo local de IA para programação
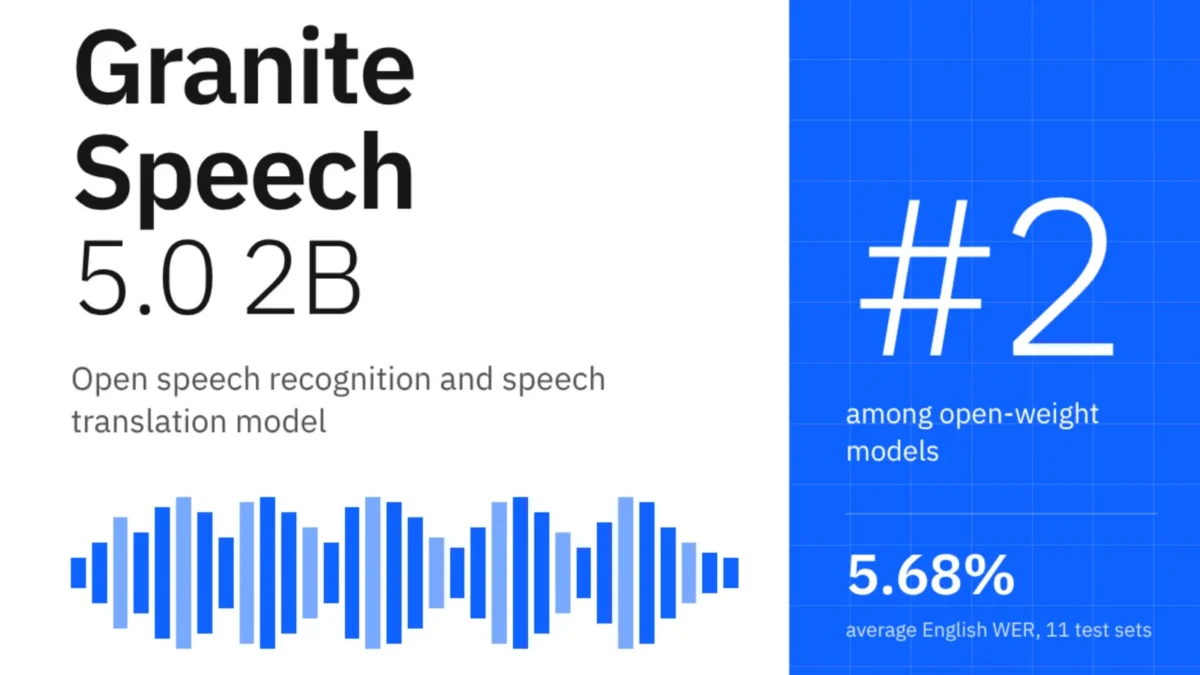
A IBM lançou nesta semana o Granite Speech 5.0 2B, um modelo aberto de transcrição e tradução de fala com 2 bilhões de parâmetros, capaz de operar em seis idiomas com alta precisão e voltado tanto para uso em nuvem quanto em dispositivos locais, em plataformas como Transformers, vLLM, llama.cpp e mlx-audio.
Modelo foca em precisão, velocidade e flexibilidade
O Granite Speech 5.0 2B foi treinado com 390.000 horas de áudio público e dados sintéticos, em um processo de 40 dias usando oito GPUs H100. O objetivo é entregar um sistema que transcreve e traduz fala com baixo índice de erros e boa robustez em diferentes cenários, de ligações de call center a legendagem automática.
Na prática, o modelo converte áudio em texto em seis idiomas e faz tradução, com desempenho competitivo em benchmarks públicos e privados. No Open ASR Leaderboard, a média de Word Error Rate (WER) em inglês é de 5,68%, considerando 11 conjuntos de teste. Em cenários específicos, a variação é ampla: 0,99% de WER no LibriSpeech Clean, 2,21% no LibriSpeech Other e 13,79% em um conjunto privado de conversação.
Em ambientes ruidosos, o Granite Speech 5.0 2B ocupa a 4ª posição entre 42 modelos no leaderboard FFASR, com WER médio de 14,80%. Em transcrição multilíngue, os resultados no CommonVoice mostram 2,60% de WER para português, 3,50% para espanhol e 10,74% para japonês, hoje o idioma com pior desempenho dentro do pacote.
Na tarefa de tradução X-to-English baseada no conjunto CoVoST, o modelo alcança pontuação BLEU de 53,6 para português e 40,1 para alemão. A tradução para mandarim ainda não foi avaliada.
Como o Granite Speech 5.0 2B é construído
A arquitetura do Granite Speech 5.0 2B é dividida em três blocos principais. O primeiro é um codificador de fala com 16 blocos Conformer, treinado com o critério CTC e atenção em blocos de áudio de 4 segundos. Ele transforma o sinal acústico contínuo em representações numéricas mais manejáveis.
Em seguida, um q-former de duas camadas projeta e reduz em 10 vezes a resolução das embeddings acústicas, permitindo que o modelo de linguagem opere a 10 Hz sem perder o contexto relevante do áudio. O terceiro componente é um modelo de linguagem estendido para 16 mil posições com a técnica YaRN e ajustado com adaptadores LoRA, o que aumenta a capacidade de lidar com áudios longos sem fragmentar a transcrição.
A IBM recomenda, para execução em formato GGUF, o uso de quantização Q8_0. Configurações mais agressivas de compressão tendem a degradar a precisão em áudios com mais de um minuto, o que limita a aplicação em reuniões, aulas remotas e transmissões longas.
Entenda o contexto
O lançamento chega em um momento de forte demanda por sistemas de voz mais flexíveis, capazes de rodar tanto em grandes data centers quanto em dispositivos de borda, como caixas de som inteligentes, telefones corporativos e call centers locais. Ao optar por uma licença Apache 2.0, a IBM libera o uso comercial, a modificação e a integração do Granite Speech 5.0 2B em produtos de terceiros sem cobrança de royalties.
Isso inclui desde startups que buscam reduzir custos com serviços proprietários até grandes empresas de tecnologia, educação e mídia interessadas em controlar melhor dados sensíveis de áudio. A abertura também tende a acelerar pesquisas sobre reconhecimento de fala em idiomas menos atendidos e em cenários desafiadores, como ruído intenso e sobreposição de falas.
Quais melhorias chegam com Turbo CTC e 4.1 2B Plus?
Além do novo modelo principal, a IBM atualizou dois sistemas da família Granite Speech: o Turbo CTC, focado em uso em borda, e o 4.1 2B Plus, especializado em atribuição de falantes e transcrições longas.
O Granite Speech Turbo CTC mantém seus 470 milhões de parâmetros, mas passa a transcrever sete idiomas com pontuação e capitalização nativas. Uma das principais otimizações foi a compilação de um bloco Conformer e o reuso desse grafo ao longo da pilha, o que elevou a taxa de processamento em tempo real (RTFx) de cerca de 12.600 para 19.870. A mudança mira aplicações que precisam de resposta quase instantânea e baixo consumo de recursos, como dispositivos embarcados e aplicações móveis.
O Granite Speech 4.1 2B Plus recebeu uma atualização de pesos de modelo, sem mudança na arquitetura, com foco em qualidade de timestamps e em transcrições longas sensíveis a palavras-chave. De acordo com os dados divulgados, o “Average timestamp shift falls from 210.86 to 98.54”, o que reduz pela metade, em média, o desvio entre o momento real da fala e o tempo marcado na transcrição.
Nos testes com áudios extensos, o “Long-form WER drops from 13.53 to 10.22”, um avanço relevante para reuniões, audiências e conteúdos de longa duração. Já em cenários que usam listas de termos prioritários, o “Biased-keyword WER falls from 11.79 to 6.48”, indicando ganho expressivo na captura correta de nomes próprios, marcas e jargões específicos.
Keyword biasing e impacto para empresas
Uma das funcionalidades mais relevantes para uso corporativo é o biasing de palavras-chave, que ensina o modelo a prestar atenção especial a termos pré-definidos. Em um dos testes de referência, o F1 de palavras-chave em Earnings-22, que reúne chamadas de resultados de empresas, mostra que “Keyword F1 rises from 67.2 to 90.1 with correct keyword lists”. Mesmo com listas de até 2.000 termos misturando itens corretos e incorretos, o índice se mantém em 82,8.
Na prática, isso significa que empresas de atendimento ao cliente, finanças, jurídico e saúde conseguem extrair com muito mais confiança menções a produtos, cláusulas contratuais, medicamentos e outros termos críticos, reduzindo o trabalho manual de conferência e anotação.
Uso aberto e competição com modelos proprietários
Liberado sob licença Apache 2.0, o Granite Speech 5.0 2B pode ser incorporado em produtos comerciais, customizado para nichos e integrado a pipelines já existentes sem a necessidade de contratos de uso de API. Essa postura pressiona fornecedores de soluções proprietárias de reconhecimento de fala e tradução a rever preços e funcionalidades.
Aplicações em setores de comunicação, legendagem, monitoramento de mídias, assistentes virtuais e educação tendem a se beneficiar da combinação de alta precisão, suporte multilíngue e execução local, que reduz a dependência de transmissão de áudio sensível para servidores externos.
Asif Razzaq, CEO da Marktechpost AI Media Inc., tem destacado o potencial social desse tipo de tecnologia, apontando para o uso em acessibilidade, inclusão linguística e disseminação de conhecimento técnico para públicos mais amplos. A perspectiva é que desenvolvedores e empresas comecem rapidamente a testar e integrar o Granite Speech 5.0 2B, enquanto a IBM segue refinando o desempenho em idiomas mais difíceis, como japonês, e em cenários de ruído intenso.
Fonte: matéria original