IBM lança Granite Timeseries Ensemble com 4 modelos pré-treinados
IBM Research apresenta o Granite Timeseries Ensemble, que combina quatro modelos pré-treinados para previsão probabilística de séries temporais, sem re-treinamento nem ajuste de pesos, disponível via Hugging Face.
Tecnologia
IBM Research lança solução inovadora para previsão probabilística de séries temporais sem necessidade de re-treinamento.
Leia também: Recursive lança Flint, modelo local de IA para programação
IBM Research lançou nesta semana o Granite Timeseries Ensemble, uma solução de previsão de séries temporais que combina quatro modelos pré-treinados Granite em um único pacote e promete reduzir a escolha de arquitetura a um “padrão sensato”, sem necessidade de re-treinamento nem ajuste de pesos.
Nova abordagem para pre-trained time series models
O ensemble foi projetado para aplicações industriais e comerciais que dependem de previsões confiáveis, como manufatura, varejo, energia e finanças, onde diferentes séries exibem desde sinais suaves até demandas ruidosas e fortes padrões sazonais. “Pre-trained time-series models can forecast without training on your dataset, but you still have to choose one”, resume a equipe da IBM Research. “Granite Timeseries Ensemble reduces that choice to a sensible default.”
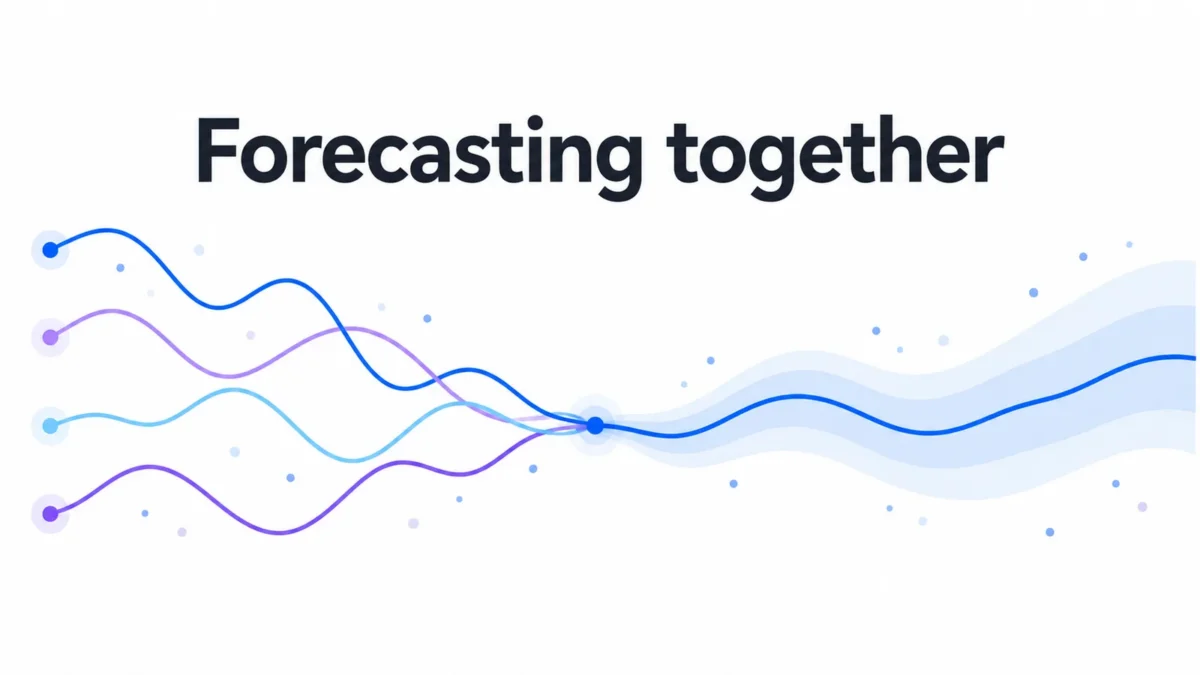
A solução se inspira no uso de ensemble forecasting em meteorologia: em vez de apostar em um único modelo, o sistema combina arquiteturas complementares para capturar tendências, sazonalidade e variações locais de formas diferentes, reduzindo o risco de apostar no modelo “errado” para cada tipo de dado.
Os quatro modelos pré-treinados — com arquiteturas PatchTST, duas variações PatchTST-FM (r1 e r2), FlowState e Tiny Time Mixers — estão disponíveis no Hugging Face e são orquestrados pelo pacote Granite TSFM. Na prática, o usuário instala o pacote, escolhe a receita de ensemble e passa a receber, em uma única chamada, previsões pontuais e probabilísticas, com quantis padrão de 0,1 a 0,9.
Como funciona o Granite Timeseries Ensemble
O Granite Timeseries Ensemble é distribuído como uma receita que guarda a configuração do conjunto, e não pesos mesclados dos modelos. Ao ser carregado, o pacote Granite TSFM baixa em tempo de execução os quatro checkpoints pré-treinados, o que pode tornar a primeira execução mais lenta. Depois disso, o ensemble gera tanto um valor central (point forecast) quanto a distribuição de quantis, permitindo formar intervalos de confiança — por exemplo, um intervalo central de 80% entre os quantis 0,1 e 0,9.
A IBM Research destaca que tudo isso é feito sem qualquer etapa de fitting ou tuning. Nem os modelos individuais nem o método de combinação precisam ser ajustados aos dados do usuário, o que reduz drasticamente o tempo de implantação e o custo operacional de manter pipelines de previsão.
Em vez de exigir que o time técnico teste diferentes arquiteturas e defina manualmente pesos para combiná-las, o ensemble oferece um fluxo único e extensível: a mesma interface aceita outros modelos compatíveis, permitindo que empresas incluam, no futuro, arquiteturas próprias ou de terceiros sem reescrever o restante da pilha de previsão.
Duas receitas: Probabilistic Ensemble e IQR Ensemble
A combinação das previsões probabilísticas dos quatro membros é feita por duas receitas principais. A primeira, recomendada como ponto de partida, é a Probabilistic Ensemble. “The Probabilistic Ensemble (uniform probability pooling) gives each member equal influence, pools their quantile forecasts in probability space, and extracts the requested quantiles from the combined values”, explica a IBM Research. Como os pesos são fixos, não há hiperparâmetros de ponderação a ajustar série a série.
A segunda receita é a IQR Ensemble, que tenta explorar a dispersão das previsões. “The IQR Ensemble weights members according to their forecast spread, giving narrower intervals greater influence”, diz a equipe. A ideia é aproximar o intervalo interquartil (IQR) de cada modelo a partir dos quantis disponíveis próximos a 25% e 75%. Modelos com intervalos mais estreitos ganham mais peso em cada amostra, alvo e horizonte de previsão; ainda assim, não há treinamento baseado em erros passados.
A IBM Research, porém, alerta para o risco de sobreconfiança: intervalos estreitos não significam necessariamente previsões melhor calibradas. Para quem quiser experimentar, a receita IQR oferece um parâmetro de “temperatura”, que aproxima os pesos do caso uniforme, e um teto opcional para limitar o peso máximo de qualquer membro.
A recomendação prática é clara: “Start with the Probabilistic Ensemble. If forecast spread looks informative for your application, compare the IQR Ensemble against it on representative data.” Ou seja, o ensemble uniforme funciona como padrão, enquanto a versão baseada em IQR deve ser validada com dados que representem bem o ambiente de produção.
Entenda o contexto
Modelos pré-treinados para séries temporais — os chamados pre-trained time series models — vêm ganhando espaço justamente por dispensarem treinamento pesado em dados proprietários. O desafio, até agora, era escolher a arquitetura certa para cada cenário: um modelo que funciona bem em sinais industriais suaves pode ir mal em demandas de varejo com ruído intenso ou em séries com horizonte sazonal longo.
Ao combinar arquiteturas como PatchTST, PatchTST-FM, FlowState e Tiny Time Mixers, que tratam tendências e sazonalidade de formas distintas, o Granite Timeseries Ensemble procura entregar previsões robustas em um amplo espectro de casos, reduzindo a dependência de especialistas em modelagem. Para times de negócio, a vantagem direta é menor esforço para chegar a previsões utilizáveis; para engenheiros e cientistas de dados, menos tempo gasto em comparar dezenas de modelos de base.
Avaliação em 97 configurações e impacto para empresas
Para validar a abordagem, a IBM Research avaliou as duas receitas do ensemble em 97 configurações do conjunto de dados GIFT-Eval, usando métricas voltadas a previsões de séries temporais: MASE para erros pontuais e CRPS/MWQL para previsões probabilísticas. Os resultados, capturados em 20 de outubro de 2026, indicam que ambas as receitas superam, em média, os quatro modelos individuais em MASE e em ranking médio de MASE.
Nessa comparação, o Probabilistic Ensemble alcança o menor MASE entre as seis previsões analisadas (os quatro modelos isolados e os dois ensembles), com pequena margem sobre o melhor membro individual, e se destaca pela robustez: entrega desempenho tão bom ou melhor sem exigir que o usuário saiba de antemão qual arquitetura combina mais com seus dados. Já no campo probabilístico, o PatchTST-FM-r2 segue com o menor CRPS/MWQL agregado, enquanto a IQR Ensemble obtém o melhor ranking médio de CRPS, mostrando que a escolha pode variar conforme a prioridade seja erro médio ou posição relativa frente a outros sistemas.
Na fotografia de 20 de outubro, a abordagem de ensemble aparece em terceiro lugar entre os sistemas elegíveis do GIFT-Eval em ranking médio de MASE e de CRPS. A IBM Research reconhece que não se trata de “topar” o ranking em todos os cenários, mas de entregar um padrão forte e consistente, com licença permissiva, pronto para uso e sem ajuste fino.
Para empresas que operam previsões de consumo, produção, risco de crédito ou balanço entre oferta e demanda de energia, o ganho está menos em um recorde de benchmark e mais na combinação de robustez, simplicidade operacional e previsões probabilísticas calibráveis. Os intervalos de confiança derivados dos quantis permitem, por exemplo, planejar estoques considerando tanto o cenário mais provável quanto caudas de risco, facilitando a gestão de incerteza.
Extensibilidade, limites e próximos passos
O pacote Granite TSFM aceita, pela mesma interface, outros modelos compatíveis além dos quatro Granite padrão, o que abre espaço para que desenvolvedores incorporem arquiteturas específicas de domínio sem alterar o formato de saída. Há também receitas expandidas que adicionam checkpoints adicionais da IBM Research, sob licenças mais restritivas, o que exige atenção às condições de uso em ambientes comerciais.
Entre as limitações atuais, a IBM Research aponta que o ensemble trata canais multivariados de forma independente, sem explorar relações entre variáveis correlacionadas, e que carregar quatro checkpoints aumenta tempo de inferência e uso de memória em comparação com um modelo único. Diferenças de contexto, horizonte de previsão, pré-processamento e forma de lidar com dados faltantes entre os membros também podem afetar o comportamento em produção.
A instituição recomenda que usuários façam backtests com dados representativos para avaliar acurácia, calibração, latência e adequação das receitas ao próprio ambiente, além de manter monitoramento constante para lidar com mudanças de padrão nas séries. A expectativa é que, a partir desse primeiro passo, soluções baseadas em Granite Timeseries Ensemble evoluam para incorporar aprendizado contínuo e adaptação automática, enquanto concorrentes devem acelerar ofertas semelhantes em pre-trained time series models.
Fonte: matéria original