IBM lança IA local que cria apresentações sob medida e segura
IBM Research apresenta o Palette, modelo de 20 bilhões de parâmetros que gera apresentações visuais no padrão da IBM Design Language, com mais controle, segurança e desempenho de modelos de ponta.
Inteligência Artificial
IBM apresenta modelo avançado que personaliza apresentações com maior segurança e eficiência.
Leia também: O que o C realmente significa na porta USB-C e por que importa
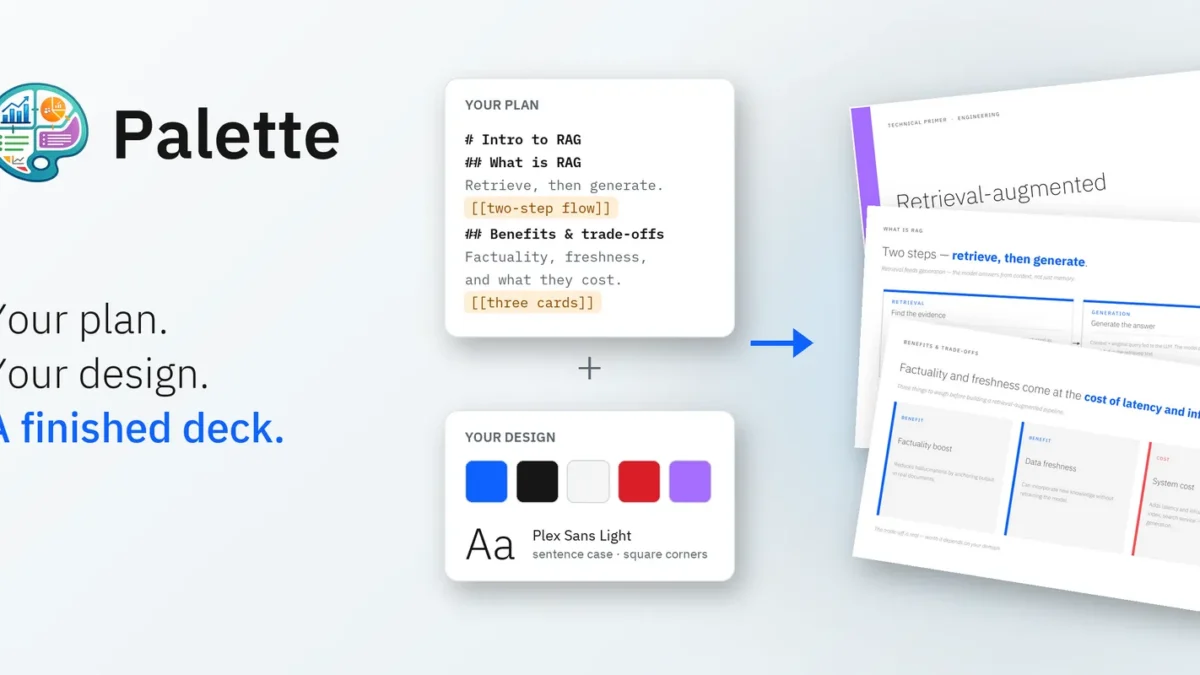
A IBM Research está testando o Palette, um modelo pequeno de inteligência artificial de 20 bilhões de parâmetros criado para gerar apresentações visuais inteiras no estilo personalizado do usuário, com controle detalhado de layout e sem depender de serviços em nuvem, o que reduz riscos de exposição de dados confidenciais.
Modelo pequeno, controle total e olho no design
Ao contrário de sistemas de IA grandes, que tendem a impor um “estilo próprio” aos slides e são pouco maleáveis a templates específicos, o Palette foi pensado para seguir à risca a linguagem visual de cada organização. Nos testes atuais, ele é treinado para obedecer à IBM Design Language, gerando decks de slides que replicam cores, tipografia e padrões de layout internos.
O modelo roda com pesos abertos em infraestrutura local da IBM, o que permite a empresas sensíveis a sigilo produzir apresentações com dados internos sem que o conteúdo saia de seus próprios servidores. A proposta mira diretamente corporações, consultorias, equipes de marketing e educação que produzem grandes volumes de apresentações e precisam de consistência visual e proteção de informação.
O desafio técnico é que modelos pequenos costumam falhar justamente onde o design é mais crítico: títulos que somem no fundo, textos que ultrapassam a borda do slide e formas sobrepostas. Segundo a equipe, o Palette contorna esse problema ao dividir o processo criativo em duas funções especializadas, que imitam o fluxo de trabalho humano.
Como funciona o Palette
No núcleo do projeto está um único modelo base ajustado com um adaptador LoRA, responsável por operar em dois “papéis”: o designer e o codificador. O designer decide a narrativa e o conteúdo de cada slide — quantas páginas o deck terá, o que vai em cada uma e se a informação vira gráfico, tabela ou texto. Já o codificador não opina sobre conteúdo; ele se concentra na geometria, escrevendo o código que posiciona títulos, caixas de texto, gráficos e outros elementos com coordenadas exatas, tamanhos e fontes.
Essa separação reduz a carga cognitiva do modelo em cada etapa. Primeiro, o designer fixa o plano completo do deck; depois, o codificador gera o código de todos os slides em paralelo, o que torna essa segunda fase de geração de layout de 6 a 7 vezes mais rápida, de acordo com os pesquisadores.
Na prática, o raciocínio do designer envolve escolhas editoriais. Em um dos exemplos usados no treinamento, a IA explica: “Revenue for four quarters, with one clear upward trend. I considered a table, but the point of this slide is the trend, not the exact figures, so a bar chart makes it visible at a glance.” O codificador, por sua vez, justifica decisões de espaço e tipografia: “The title is 62 characters. At 44pt it would wrap to three lines and run into the chart below, so I set it at 36pt, which fits on two lines and leaves room above the chart.”
Todo esse comportamento é ensinado por meio do adaptador LoRA, em vez de uma reformulação completa do modelo, o que torna os experimentos mais baratos e preserva o conhecimento geral já presente no modelo base. Como os exemplos de codificação são cerca de cinco vezes mais longos que os de design, a equipe precisou dar ao designer cinco vezes mais exemplos para evitar que essa habilidade ficasse subtreinada.
Entenda o contexto
Ferramentas generativas mais avançadas já conseguem produzir apresentações a partir de textos, documentos ou pedidos simples, mas, em geral, imprimem um “jeito de IA” aos slides: paleta de cores, fontes e estruturas que se repetem, independentemente do template da empresa. Além disso, essas soluções costumam rodar apenas na nuvem, o que é um impeditivo para setores que lidam com dados sigilosos.
Do outro lado, modelos menores e abertos, que podem ser rodados internamente, até geram código de apresentação, mas tropeçam na matemática do layout, produzindo erros visuais que exigem muitas correções manuais. O Palette tenta ocupar o meio-termo: ser pequeno o suficiente para rodar localmente e, ao mesmo tempo, competitivo em qualidade com sistemas de ponta.
Como o Palette foi treinado
Como não existe um banco público que traga, ao mesmo tempo, planos de apresentação, decisões de design e código de layout, a IBM Research recorreu a dados sintéticos. Um modelo maior, aberto, atuou como “professor”, gerando cerca de 1.000 decks cobrindo aproximadamente 10.000 slides, todos no padrão da IBM Design Language.
Cada deck parte de uma espécie de receita, que define gênero da apresentação, tamanho, tipos de layout e diretrizes do usuário. A partir disso, o professor produz o plano do deck, as escolhas de design e o código dos slides. Esses exemplos incluem raciocínios contrafactuais: textos que explicam por que uma opção foi escolhida e outra rejeitada, ensinando não só o que fazer, mas a regra por trás da decisão.
O volume de dados é turbinado por um ciclo automático de verificação. Após gerar um deck, o sistema renderiza cada slide, procura problemas como sobreposição de elementos, textos cortados ou saindo dos limites, corrige esses defeitos e reescreve o raciocínio explicando o erro original e por que a correção é melhor. Cada falha detectada se transforma, assim, em um exemplo de treinamento mais rico, alimentando um ciclo de melhoria contínua.
Um ponto considerado crítico pela equipe é a fidelidade ao conteúdo de origem. Slides que inventam dados ou preenchem tabelas com informações inexistentes são classificados como falhas graves. A solução encontrada passou menos por escrever regras de uso e mais por mostrar exemplos de referência: ao ajustar diretamente esses decks de referência, o modelo professor passava a imitá-los com mais precisão, reduzindo “alucinações” nos slides gerados.
Personalização fina e comandos no plano
Além de seguir a linguagem visual da IBM de forma global, o Palette aceita ajustes locais de design por meio de pequenas instruções, chamadas de diretivas, inseridas diretamente no plano do deck entre colchetes duplos, como [[make this a timeline]]. Essas diretivas podem pedir, por exemplo, que um conjunto de marcos seja exibido como linha do tempo em vez de tabela, alterar cores específicas ou escurecer a capa.
No treinamento, essas diretivas foram incluídas em receitas de dados em 12 categorias diferentes e redigidas de múltiplas formas, para que o modelo aprenda a intenção por trás do pedido, e não apenas frases exatas. O designer incorpora a diretiva ao brief; o codificador a respeita ao desenhar o slide, o que permite mudanças cirúrgicas sem regenerar toda a apresentação.
Camada de checagem corrige erros antes do usuário
Mesmo com treinamento especializado, a equipe admite que o modelo ainda pode produzir slides quebrados. Por isso, o Palette não entrega diretamente o que o modelo gera: há uma “cinta” de segurança em torno dele, um conjunto de verificações e reparos automáticos que avaliam cada slide antes que o deck chegue ao usuário.
Essa camada aplica primeiro correções simples, como arrumar códigos de cor malformados que poderiam deixar todos os slides pretos. Em seguida, cada página é renderizada e medida por um verificador de geometria, que sinaliza textos sobrepostos, cortados ou que escapam dos limites. Quando algo é detectado, o slide é enviado a um modelo editor separado, que reescreve o código daquela página.
Só são aceitas as correções que melhoram de fato o resultado. A mesma ferramenta de checagem compara as versões original e ajustada e só mantém o reparo se o slide ficar objetivamente melhor; caso contrário, o código inicial é preservado. Isso torna seguro rodar esse processo em todos os decks, sem risco de piorar um slide que já estava bom.
Nos testes internos com a base de apresentações do PresentBench, essa camada de reparo adicionou, em média, 3,5 pontos às notas dos decks em uma escala que avalia fundamentos, design visual, completude, correção e fidelidade ao conteúdo de origem.
Desempenho em benchmarks e impacto no mercado
Na avaliação com o PresentBench, o Palette foi comparado a sistemas conhecidos de geração de apresentações e organização de informações. Usando um modelo de ponta separado apenas para transformar documentos em planos de deck, e deixando a geração dos slides para o Palette, a solução da IBM Research alcançou o primeiro lugar em dois dos três domínios medidos: Economia e Educação, em que a precisão numérica e a estruturação do conteúdo pesam mais na nota.
No domínio voltado a apresentações mais narrativas, focadas em fala, dois sistemas fechados superaram o Palette, que ficou em terceiro. Na média dos três domínios, porém, o modelo de 20 bilhões de parâmetros ficou em segundo lugar, apenas 1,1 ponto abaixo do líder, à frente de outros concorrentes maiores e proprietários.
Para empresas, o recado é que já existe caminho para conciliar geração automática de apresentações com alinhamento estrito a uma linguagem de design própria e execução em infraestrutura local. Para o mercado de IA, o projeto pressiona fornecedores de grandes modelos na nuvem a oferecer alternativas mais customizáveis e com maior controle de dados.
Na comunidade técnica, o uso de um único adaptador LoRA para separar, dentro do mesmo modelo base, as funções de design editorial e codificação geométrica aponta um novo paradigma para aplicações criativas: em vez de pedir que um modelo faça tudo de uma vez, dividir tarefas em estágios especializados, cada um apoiado por dados sintéticos ricos e um ciclo robusto de verificação.
A equipe da IBM Research indica que os próximos passos passam por estender o Palette a outras linguagens de design e casos de uso, além de explorar integrações com plataformas comerciais de produção de conteúdo. A mesma infraestrutura de checagem que hoje corrige os slides está cotada para virar também um sistema de recompensa, guiando o treinamento futuro com sinais automáticos de qualidade, fidelidade e aderência visual.