Manuscrito Voynich: IA tenta decifrar texto antigo e misterioso
Algoritmos apontam hebraico, família turca diz ler 30% do texto e especialistas cobram provas: o que se sabe hoje sobre a nova corrida para decifrar o Manuscrito Voynich.
Inteligência Artificial
Novas tecnologias e debates cercam a tentativa de interpretar o enigmático texto do Manuscrito Voynich.
Leia também: IA decifra carta codificada de Napoleão em apenas 6 horas
Guardado em uma sala controlada da Biblioteca Beinecke, em Yale, o Manuscrito Voynich volta ao centro do debate acadêmico com novas tentativas de decifração que vão de inteligência artificial a uma proposta em turco antigo feita por uma família de pesquisadores amadores.
Qual é o nome do manuscrito medieval que ninguém consegue ler?
O livro enigmático que intriga criptógrafos e linguistas há mais de um século é o Manuscrito Voynich, um manuscrito antigo ilustrado, escrito em um idioma desconhecido e batizado em homenagem ao livreiro e colecionador Wilfrid Voynich, que o adquiriu em 1912 na Europa.
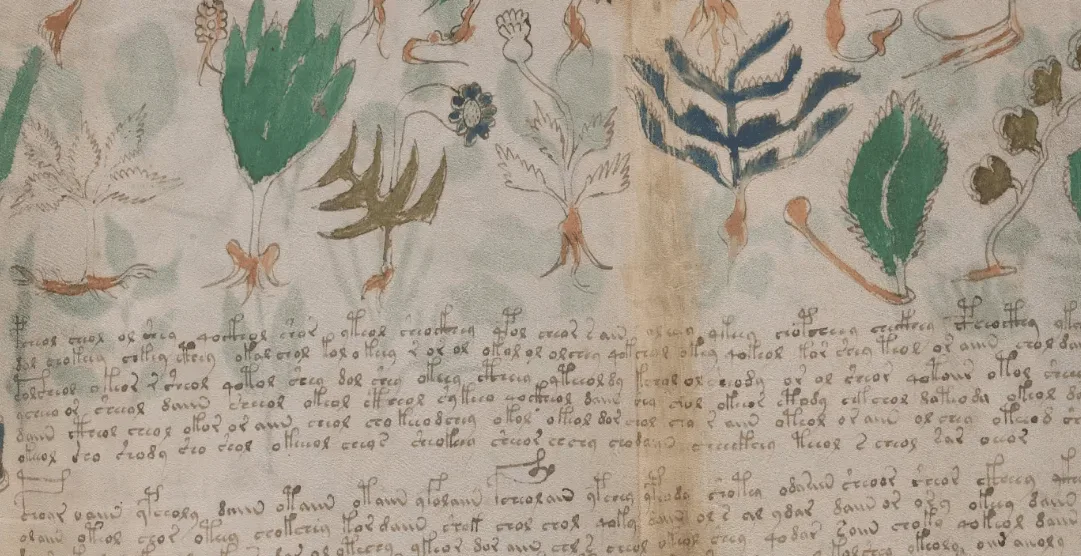
Produzido em pergaminho, o manuscrito tem texto corrido acompanhado de desenhos de plantas, símbolos, figuras humanas e diagramas que ninguém consegue relacionar com segurança a uma língua ou tradição científica específica. Testes de carbono situam o material no início do século XV, e análises da tinta indicam que o conjunto é coerente com esse período, afastando suspeitas de falsificação moderna.
O volume passou por diferentes mãos ao longo dos séculos, desapareceu por cerca de 250 anos e acabou incorporado à coleção de livros raros de Yale. Desde que veio a público, mobiliza desde criptógrafos militares até curiosos na internet — e nenhuma solução proposta resistiu, até agora, ao escrutínio de especialistas.
Entenda o contexto
O enigma central do Manuscrito Voynich está na combinação de três fatores: um alfabeto próprio, que não corresponde diretamente a nenhum sistema conhecido; a aparente estrutura linguística do texto, que lembra uma língua real e não um amontoado aleatório de símbolos; e ilustrações que sugerem conteúdos de botânica, astronomia, medicina e possivelmente rituais ou crenças da época.
Esse conjunto fez surgir teorias extremas: de que o livro seria uma obra científica avançada de um gênio renascentista até a ideia de que tudo não passa de uma fraude elaborada, criada apenas para enganar colecionadores. A datação do pergaminho e da tinta, no entanto, reforça a hipótese de um documento autêntico do início do século XV, ainda que sua autoria e propósito sigam desconhecidos.
O manuscrito Voynich já foi decifrado pela inteligência artificial?
Não. Sistemas de inteligência artificial já produziram hipóteses sobre o idioma e até frases-teste do Manuscrito Voynich, mas nenhuma tradução é considerada comprovada pela comunidade científica.
O caso mais citado é o trabalho do professor Greg Kondrak e do então pós-graduando Bradley Hauer, da Universidade de Alberta, no Canadá. Eles montaram um experimento em que a Declaração Universal dos Direitos Humanos foi traduzida para 380 idiomas e usada como base de treinamento para algoritmos estatísticos capazes de identificar padrões linguísticos.
Nos testes, o sistema conseguiu apontar o idioma correto em até 97% dos casos. Aplicado ao Manuscrito Voynich, o modelo indicou que o texto original estaria em hebraico. A partir daí, os pesquisadores apresentaram uma frase inicial que, segundo o algoritmo, poderia ser lida como: “Ela fez recomendações ao padre, ao chefe da casa, a mim e a outras pessoas”.
Apesar do impacto da descoberta, especialistas em línguas antigas e em criptografia textual reagiram com cautela. O principal ponto de crítica é que o método exige diversas suposições sobre substituições de letras, remoção de vogais e reordenação de termos, o que abre espaço para encaixar quase qualquer frase em padrões desejados.
Davis, estudiosa do manuscrito, resume a exigência da área: “Para que uma teoria se sustente, ela deve ser avaliada, ser replicável por outros estudiosos e resultar em algo que faça sentido.” Até o momento, a hipótese do hebraico ainda não passou por validações independentes amplamente aceitas.
Como pesquisadores tentam traduzir o manuscrito Voynich?
As tentativas de decifrar o Manuscrito Voynich hoje misturam técnicas tradicionais de criptografia, linguística histórica e ferramentas de inteligência artificial. Parte dos grupos trabalha comparando a distribuição de símbolos e a estrutura das palavras com línguas conhecidas. Outros testam se o texto pode ser um código de substituição — em que cada símbolo corresponde a uma letra ou grupo de letras de outro idioma.
Há ainda esforços focados nas ilustrações: diagramas astrológicos, plantas desenhadas e figuras de mulheres em banhos ou tubos são usados como pistas sobre o vocabulário provável — por exemplo, nomes de ervas, partes do corpo ou termos médicos. Em paralelo, análises físico-químicas do pergaminho e da tinta ajudam a restringir a época e a região de origem, reduzindo o universo de línguas candidatas.
O avanço recente está justamente na capacidade computacional. Algoritmos atuais conseguem testar automaticamente centenas de combinações e compará-las com grandes corpora de textos em múltiplos idiomas, o que seria impraticável manualmente. Ainda assim, a etapa final continua humana: alguém precisa avaliar se a leitura faz sentido gramatical e histórico.
Teoria em turco antigo ganha espaço nas discussões
Em paralelo ao uso de IA em universidades, uma das propostas mais comentadas dos últimos anos veio de fora da academia formal. O engenheiro eletricista Ahmet Ardic, apaixonado por línguas turcas e etimologia, encontrou uma cópia digital do Manuscrito Voynich e passou um ano tentando decifrá-lo sozinho. Depois, envolveu os dois filhos no trabalho.
A família publicou vídeos explicando sua hipótese: para eles, o manuscrito estaria escrito em um dialeto turco antigo — ou numa combinação de dialetos — usando uma ortografia fonêmica, em que se escreve como se fala. Segundo um dos filhos, o grupo já teria decifrado cerca de 300 palavras e hoje afirma conseguir ler aproximadamente 30% do texto.
De acordo com a leitura proposta, o manuscrito traria receitas, descrições de pomadas e instruções médicas, incluindo referências a aborto e orientações sobre como realizar uma cesariana de forma correta. Eles dizem que o texto também combate crenças da época, como a ideia de que comer mais aumentaria as chances de ter um filho homem.
Davis avalia que, até aqui, as alegações “se sustentam muito bem”, mas faz a mesma ressalva feita às demais teorias: é preciso que especialistas em línguas turcas antigas analisem o material, tentem reproduzir o método e verifiquem se outras partes do manuscrito também se encaixam na proposta. Esse escrutínio ainda está em curso.
Por que o manuscrito continua desafiando até a IA
Apesar da combinação de poder computacional e novas teorias, o Manuscrito Voynich permanece indecifrado porque falta uma peça-chave que tornou possível outros grandes quebra-cabeças linguísticos: um texto paralelo seguro, como a célebre Pedra de Roseta para os hieróglifos egípcios, ou um conjunto de documentos em que a língua-alvo já seja conhecida.
No caso do Voynich, não há consenso sequer sobre qual família linguística estaria por trás das palavras aparentes. Isso obriga pesquisadores a testar hipóteses sucessivas — hebraico, línguas românicas, germânicas, asiáticas, agora dialetos turcos —, sempre com risco alto de encontrar padrões ilusórios em meio ao ruído.
Para a inteligência artificial, isso significa trabalhar praticamente às cegas. Algoritmos precisam de exemplos confiáveis para treinar, e o manuscrito oferece só um corpus isolado, sem tradução de referência. A consequência é que o computador consegue apontar probabilidades, mas não chega sozinho à comprovação.
Na prática, o que as iniciativas recentes mostram é menos uma solução definitiva e mais um amadurecimento das ferramentas disponíveis. A tendência para os próximos anos é que outras equipes, em diferentes países, tentem validar ou refutar as hipóteses atuais, publiquem resultados em revistas especializadas e, com isso, aproximem — ainda que lentamente — o público de uma eventual leitura coerente do livro mais misterioso da Idade Média.
Fonte: matéria original