Nanbeige lança modelo aberto 33B para agentes de código avançados
Nanbeige apresenta o Nanbeige4.3-33B, modelo aberto de 33 bilhões de parâmetros voltado a agentes de codificação, com controles avançados de raciocínio e uso de ferramentas.
Tecnologia
Conheça o Nanbeige4.3-33B, modelo aberto com 33 bilhões de parâmetros para agentes de código avançados.
Leia também: Economista diz que IA não gera lucro fora do setor de tecnologia
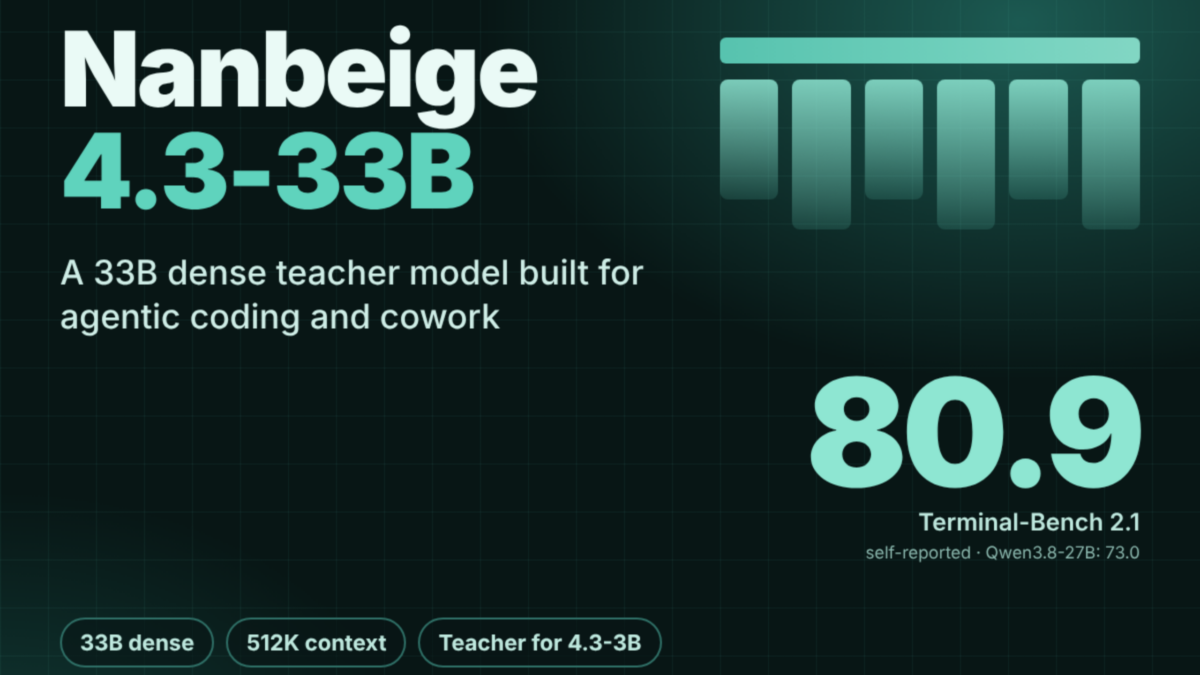
A Nanbeige lançou nesta semana o Nanbeige4.3-33B, um modelo de linguagem aberto com 33 bilhões de parâmetros voltado para codificação agentiva, com controles finos de raciocínio e chamadas a ferramentas, e mira torná-lo um “professor” robusto para treinar versões menores e mais leves.
Modelo de 33B mira ser ‘professor’ para agentes menores
O Nanbeige4.3-33B é o modelo principal da série Nanbeige4.3 e usa uma arquitetura padrão LlamaForCausalLM, sem roteamento de especialistas, o que faz com que todos os 33 bilhões de parâmetros sejam usados a cada token gerado. A estratégia declarada do laboratório é começar por um modelo forte e, a partir dele, destilar habilidades agentivas para modelos menores, começando pelo Nanbeige4.3-3B.
O chat template do modelo expõe três controles principais. Segundo a Nanbeige, “enable_thinking toggles reasoning and is on by default”, permitindo ligar ou desligar o modo de raciocínio avançado. Já “preserve_thinking keeps reasoning from earlier turns. Nanbeige recommends it for multi-turn tool use and code agents”, mantendo o histórico de raciocínio em interações múltiplas, algo crítico para agentes que encadeiam chamadas de ferramentas.
O terceiro controle é voltado a integrações externas. “Passing tools enables tool calling, and an XML call format is recommended”, afirma o laboratório, indicando que o modelo foi desenhado desde o início para trabalhar com ferramentas e APIs no estilo de agentes de software.
Desempenho em benchmarks e disputas com rivais abertos
Para posicionar o Nanbeige4.3-33B no ecossistema de modelos abertos, a Nanbeige comparou o desempenho com rivais como Qwen3.8-27B, Muse-Glimmer-30B e Gemma4-31B, em cenários de raciocínio intensivo e com hiperparâmetros compartilhados. Nos resultados auto-relatados, o novo modelo perde em 3 de 20 tarefas avaliadas.
Nesses casos, o Qwen3.8-27B lidera o benchmark de correção de código SWE-Bench Pro (61,7 contra 60,3) e o conjunto GDPval (86,4 contra 84,8), enquanto o Gemma4-31B fica à frente no GPQA Diamond (91,3 contra 89,5). A própria Nanbeige ressalta que alguns números divergem dos dados publicados pelos concorrentes por diferenças de métodos de avaliação e trata os resultados como provisórios até que testes independentes sejam divulgados.
Na versão base, sem ajustes específicos para chat, a Nanbeige afirma que “The Base model beats Gemma4-31B-Base on all 8 reported tasks. Examples include MMLU-Pro (66.9 vs 59.3) and GPQA (62.0 vs 41.5)”, sinalizando vantagem em tarefas de conhecimento geral e perguntas complexas.
Exigência de hardware alto restringe uso inicial
O ganho de capacidade vem acompanhado de custo em infraestrutura. De acordo com a Nanbeige, “By arithmetic from config.json, BF16 weights need about 66 GB”, apenas para armazenar os pesos do modelo em precisão BF16. O cache KV, usado para manter o contexto em sequências muito longas, é ainda mais pesado: “A full 524,288-token sequence therefore needs roughly 112 GB of KV cache”.
Na prática, isso coloca o Nanbeige4.3-33B hoje no radar principalmente de centros de pesquisa e empresas com GPUs de alta capacidade ou clusters com paralelismo tensorial. O laboratório fornece receitas prontas para execução com Transformers, SGLang e vLLM, além de exemplos de servidores usando paralelismo tensorial em quatro vias e parsers de raciocínio e de chamadas de ferramentas inspirados no ecossistema Qwen.
As configurações recomendadas para agentes incluem temperatura 1,0 e top_p 0,95, com limite de até 65.536 tokens para saídas em chamadas de ferramentas. Para sessões de raciocínio e chat, a orientação é usar temperatura 0,6 e permitir até 262.144 tokens gerados, explorando a janela de contexto estendida do modelo.
Entenda o contexto
O lançamento do Nanbeige4.3-33B reforça a disputa entre grandes modelos abertos voltados a desenvolvimento de software, em um momento em que ferramentas de IA passam a atuar como agentes capazes de escrever, depurar e integrar código de forma quase autônoma. Ao focar explicitamente em codificação agentiva e uso de múltiplas ferramentas, a Nanbeige tenta ocupar um espaço hoje dominado por soluções proprietárias.
A empresa posiciona o 33B como um “professor” para treinar modelos menores, mais baratos de rodar e mais fáceis de integrar em produtos comerciais, o que pode ampliar o acesso a capacidades avançadas sem exigir dezenas de gigabytes de memória por instância. Para desenvolvedores e pesquisadores, a combinação de modelo aberto, controles para raciocínio e documentação técnica detalhada facilita experimentos com agentes complexos, orquestrando tarefas de programação de ponta a ponta.
O modelo foi divulgado pelo site oficial da Nanbeige e em plataformas técnicas e redes sociais como X, SubReddit de aprendizado de máquina — que já reúne mais de 150 mil membros — e grupos no Telegram. Na cobertura do lançamento, o CEO da Marktechpost AI Media Inc., Asif Razzaq, reforçou o caráter aplicado da iniciativa: “Asif Razzaq is the CEO of Marktechpost AI Media Inc., committed to harnessing the potential of Artificial Intelligence for social good”.
Apesar da boa recepção inicial em comunidades técnicas, a adoção comercial ainda está em estágio inicial. A própria Nanbeige registra que “At publication, no Hugging Face Inference Provider hosts the model”, o que significa que, por enquanto, o uso depende de infraestrutura própria. A expectativa é que, à medida que surgirem integrações em serviços de inferência gerenciados e versões destiladas menores, o Nanbeige4.3-33B passe a disputar espaço direto com outros grandes modelos abertos em aplicações de desenvolvimento de software e agentes corporativos.