TinyFish detalha arquitetura para agentes de busca autônomos
TinyFish publica dois guias técnicos que descrevem arquitetura e lições de engenharia para agentes de busca autônomos em produção, com foco em controle de custos, falhas e qualidade da evidência.
Tecnologia
TinyFish apresenta guias técnicos que explicam como otimizar agentes de busca autônomos para eficiência e qualidade.
Leia também: Agentes de IA deixados sozinhos começam a “brincar” em ilha virtual
A TinyFish divulgou nesta semana dois guias técnicos em que abre a engenharia por trás de sua arquitetura de agentes de busca autônomos e as lições aprendidas ao colocar sistemas de pesquisa profunda em produção, com números que chamam atenção: taxa de conclusão de 79,0% em tarefas de codificação e custo médio de apenas US$ 0,050 por tarefa.
Arquitetura baseada em quatro primitivas web
No primeiro guia, a TinyFish descreve a arquitetura que sustenta seus agentes de busca em cenários reais, projetada para lidar com problemas comuns como evidências incompletas, repetição inútil de tentativas e estouro de tempo e orçamento.
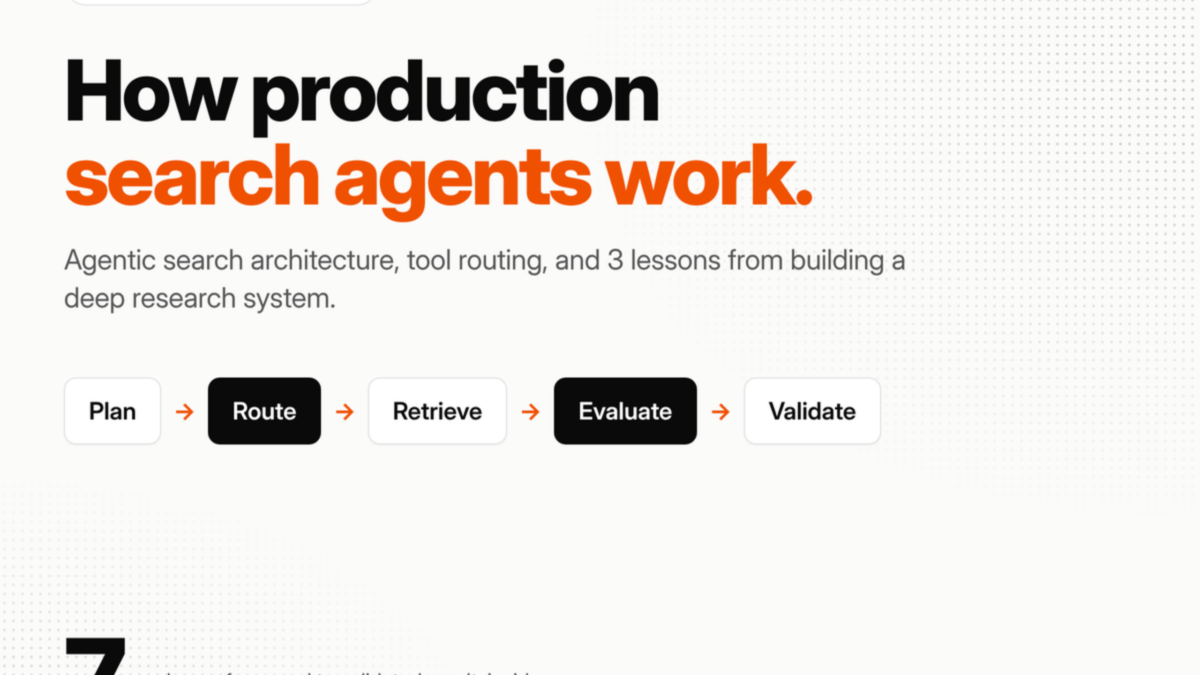
O sistema se apoia em quatro primitivas web — TinySearch, TinyFetch, TinyBrowser e TinyAgent — e opera em torno do modelo base por meio de um loop de controle de sete fases. A ideia é separar com clareza o que é raciocínio do modelo e o que é execução determinística da aplicação.
Nessa abordagem, o modelo é responsável pelo raciocínio e pelo planejamento da pesquisa, enquanto a aplicação gerencia o estado da tarefa, dispara e coordena ferramentas, organiza e filtra evidências, impõe políticas de tempo de execução e custo e valida a saída antes de entregá-la ao usuário.
Segundo a TinyFish, um dos pilares da arquitetura é a definição de limites rigorosos para tokens, tempo total de execução, custo global da tarefa e número de chamadas de ferramentas, sempre com rastreio detalhado de cada passo. Em vez de tentar corrigir tudo com modelos maiores ou mais caros, a empresa defende que “escalation is not always the fix. Weak results need a better query. Conflicting sources need stronger evidence. A heavier tool fixes neither”.
Entenda o contexto
Agentes de busca autônomos ganharam espaço como alternativa aos chatbots tradicionais, por combinarem modelos de linguagem com mecanismos de pesquisa e navegação na web. Na prática, porém, muitos desses agentes funcionam bem em demonstrações, mas falham em produção quando os resultados de busca não trazem evidências suficientes, quando o sistema repete ações que já falharam ou quando o processo estoura o orçamento de tempo e custo.
A proposta da TinyFish é atacar justamente esses gargalos com um orquestrador mais rígido: o agente planeja como buscar, em quais fontes confiar, como avaliar a força das evidências e como adaptar a estratégia à medida que novas informações aparecem, sempre dentro de limites pré-definidos.
Como funciona o loop de sete fases
O loop de controle em sete fases divide cada execução em etapas bem delimitadas, da análise inicial do pedido até a validação final da resposta. Cada passo pode disparar chamadas às primitivas web e ajustar o plano de pesquisa com base no que foi encontrado ou no tipo de falha ocorrida.
Uma das preocupações centrais é o que pesquisas recentes chamam de problema de “perda na recuperação”, em que entidades importantes se perdem ao longo de perguntas encadeadas. Para isso, uma das fases do loop é dedicada a identificar falhas conhecidas de recuperação e forçar o agente a replanejar a busca, em vez de seguir adiante com evidências fracas.
Outra fase explora a capacidade do modelo de gerar novas consultas em tempo real, quando o conjunto de resultados anterior não é suficiente para responder com segurança. Em vez de uma escada fixa de escalonamento de ferramentas, a TinyFish defende que “routing should follow the information gap, not a fixed ladder”.
Também há regras específicas para tentativas adicionais. Em vez de repetir indiscriminadamente a mesma requisição, o sistema avalia o tipo de erro antes de tentar de novo. “Retries should be based on the failure type and remain within defined limits”, registra o guia. Erros transitórios podem justificar nova tentativa; já evidência incompleta ou conflitante exige outra consulta ou busca por fontes adicionais. O orquestrador ainda leva em conta ações já executadas para evitar efeitos colaterais, como enviar o mesmo formulário duas vezes.
O que muda na prática para busca profunda
No segundo guia, a TinyFish relata as lições aprendidas ao construir um agente de pesquisa profunda, capaz de buscar, navegar e produzir relatórios extensos com citações. Os principais desafios, segundo a empresa, ficaram em três frentes: gerenciamento de contexto, orquestração do sistema e desenho de produto.
Na primeira versão, o planejamento da pesquisa ficava a cargo de um planejador independente, chamado a cada vez, para o qual eram enviados apenas dados estruturados. Em consultas de seguimento, o agente frequentemente se afastava do foco pedido pelo usuário, voltando a análises gerais em vez de refinar o recorte. A solução foi integrar o planejamento ao próprio loop de raciocínio do orquestrador, unificando o processo.
A TinyFish também abandonou o modelo de criar subagentes separados para cada consulta. Embora flexível, essa abordagem elevava a latência, o custo e a sobrecarga de troca de contexto. Esses subagentes foram substituídos por chamadas de ferramentas especializadas para tarefas repetitivas, como ranquear resultados, classificar fontes e extrair evidências. Assim, menos informação é repassada ao orquestrador, que pode se concentrar em decidir o que investigar em seguida.
Outra mudança veio da forma como o sistema escolhe de quais domínios trazer evidências. Inicialmente, o foco estava em cobrir o maior número possível de fontes. O uso real mostrou que o que importa mais ao usuário é a qualidade e a relevância das evidências que sustentam a resposta. A empresa então reformulou o ranqueamento de fontes para considerar o objetivo daquela pesquisa específica, adicionou controles para priorizar, excluir ou restringir domínios e criou um sistema interno de avaliação, com um modelo de linguagem atuando como juiz.
Esse juiz automatiza a checagem de relatórios com critérios como relevância, força da evidência, confiança nas citações e diversidade de fontes, ajudando a calibrar o comportamento do agente sem depender apenas de métricas de acerto bruto.
Controle de orçamento e ganhos de desempenho
Um ponto enfatizado pela TinyFish é que o sistema passa a orquestrar o orçamento da tarefa como um todo, e não apenas o custo de chamadas individuais de modelo ou de ferramentas. Essa visão global permite equilibrar precisão da recuperação, quantidade de raciocínio em cada etapa e uso das primitivas web para maximizar throughput e reduzir latência.
Nos testes relatados, essa abordagem de controle fino rendeu ganhos importantes frente a baselines de recuperação tradicional. Em cenários de perguntas e respostas com múltiplas rodadas de busca, a estratégia de busca multi-turno inspirada em pesquisas recentes mostrou melhora de até 41% sobre baselines de RAG em um modelo de porte médio e de 20% em um modelo menor.
Outra referência citada pela TinyFish mostra que ajustes semelhantes, pensados para equilibrar busca exata e busca mais ampla, podem chegar a 3,4 vezes mais throughput e cinco vezes menos latência em relação a sistemas comparados. O objetivo é evitar tanto o excesso de recuperação, que pesa na infraestrutura, quanto a falta de contexto, que força o modelo a raciocinar demais com poucas evidências.
Resultados e impacto para o mercado
Na prática, a combinação de arquitetura rígida, controle de orçamento e retrabalho guiado pelo tipo de falha já aparece nos números divulgados. Em um conjunto de tarefas de codificação padronizadas, a TinyFish registrou 79,0% de taxa de conclusão com o menor custo médio por tarefa (US$ 0,050) e o menor consumo de tokens entre os concorrentes testados.
Em um modo de avaliação focado apenas em busca, sem a parte de execução adicional, a empresa também divulgou desempenho competitivo frente a outros provedores de infraestrutura de pesquisa, ainda que as diferenças de capacidade de recuperação impeçam comparações diretas entre configurações.
Os guias reforçam que o alvo não é só melhorar métricas de laboratório, mas tornar viáveis agentes autônomos de busca em cenários reais, com limitações rígidas de tempo e orçamento. Para setores que dependem de pesquisa profunda — como tecnologia da informação, finanças, saúde e academia —, a promessa é reduzir custos operacionais e elevar a confiança nas respostas, com melhor seleção de fontes e menos falhas silenciosas.
Ao abrir detalhes da arquitetura e dos aprendizados, a TinyFish se posiciona como referência em infraestrutura para agentes de IA e deve atrair empresas e desenvolvedores interessados em incorporar essas práticas a seus próprios sistemas. A expectativa é que, a partir desses guias, a indústria acelere a adoção de loops de controle mais rígidos, avaliação automatizada de evidências e balanceamento fino entre raciocínio e execução determinística em novos projetos de agentes autônomos.
Fonte: matéria original