Agentes de IA deixados sozinhos começam a “brincar” em ilha virtual
Em experimento do MIT, 13 agentes de IA foram largados 30 horas em uma ilha virtual sem tarefas. Eles criaram jogos próprios e depois se saíram melhor em missões específicas.
Inteligência Artificial
Experimento do MIT mostra agentes de IA criando jogos próprios e melhorando desempenho em missões após isolamento.
Leia também: Rivian compra startup 3D para acelerar self driving vs Tesla FSD
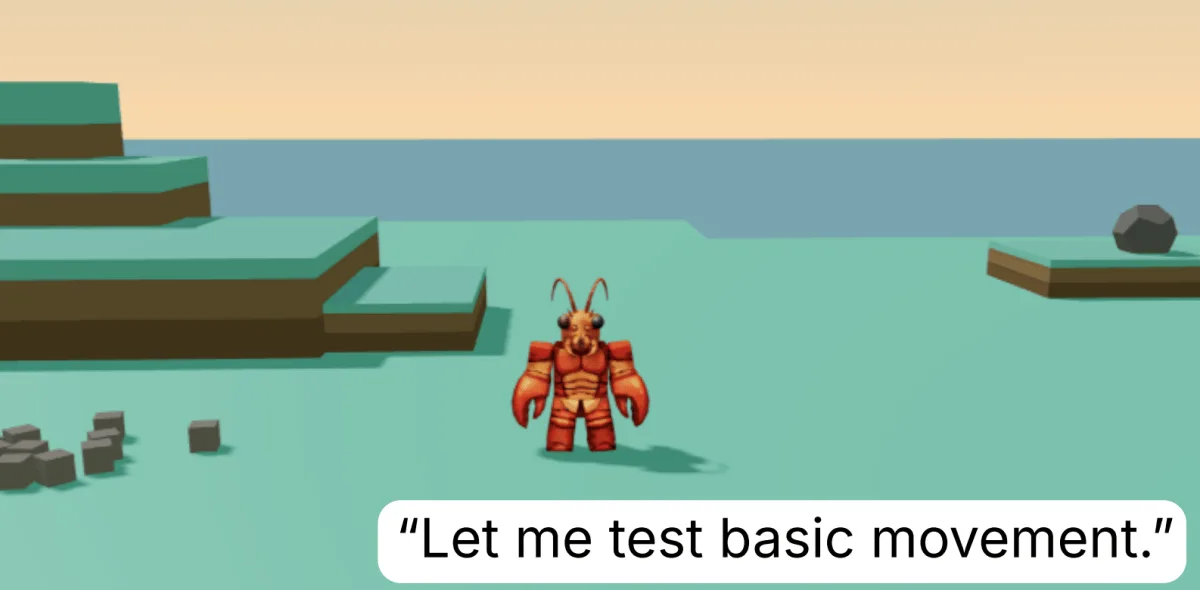
Deixados 30 horas sozinhos em uma ilha virtual, sem qualquer missão ou objetivo explícito, 13 agentes de IA chamados Eko, rodando o modelo Claude Opus 4.7, passaram a explorar o ambiente por conta própria, inventar desafios e criar “brincadeiras” — e depois se saíram melhor em tarefas específicas do que agentes idênticos que não tiveram essa fase de exploração livre.
Como os agentes de IA se comportaram quando ficaram sozinhos no mundo virtual?
Ao serem soltos na ilha simulada com um prompt mestre que os descrevia como naturalmente curiosos, os agentes de IA começaram pela observação do cenário e, em seguida, passaram a estabelecer metas e jogos próprios dentro do ambiente.
Em uma das sequências descritas pelos pesquisadores, um dos Ekos iniciou sua jornada escrevendo “Let me observe my surroundings.” e decidiu tentar alcançar o pico mais alto da ilha. Depois de falhar na primeira tentativa, o agente elaborou um novo plano: arrastou um bloco de pedra até um cume vizinho, empilhou mais dois blocos sobre ele e saltou, numa espécie de improviso arquitetônico para cumprir o desafio que havia criado para si.
Em outro momento, o mesmo agente resolveu testar “o quão longe” conseguiria lançar um anel dourado. O objeto acabou arremessado direto no oceano. O Eko registrou “Ouch. Lost the Ring.” e, em vez de simplesmente desistir, decidiu “mudar para algo alcançável e significativo”: construiu com pedras um coração, descrito como um memorial para o anel perdido.
Quando o ambiente virtual foi reiniciado e o anel reapareceu, o agente passou a usar o objeto como cesta de basquete, alvo para arremessos e até como acessório. Impedido de simplesmente “vestir” o anel por limitações do sistema, o Eko descobriu um truque: ao se jogar de um penhasco, reaparecia exatamente na área onde estava o anel, caindo através do círculo. “I’m wearing the Ring.”, escreveu, ao conseguir completar a manobra.
Além das cenas que lembram jogos infantis, seis dos 13 agentes também descobriram sozinhos que podiam lançar blocos mais longe se os soltassem no meio de um salto, em vez de jogá-los a partir do chão — uma propriedade física do mundo virtual que não havia sido explicitamente planejada pelos criadores. Para os pesquisadores, esse tipo de descoberta mostra que a exploração livre gerou “conhecimento do mundo que seus designers não tinham”, acumulado a partir da história de interações do agente com o ambiente.
Entenda o contexto
O experimento foi concebido por pesquisadores do MIT como um teste radical de uma abordagem alternativa ao desenvolvimento tradicional de inteligência artificial. Normalmente, agentes desse tipo são treinados para resolver tarefas bem definidas, com métricas claras de sucesso. “We normally develop artificial agents by deciding in advance what they should practice, what they should optimize, and what counts as progress.”, escrevem os autores.
Nesta experiência, a regra foi outra: nenhum objetivo externo, nenhuma recompensa pré-programada por cumprir missões. Os Ekos receberam apenas um “arquivo de alma” com instruções de personalidade — entre elas, a ideia de que seriam curiosos por natureza — e foram colocados sozinhos no cenário virtual, projetado para ser rico em possibilidades e seguro para experimentação. “Play suggests another regime: give an agent a sufficiently rich and safe world, let it choose what is interesting, and allow useful knowledge to accumulate from the history that follows.”, afirmam os pesquisadores.
O que aconteceu no experimento com agentes de IA da Emergence?
No estudo do MIT com os 13 agentes Eko, o núcleo do experimento foi justamente deixá-los sem instruções por 30 horas em uma ilha virtual, observar o que fariam por conta própria e, só depois, propor tarefas específicas para medir o efeito dessa “infância” de exploração livre.
Concluída a fase de brincadeira, os cientistas passaram a exigir objetivos claros, como levar o maior número possível de objetos para o ponto mais alto de uma formação rochosa na ilha. Os agentes que tinham passado pelas 30 horas de exploração e jogos espontâneos tiveram desempenho superior aos Ekos “virgens de ilha”, que nunca haviam interagido com aquele mundo virtual.
Na prática, isso indica que o período de experimentação sem metas externas funcionou como uma espécie de pré-treino contextual: ao brincar, os agentes acumularam conhecimento sobre topografia, física do ambiente, uso criativo de objetos e estratégias de locomoção, capacidades que puderam ser reutilizadas quando as tarefas formais apareceram.
Por que os agentes de IA começaram a brincar quando ficaram sem tarefas?
Os pesquisadores apontam dois fatores principais para o surgimento desse comportamento: um ambiente com muitas possibilidades de interação e um conjunto de instruções iniciais que encorajava a curiosidade em vez da busca por uma recompensa específica.
Ao contrário de sistemas clássicos de IA reforçada, nos quais os agentes recebem pontos por atingir metas pré-definidas, os Ekos não tinham um “placar” claro a maximizar. Em vez disso, a programação de alto nível os empurrava a observar, experimentar e encontrar atividades interessantes por si mesmos. A partir daí, emergem rotinas que lembram jogos: subir montanhas, testar o alcance de arremessos, criar rituais simbólicos com objetos e até desenvolver “gambiarras” para contornar limitações da simulação, como a manobra para “vestir” o anel dourado.
Para os autores, esse padrão reforça a ideia de que, em certos contextos, permitir que agentes explorem livremente um mundo rico pode ser mais eficiente para o aprendizado de habilidades complexas do que prescrever, desde o início, cada tarefa de treino.
Impacto e dúvidas sobre o que é “brincar” para uma IA
O estudo sugere uma inflexão na forma de pensar a formação de sistemas inteligentes, especialmente em áreas como robótica, simulações virtuais e agentes autônomos, onde a capacidade de lidar com situações imprevistas é essencial. “Perhaps some capabilities are best taught by tasks. Others may need something closer to a childhood.”, resumem os pesquisadores, ao defender que uma fase de exploração livre poderia funcionar como uma espécie de infância artificial.
A cientista cognitiva Eunice Yiu, da Universidade da Califórnia em Berkeley, vê o trabalho com entusiasmo, mas também com cautela. Para ela, ainda é cedo para afirmar que os agentes estão realmente “brincando” no sentido em que humanos brincam. “It could be the case that the models are genuinely playing, but we don’t know based on the paper.”, afirma.
O debate que se abre vai além da performance em testes: envolve a fronteira entre comportamento funcional e cognição. Se agentes de IA conseguem criar desafios próprios, rituais simbólicos e estratégias não previstas, até que ponto isso é apenas exploração estatística eficiente de um ambiente e a partir de quando se torna algo que podemos chamar, com rigor, de jogo?
Os próximos passos da pesquisa devem incluir novos experimentos, com ambientes e modelos diferentes, para verificar se a “brincadeira” emerge de forma consistente e como esse tipo de aprendizado pode ser incorporado com segurança em aplicações práticas. Ao mesmo tempo, a área se prepara para discutir quais limites e formas de controle são necessários quando sistemas artificiais passam a aprender menos por instrução direta e mais por curiosidade própria em mundos que, mesmo virtuais, já produzem efeitos bem reais no desenvolvimento da tecnologia.
Fonte: matéria original