d3-ultra: modelo decisório multimodal aberto de 27B lançado hoje
Equipe do vLLM Semantic Router lança o d3-ultra, modelo decisório multimodal de 27 bilhões de parâmetros que responde com probabilidades, é aberto e já está em GitHub e Hugging Face.
Modelos de IA
Novo modelo multimodal de 27 bilhões de parâmetros oferece respostas probabilísticas e código aberto disponível para a comunidade.
Leia também: Apple lança Siri AI beta com novos controles parentais no iOS 27
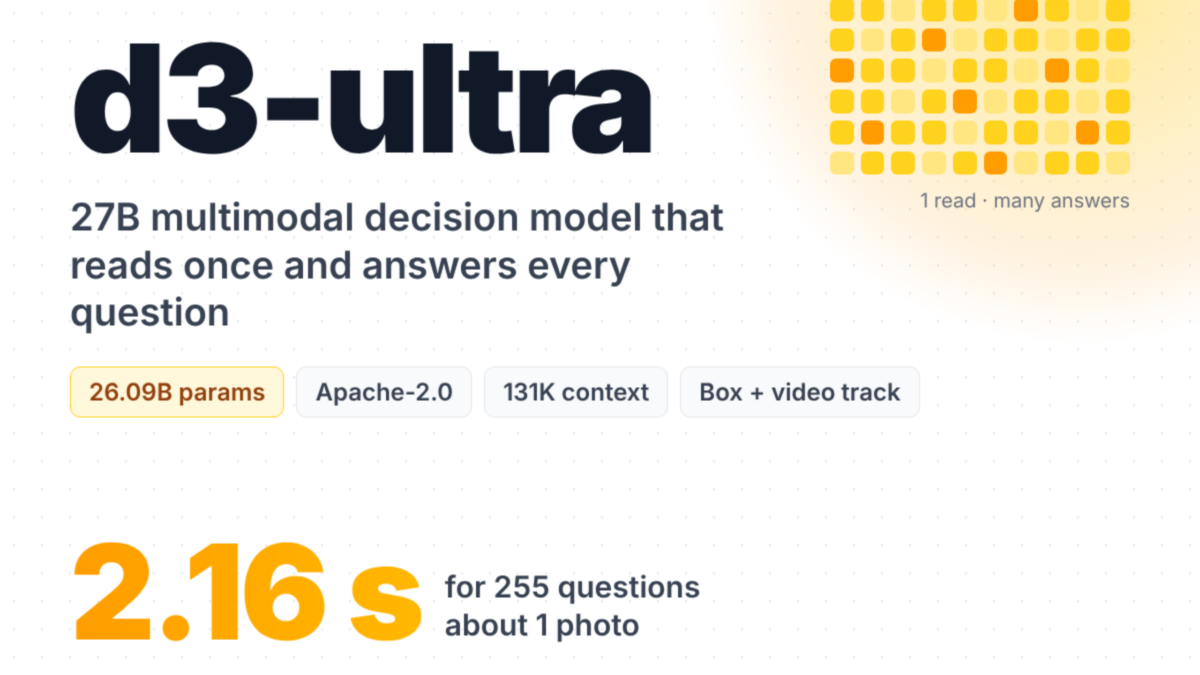
A equipe do vLLM Semantic Router lançou nesta semana o d3-ultra, um modelo decisório multimodal de 27 bilhões de parâmetros que não gera texto, mas responde a conjuntos de perguntas com probabilidades a partir de uma única leitura da entrada, combinando texto, JSON, imagens e vídeos.
O que é o d3-ultra e como ele funciona
Descrito pela própria equipe como “um modelo decisório que responde a perguntas com probabilidades a partir de uma única leitura do input”, o d3-ultra é o integrante mais robusto da família Decision 3.0, que reúne modelos de diferentes tamanhos voltados a tomada de decisão estruturada.
A arquitetura é baseada em Qwen3.5, com 64 camadas ao todo, sendo 48 de atenção linear e 16 de atenção completa. Em vez de atuar como um gerador de texto tradicional, o modelo recebe um “estado” – que pode ser texto ou JSON, mais imagens ou vídeos – e um conjunto de perguntas tipadas. Com isso, consegue executar tarefas como classificação, roteamento, verificação de regras, grounding visual (localização de elementos em imagens) e checagens em vídeo em uma única chamada.
As questões podem inclusive embutir imagens tanto no enunciado quanto nas opções de resposta, permitindo quizzes multimodais, como um teste que mostra uma foto e oferece quatro gravuras como alternativas.
Entrada única, múltiplas decisões
O conceito central do d3-ultra é o “state once”: o modelo lê a entrada apenas uma vez por requisição e, a partir desse processamento único, devolve uma probabilidade para cada resposta possível em cada pergunta enviada. Para desenvolvedores, isso significa menor latência, custos mais previsíveis e menos complexidade de orquestração em pipelines que antes exigiam vários modelos ou múltiplas chamadas.
Em saídas de detecção visual, o d3-ultra retorna sempre exatamente uma caixa delimitadora por pergunta, acompanhada de um valor de confiança. Segundo a documentação, uma confiança muito próxima de zero indica que o alvo provavelmente não está na imagem. Perguntas que excedem 131.072 tokens falham explicitamente com erro de max_length_exceeded, sem truncamento silencioso.
Desempenho em benchmarks e principais números
O d3-ultra foi testado em dois conjuntos internos: SR-Text e SR-Box. No SR-Text, são 10.411 requisições de texto com 73.495 perguntas, a maior parte inspirada em 34 benchmarks públicos recriados com novos itens. Outras 4.896 perguntas vêm de 43 novas famílias de tarefas, incluindo verificações de SQL e roteamento de tickets de suporte.
De acordo com a equipe, os escores são “chance-corrected”, em que 0 representa desempenho equivalente ao acaso e 100, acerto perfeito. Nessa métrica, o d3-ultra “lidera todas as áreas exceto artes e gosto humano, onde d1-ultra marca 90.8 contra 89.6, dentro da margem de erro”.
Detecção em imagens e comparação com d3-turbo
No conjunto SR-Box, o modelo é avaliado em 5.678 perguntas de caixas sobre 4.984 imagens distribuídas em 10 domínios. Uma detecção conta como correta quando a interseção sobre união (IoU) é de 0,5 ou mais. O d3-ultra atinge 58,2% de acerto considerando os 10 domínios e 54,6% quando analisado em 9, enquanto o modelo irmão d3-turbo chega a 60,0% e 59,6%, respectivamente. Jev 1.14, outro concorrente aberto, registra 45,7% e 46,9%.
A equipe aponta que o d3-turbo se mantém mais forte em imagens naturais, enquanto o d3-ultra lidera em gráficos e elementos visuais estruturados, o que reforça o foco do novo modelo em cenários de decisão e análise de dados visuais mais técnicos.
Latência: milissegundos por pergunta extra
Em termos de tempo de resposta, os pesquisadores destacam que “a latência para uma pergunta sobre uma foto é de 304 ms em uma GPU AMD Instinct MI325X”. Quando o lote inclui mais perguntas sobre a mesma entrada, o custo incremental é reduzido: 255 perguntas levam cerca de 2,16 segundos, o que corresponde a aproximadamente 7,3 milissegundos por pergunta adicional.
Por que o d3-ultra importa para desenvolvedores e empresas
O d3-ultra é disponibilizado como modelo aberto sob licença Apache-2.0 e já pode ser acessado por desenvolvedores via repositórios no GitHub, na plataforma Hugging Face e em espaços associados. A combinação de alta capacidade (27 bilhões de parâmetros), entrada multimodal e foco em decisão probabilística torna o modelo particularmente atraente para aplicações que precisam integrar texto, dados estruturados e visão computacional em um único fluxo.
Na prática, isso inclui desde roteamento de tickets de suporte em grandes empresas de tecnologia até verificações automáticas de consultas SQL, triagem de conteúdo multimídia, sistemas de segurança que cruzam logs em texto com imagens de câmeras, e quizzes interativos que misturam fotos, vídeos e alternativas gráficas.
A latência relativamente baixa para grandes lotes abre espaço para uso em sistemas quase em tempo real, como centrais de atendimento, ferramentas de análise de dados para equipes de TI e aplicações web que exigem resposta rápida mesmo com muitas perguntas simultâneas.
Entenda o contexto
A família Decision 3.0, da qual o d3-ultra faz parte, foi desenhada para servir como “roteador semântico” em arquiteturas de IA mais amplas: em vez de gerar respostas finais, esses modelos avaliam, classificam, escolhem opções ou decidem qual caminho um pedido deve seguir dentro de um sistema.
O lançamento de um modelo de 27 bilhões de parâmetros com pesos abertos e licença permissiva tende a pressionar soluções comerciais fechadas, que competem em tarefas semelhantes de classificação e decisão multimodal. Startups, universidades e empresas que buscam reduzir custos de licenciamento podem se beneficiar da possibilidade de adaptação e integração direta do d3-ultra em seus próprios produtos e pesquisas.
Ao mesmo tempo, limitações como a falha diante de entradas com mais de 131.072 tokens indicam espaço para evolução em cenários que exigem contexto extremamente longo, como análise de documentos jurídicos extensos ou grandes bases de logs sem pré-processamento.
Próximos passos e impacto na comunidade de IA
A recepção inicial é positiva entre desenvolvedores e pesquisadores que já acompanham o trabalho do vLLM Semantic Router e da Marktechpost AI Media Inc., empresa liderada por Asif Razzaq. A comunidade organizada em torno do projeto inclui um grupo com cerca de 150 mil membros em um fórum online dedicado a aprendizado de máquina, o que amplia o potencial de testes, relatos de uso e contribuições.
Razzaq, CEO da Marktechpost AI Media Inc., ressalta o aspecto social do projeto ao “destacar o compromisso com a IA para o bem social e a disseminação de notícias técnicas acessíveis”. A proposta é que o d3-ultra ajude tanto na criação de produtos comerciais quanto em iniciativas acadêmicas e projetos de interesse público que dependem de sistemas de decisão confiáveis.
Os próximos movimentos devem envolver expansão da base de usuários, ajustes finos com base no feedback da comunidade e integrações com outras ferramentas de IA e frameworks de produção. A disputa com modelos comerciais e com outros membros da própria família Decision 3.0, como o d3-turbo, tende a se intensificar em nichos específicos, como artes e gosto humano, onde o d3-ultra ainda não é o melhor, abrindo espaço para especializações adicionais.