Liquid AI lança LFM3, modelo multimodal leve para rodar no celular
Liquid AI apresenta LFM3, família de modelos multimodais de cerca de 2 bilhões de parâmetros, capaz de rodar localmente em celulares, PCs e dispositivos de borda, com foco em agentes inteligentes e baixo custo.
Inteligência Artificial
Conheça o LFM3, modelo multimodal compacto que traz inteligência avançada para dispositivos móveis e de borda.
Leia também: Inspetor avalia investigar uso de IA do Home Office em asilos
A Liquid AI lançou nesta semana o LFM3, uma nova família de modelos de inteligência artificial multimodal pensada para rodar direto em celulares, laptops e outros dispositivos de borda, com desempenho de modelo grande, mas consumo bem menor de recursos. A linha unifica modelos de texto, visão, áudio, omni e decisão sobre uma mesma arquitetura de cerca de 2 bilhões de parâmetros, todos com suporte para implantação local e afinação em uma única GPU.
Modelos multimodais pensados para rodar em qualquer lugar
O LFM3 é apresentado como ponto de partida para inteligências especializadas: em vez de um único modelo gigante na nuvem, o desenvolvedor escolhe a variante adequada à modalidade (texto, imagem, som ou combinação), ajusta com seus próprios dados e roda onde a aplicação está — de um smartphone a um Raspberry Pi 5, passando por CPUs em nuvem, GPUs e a NPU Qualcomm Hexagon.
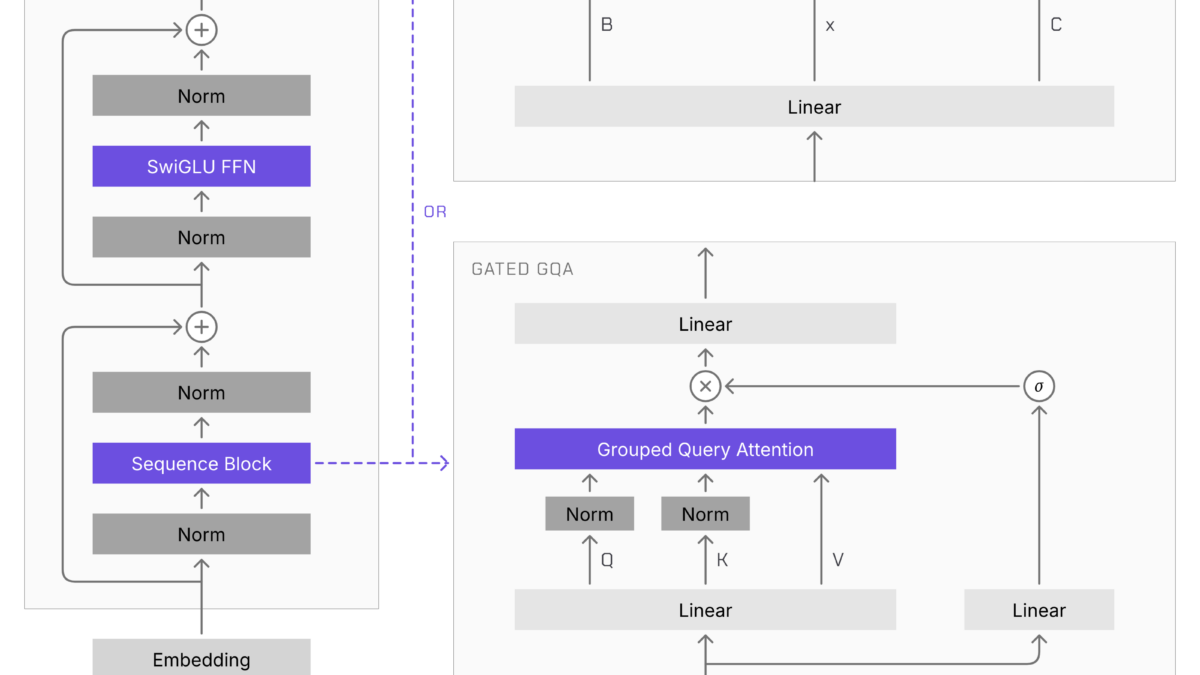
Segundo a empresa, todos os modelos são distribuídos com pesos abertos e estão disponíveis via Hugging Face, integrados à biblioteca transformers, o que facilita testes rápidos e integração com agentes locais como Hermes Agent, Pi e OpenClaw. A arquitetura híbrida foi redesenhada com uma busca automatizada que leva em conta o hardware de destino, cobrindo 14 combinações de dispositivos e backends para otimizar velocidade e consumo.
No centro da família está o LFM3-1.7B-Base, um modelo de linguagem com 24 camadas e aproximadamente 2 bilhões de parâmetros, pré-treinado em 22 trilhões de tokens e com janela de contexto estendida para até 256 mil tokens. É a partir dele que nascem as versões especializadas para visão, áudio, multimodalidade completa e decisão estruturada.
Desempenho maior com menos parâmetros
O LFM3-1.7B-Base foi desenhado para cenários agenticos — agentes que navegam na web, chamam ferramentas, preenchem formulários e tomam decisões estruturadas. De acordo com a Liquid AI, o modelo “matches LFM2-1.2B on short prompts across edge devices, and with 8K tokens in context it is about 25% faster”, ou seja, mantém o desempenho da geração anterior em prompts curtos e fica cerca de 25% mais rápido quando precisa lidar com 8 mil tokens em contexto.
A empresa afirma ainda que o novo modelo “outperforms its predecessor, LFM2.5-2.6B, with 35% fewer parameters, and the biggest gains are on agentic tasks: on WebArena-Verified, it scores 38.42 against 3.02”. Em outras palavras, com 35% menos parâmetros do que o LFM2.5-2.6B, o LFM3-1.7B mais do que multiplica por dez a pontuação em um benchmark que mede a atuação de agentes em tarefas reais de navegação e uso de aplicativos.
Na prática, isso significa que um desenvolvedor pode treinar um agente especializado — por exemplo, para suporte ao cliente ou automação de processos internos — usando apenas uma GPU comum de laboratório e depois colocar esse agente para rodar localmente, sem depender de conexão permanente a um servidor externo.
Visão: vídeo, robótica e menos dependência da nuvem
Para aplicações visuais, como robótica, monitoramento e análise de imagens, a Liquid AI apresentou o LFM3-VL-2B. O modelo trabalha com imagens e também com vídeo como entrada, fazendo raciocínio passo a passo antes de responder e identificando objetos e suas relações espaciais — um requisito central para braços robóticos, drones e sistemas de navegação.
Com 1,9 bilhão de parâmetros, o LFM3-VL-2B tem praticamente metade do tamanho do predecessor imediato (LFM2.5-VL-3B, com 3,1 bilhões), mas entrega bem mais resultados em testes. Segundo a empresa, “LFM3-VL-2B raises the average across 62 vision benchmarks from 57.6 to 71.4, on par with Gemma 4 12B, a model more than six times larger”. Assim, um modelo que cabe em dispositivos embarcados se aproxima do desempenho de um concorrente mais de seis vezes maior.
Além disso, a Liquid AI adaptou o LFM3-VL-2B para robótica, com versões específicas para orquestração, navegação e manipulação. Esses modelos conseguem, por exemplo, planejar trajetórias, interpretar descrições de rotas e gerar sequências de ações em menos de 50 milissegundos em hardware embarcado, o que abre espaço para robôs mais autônomos sem conexão constante com a nuvem.
Áudio: reconhecimento, síntese e tradução em 18 línguas
No campo do áudio, o LFM3-Audio-2B mira casos de uso como chat por voz, legendas automáticas, dublagem e assistentes pessoais. O modelo aceita texto ou áudio como entrada e responde em texto, fala ou ambos, com suporte a reconhecimento de fala, síntese e tradução em 18 idiomas, além de transformar comandos de voz em chamadas de ferramentas.
Com um novo codificador de áudio e um codec de fala próprio, a Liquid AI afirma que o LFM3-Audio-2B “speaks with higher quality (UTMOSv2 3.83 against 3.22), and adds audio understanding, general-purpose audio reasoning, and tool calling”. A métrica UTMOSv2 mede a qualidade percebida de áudio gerado; o salto de 3,22 para 3,83 indica avanço relevante em naturalidade de voz, aliado à capacidade de entender clipes sonoros e raciocinar sobre eles, não só transcrever.
Omni: um único modelo que vê, escuta e fala
A grande aposta multimodal da linha é o LFM3-Omni-2B, que combina texto, visão e áudio na entrada e devolve respostas em texto e fala. A proposta é substituir o conjunto típico de quatro modelos separados — reconhecimento de fala, visão-linguagem, linguagem e síntese de voz — por uma única peça que roda na ponta.
O modelo responde a perguntas faladas sobre fotos, assiste e escuta vídeos para entender o que está acontecendo e ainda é capaz de transformar o que “vê” e “ouve” em chamadas de ferramentas, por exemplo para acionar um robô ou executar uma ação em um sistema. Assim como o modelo de áudio, ele usa o codec LiquidCodec para fala em tempo real, o que permite respostas por voz enquanto os tokens ainda estão sendo gerados.
Segundo a Liquid AI, “LFM3-Omni-2B beats models up to 10.7B parameters, such as Qwen2.5-Omni-7B, on Daily-Omni, WorldSense, and AV-SpeakerBench”. Ou seja, em benchmarks que medem compreensão audiovisual, o modelo de 2 bilhões de parâmetros supera concorrentes com até 10,7 bilhões, reforçando o foco em eficiência.
Modelos de decisão estruturada para uso empresarial
Além dos modelos geradores, a família LFM3 inclui a linha d1, voltada a decisões estruturadas em vez de texto livre. Nessas variantes, o usuário fornece uma situação — como um chamado de suporte, uma fatura, uma tela de aplicativo, uma foto ou um recado de voz — e uma lista de perguntas; o modelo responde tudo em um único passo, com probabilidades calibradas para cada resposta.
Esses modelos vão além de respostas binárias ou múltipla escolha: conseguem apontar objetos em imagens, ler valores em documentos, estimar números com intervalo e selecionar todas as opções que se aplicam. O d1-2B e o d1-omni-2B também são distribuídos via transformers, com foco em uso corporativo, como triagem automática de tickets, análise de documentos e classificação de conteúdo.
Entenda o contexto
O LFM3 chega em um momento em que grandes modelos generalistas, treinados em infraestruturas massivas na nuvem, dominam o debate em IA, mas enfrentam críticas por custo, latência e privacidade. A aposta da Liquid AI é que modelos menores, especializados e capazes de rodar localmente podem atender melhor a muitos casos de uso do dia a dia, especialmente em dispositivos móveis, casas conectadas, robôs e equipamentos médicos.
Ao permitir fine-tuning em uma única GPU e implantação direta em smartphones, Raspberry Pi 5, laptops, CPUs em nuvem e NPUs, o LFM3 reduz barreiras para empresas que não querem ou não podem manter uma infraestrutura pesada de IA. Setores como tecnologia móvel, automação residencial, robótica, saúde digital e dispositivos de borda tendem a se beneficiar de agentes que entendem texto, imagem e áudio, tomam decisões e interagem em tempo real.
Por outro lado, o avanço de modelos compactos e eficientes aumenta a pressão sobre fornecedores de IAs gigantes e exclusivamente baseadas em nuvem, que podem perder terreno em aplicações sensíveis a custo, latência e privacidade. A empresa aposta que, com a distribuição aberta via Hugging Face e integração nativa com transformers, a adoção da família LFM3 será rápida, puxando uma nova onda de soluções de IA locais, multimodais e mais customizadas.