Estudo de 2026 revela 6 IAs falham ao julgar inovação científica
Pesquisa do Allen Institute for AI mostra que grandes modelos de linguagem são altamente instáveis ao avaliar se uma ideia científica é realmente nova, e lança benchmark, dados e código abertos.
Inteligência Artificial
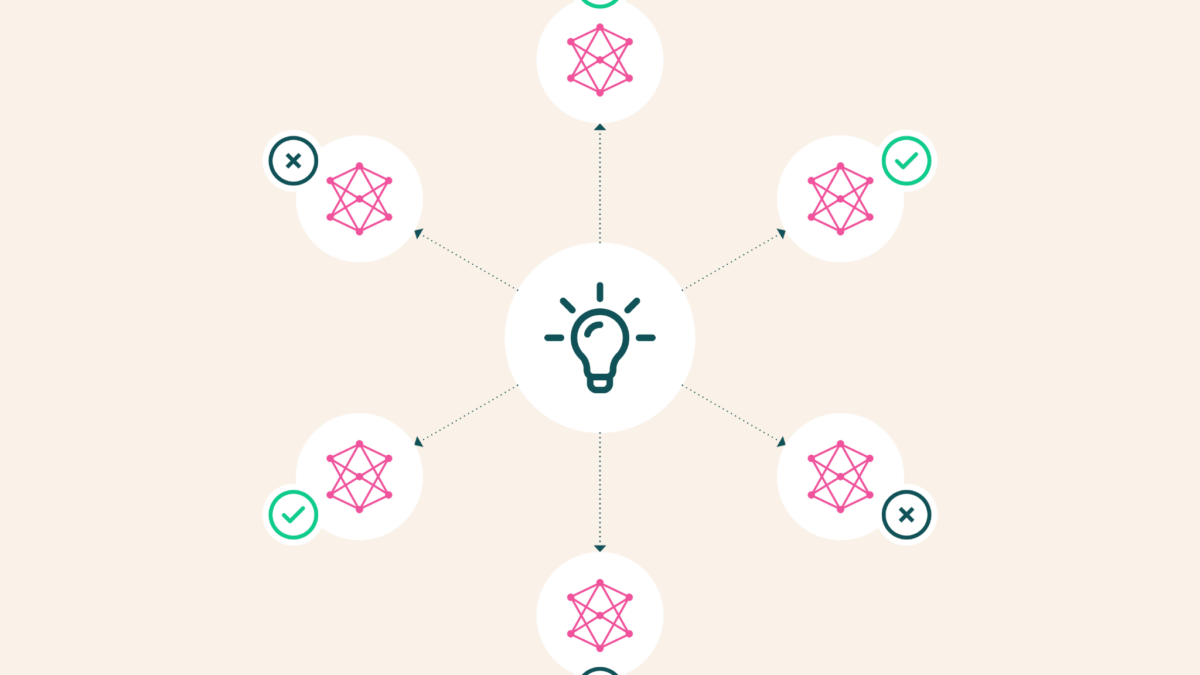
Pesquisa destaca limitações dos modelos de linguagem na avaliação da originalidade científica.
Leia também: Regal lança IA de voz com agentes que garantem metas em chamadas
Pesquisadores do Allen Institute for AI (Ai2) lançaram nesta semana um estudo que coloca em xeque a confiabilidade de grandes modelos de linguagem (LLMs) para julgar a novidade de ideias científicas, mostrando que pequenas mudanças de prompt podem virar completamente o veredito das máquinas sobre o que é ou não original.
LLMs falham como juízes de originalidade
O trabalho, batizado de “Old Ideas, Novel Problems”, avalia seis modelos amplamente usados em pesquisa – GPT-5.1, GPT-5.2, GPT-5.4, Claude Sonnet 4.5, Claude Opus 4.5 e Claude Opus 4.6 – em uma tarefa que virou peça-chave da automação da ciência: decidir se uma ideia de pesquisa realmente traz algo novo ou apenas reempacota conceitos já conhecidos.
Segundo os autores, os resultados são preocupantes. Em uma das experiências, trocar poucas palavras no prompt derruba ou eleva a precisão em mais de 50 pontos percentuais na hora de escolher qual de duas ideias é mais inovadora. “Mudanças pequenas no prompt podem alterar a precisão em mais de 50 pontos percentuais”, registra o estudo do Ai2.
Os pesquisadores testaram variações de prompts, formatos de avaliação (nota absoluta ou comparação entre pares), diferentes orçamentos de raciocínio e o uso de sistemas de recuperação de literatura científica. Em vez de ganhar robustez, os julgadores de novidade mostraram um comportamento altamente instável, com respostas contraditórias para as mesmas ideias sob configurações ligeiramente diferentes.
“Se AI vai desempenhar um papel maior na descoberta científica, precisamos de maneiras mais confiáveis para dizer se está realmente propondo algo novo”, afirmam os pesquisadores do Ai2.
Como o benchmark do Ai2 foi construído
Para medir a capacidade dos LLMs, o Ai2 criou um benchmark baseado em pareceres de revisores de uma grande conferência de inteligência artificial, focando explicitamente o que eles diziam sobre originalidade. Em vez de usar apenas o fato de um artigo ser aceito ou rejeitado, os cientistas mineraram trechos em que os avaliadores apontavam, em texto, se havia ou não contribuição nova.
Desse processo nasceram duas bases humanas. A primeira, de alta novidade, reúne 154 ideias de artigos aceitos entre os 10% melhor avaliados de suas áreas, em que revisores elogiaram a originalidade sem contestação. A segunda, de baixa novidade, agrupa 145 ideias de artigos rejeitados entre os 10% piores, nos quais os pareceres criticavam diretamente a falta de novidade.
Um anotador independente revisou amostras desse material para checar se o sinal de originalidade estava sendo extraído corretamente. Em um segundo cenário, chamado Human+Generated, as 154 ideias humanas mais originais foram pareadas com 154 ideias geradas por um LLM simples, sob a suposição de que as propostas geradas seriam, em média, menos inovadoras.
Com essas coleções, o Ai2 avaliou como os seis julgadores de novidade se saíam tanto em comparações entre ideias humanas quanto em disputas entre ideias humanas e geradas por IA.
Os LLMs conseguem avaliar a novidade de uma ideia de pesquisa com precisão?
De acordo com o estudo do Ai2, ainda não. Os experimentos mostram que os LLMs podem atingir bons números em cenários específicos, mas a precisão desaba assim que se muda o modo de perguntar ou o tipo de conjunto testado, o que torna o uso prático pouco confiável.
Em alguns casos, um mesmo modelo acerta bem quando compara apenas ideias humanas, mas passa a se confundir quando precisa decidir entre uma ideia validada por revisores e outra produzida por IA. Em um experimento, alterar para um prompt mais simples fez a acurácia cair de patamar de excelência para abaixo do nível do acaso, com o modelo invertendo o veredito em mais da metade dos pares avaliados.
Essa sensibilidade extrema às instruções significa que o mesmo sistema pode parecer competente em um teste pontual e falhar dramaticamente em outro, mesmo sem mudança no modelo em si – apenas no texto do comando.
Quais são as limitações dos LLMs ao julgar a originalidade de um trabalho científico?
O estudo identifica várias fragilidades. A primeira é a dependência exagerada de detalhes do prompt: escolhas sutis de redação, de formato da tarefa ou de contexto fornecido geram veredictos radicalmente diferentes para as mesmas ideias.
Outra limitação é a baixa eficácia dos mecanismos de busca de literatura acoplados aos julgadores. A opção de dar ao modelo acesso a artigos relacionados e mais “tempo” de raciocínio não produziu melhorias consistentes. Em experimentos com agentes mais complexos, equipados com busca iterativa em bases como arXiv, o desempenho ficou na mesma faixa ou pior do que o de um Claude Opus 4.6 relativamente simples com um bom prompt. “Dois sistemas especializados tiveram desempenho pior que um modelo simples com prompt”, resumem os resultados do benchmark.
Os autores também mostram que sistemas desenhados especificamente para avaliação de novidade, com arquiteturas e parâmetros próprios para essa tarefa, não foram superiores aos modelos generalistas quando bem orientados. Em muitos cenários, eles custam mais e entregam menos.
Por fim, uma revisão por especialista de casos em que o julgador mais forte errou confirmou que a tarefa é intrinsecamente difícil: até humanos experientes, com leitura de contexto, precisam refletir cuidadosamente para decidir se uma ideia de pesquisa é realmente nova.
Entenda o contexto
O Ai2 vem investindo em sistemas de IA voltados à descoberta científica, como ferramentas que exploram bases de dados, geram hipóteses e sintetizam literatura em teorias candidatas. Em várias dessas aplicações, os LLMs aparecem em duas pontas: ajudam a propor novas ideias e, em seguida, são usados como “juízes” para filtrar o que parece mais promissor.
Esse filtro automatizado é visto como peça-chave para acelerar a ciência, reduzindo o esforço humano na triagem de milhares de propostas e rascunhos de artigos. Se funcionar, pode mudar processos de revisão por pares, seleção de projetos e distribuição de recursos em agências de fomento e instituições acadêmicas.
O estudo do Ai2, porém, indica que a base dessa automação ainda é frágil. Usar julgadores de novidade instáveis pode levar a dois erros graves: rejeitar ideias realmente novas ou promover trabalhos que só reempacotam o que já existe.
É seguro confiar em LLMs para decidir se uma ideia de pesquisa é inédita?
Pelas evidências apresentadas, não é seguro delegar sozinho a esses sistemas a decisão sobre originalidade de pesquisas. O próprio Ai2 alerta que a avaliação de novidade “está longe de ser confiável” e que a comunidade precisa de métodos mais robustos antes de escalar o uso de julgadores automáticos.
Na prática, o recado aos pesquisadores e instituições é tratar esses modelos como ferramentas auxiliares, e não como árbitros finais. A recomendação implícita é combinar IA e avaliação humana, usar múltiplos julgadores e ser transparente sobre configurações de prompts e parâmetros – já que mudanças discretas nessas escolhas podem alterar o destino de uma ideia científica.
Ao liberar o benchmark, os dados e o código, o Ai2 espera que outros grupos testem novos modelos, criem abordagens híbridas e desenvolvam critérios mais estáveis para detectar o que é, de fato, uma ideia inédita na ciência.