CUGA da IBM lidera teste de IA para empresas com 81% de sucesso
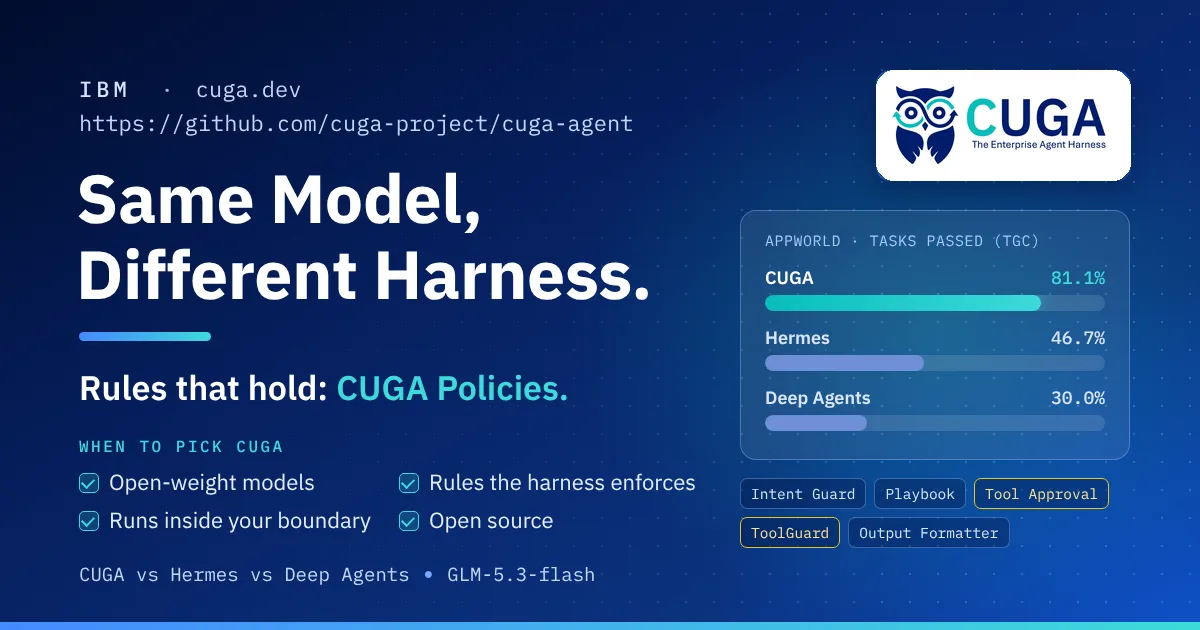
Comparativo entre CUGA, Hermes e Deep Agents com o mesmo modelo GLM-5.3-flash em 90 tarefas do AppWorld mostra que o harness pode levar a conclusão de 30% a 81% das tarefas e coloca CUGA na frente para uso empresarial seguro.
Inteligência Artificial
Teste comparativo destaca a eficácia do CUGA da IBM em tarefas empresariais com alto índice de sucesso.
Leia também: O que o C realmente significa na porta USB-C e por que importa
Um comparativo entre três harnesses de agentes de IA — CUGA, Hermes e Deep Agents — usando o mesmo modelo aberto GLM-5.3-flash em 90 tarefas do benchmark AppWorld mostra que a escolha da “carcaça” que controla o agente pode ser tão decisiva quanto o próprio modelo, com taxas de conclusão que vão de 30% a 81% dependendo da arquitetura usada. Nos cenários que simulam trabalho corporativo, o CUGA, da IBM Research, se destaca como a opção mais consistente e preparada para ambientes com regras rígidas e forte exigência de segurança.
CUGA lidera em consistência nas tarefas do AppWorld
O estudo colocou lado a lado CUGA (IBM Research), Hermes (Nous Research) e Deep Agents (LangChain) em 30 cenários do AppWorld, que reúne 90 tarefas multiaplicação e simula rotinas comuns de automação, como login, leitura de documentação de API, paginação de resultados e alteração de estado em sistemas. O benchmark usa 9 aplicativos e 457 APIs, incluindo email, pagamentos e armazenamento de arquivos.
Em todos os testes, o modelo subjacente foi o mesmo — GLM-5.3-flash — e cada tarefa teve apenas uma tentativa, com avaliação feita pelo framework Harbor. Como o modelo não muda, as diferenças de desempenho vêm exclusivamente do harness, isto é, da forma como cada arquitetura organiza o loop de decisão, a chamada ao modelo e a execução das ações.
O indicador considerado mais relevante pelos pesquisadores é o SGC, que conta quantos cenários tiveram todas as suas variantes de tarefa concluídas com sucesso. Nesse ponto, o CUGA abriu vantagem: foram 20 cenários bem-sucedidos, contra 8 do Hermes e apenas 2 do Deep Agents. Ao olhar o conjunto das tarefas, a taxa de conclusão variou de 30% a 81% conforme o harness.
Para a IBM Research, os resultados reforçam que infraestrutura importa tanto quanto o modelo. “A escolha do harness importa tanto quanto a escolha do modelo”, afirma a equipe. A leitura é que Hermes e Deep Agents seguem fortes em seus nichos de origem — assistentes pessoais sempre ativos e tarefas longas de múltiplas etapas, como pesquisas extensas —, mas não foram desenhados para o tipo de trabalho multi-API com exigência empresarial que o AppWorld tenta aproximar.
Entenda o contexto
Harnesses são o “esqueleto” operacional de agentes de IA: definem como o sistema prepara o contexto, chama o modelo, interpreta a resposta, chama ferramentas e volta a iterar. Comunidades de desenvolvedores listam hoje perto de 200 opções de harnesses, o que torna mais complexa a decisão para empresas que querem automatizar processos com segurança e governança.
Enquanto parte das discussões públicas se concentra em qual modelo é mais poderoso, a pesquisa aponta que arquiteturas e políticas de controle podem mudar completamente o resultado prático — inclusive em tarefas aparentemente simples, como pagar contas ou lidar com dados sensíveis.
Como CUGA aplica regras fora do prompt
No centro da estratégia da IBM está o CUGA (ConfigUrable Generalist Agent), um harness aberto projetado para automação empresarial em ambientes controlados, incluindo nuvens soberanas e redes isoladas (air-gapped), nas quais o sistema não tem acesso direto à internet. O CUGA é pensado para rodar dentro da infraestrutura do cliente, usando modelos abertos ou hospedados.
Cada agente CUGA executa um loop operacional compacto: preparar o contexto, chamar o modelo, executar a ação decidida e repetir o ciclo. Esse mesmo esquema escala de um único agente a cenários com um supervisor (CugaSupervisor) coordenando vários agentes locais ou remotos. A lógica é reduzir o número de decisões deixadas ao modelo e aumentar os pontos em que o harness pode checar e corrigir possíveis erros antes que cheguem ao usuário ou a um sistema crítico.
A diferença central, porém, está na camada de políticas. Em muitas implementações de agentes, regras de negócio como aprovação de pagamentos ou proteção de dados pessoais ficam enterradas no prompt — um bloco de instruções textuais que o modelo pode ignorar, interpretar mal ou sofrer alterações por mensagens maliciosas durante a execução.
O CUGA desloca essas regras para o runtime, fora do prompt. “Políticas em CUGA movem as regras para fora do prompt e para o runtime, garantindo que sejam cumpridas independentemente do modelo”, explica a IBM Research, em referência ao trabalho descrito no artigo “Governance by Construction for Generalist Agents”, publicado em periódico acadêmico da área.
Na prática, as políticas atuam em pontos específicos da execução, com dois grupos principais: mecanismos de orientação, que tentam guiar as decisões do modelo, e mecanismos de aprovação e bloqueio, que impõem travas em ações sensíveis, como autorizar um pagamento ou permitir a saída de informações pessoais identificáveis.
Exemplo: de pagamento indevido a transação controlada
Uma demonstração no chamado Policy Playground ilustra o impacto dessa abordagem. Dois agentes recebem a mesma instrução: “Pay everything I owe.” No cenário sem políticas, o agente paga US$ 90, incluindo um valor que estava negado e em cobrança. Na configuração com políticas, o sistema segura o pagamento para aprovação e libera apenas US$ 10, a quantia devida.
“O agente sem políticas pagou $90, incluindo um valor negado; o agente com políticas segurou o pagamento para aprovação e pagou apenas $10”, registra a demonstração. É esse tipo de comportamento que a IBM quer tornar padrão em rotinas críticas de empresas, como liquidação de transações, acesso a prontuários médicos ou tratamento de dados de clientes.
O que muda para empresas reguladas
Na visão dos pesquisadores, o estudo com o AppWorld reforça que o CUGA é mais adequado a ambientes empresariais com regras estritas e alta demanda de auditabilidade, como bancos, órgãos governamentais e hospitais. “CUGA é para automação empresarial com regras que você pode aplicar”, resume a IBM Research.
Em setores regulados, a exigência vai além de concluir a tarefa: é preciso garantir que cada etapa siga normas internas, legislação de proteção de dados e trilhas de auditoria. Como o CUGA aplica políticas no runtime e permite implantação dentro do perímetro do cliente, inclusive em nuvens soberanas e redes air-gapped, ele se encaixa em estratégias de governança que restringem fortemente o fluxo de dados para fora da organização.
Já Hermes e Deep Agents, apesar do bom desempenho em outros tipos de trabalho, tendem a perder em consistência e segurança quando usados em cenários com múltiplas APIs empresariais e requisitos rígidos de compliance. O próprio estudo reconhece que ambos foram pensados para usos diferentes — Hermes para assistentes pessoais sempre ativos e Deep Agents para fluxos longos de múltiplas etapas —, o que ajuda a explicar os resultados no AppWorld.
A variação na taxa de conclusão, que vai de 30% a 81% conforme o harness, tem impacto direto sobre eficiência operacional, confiabilidade de processos e cumprimento de normas. Em um ambiente corporativo de grande porte, essa diferença pode significar desde filas de atendimento menores até redução de riscos legais.
Limites do estudo e próximos passos
Os próprios autores apontam limitações importantes na comparação: foram apenas 90 tarefas em um único benchmark, com configurações de execução que não são idênticas entre os três harnesses. Além disso, as políticas de governança do CUGA não foram ativadas nos testes, o que significa que o estudo não mede diretamente o efeito da camada de políticas sobre o desempenho em benchmarks.
Mesmo assim, a conclusão central permanece: em um cenário com quase 200 harnesses catalogados em comunidades técnicas, escolher só o modelo deixou de ser suficiente. A arquitetura de controle, a capacidade de coordenar múltiplos agentes e, sobretudo, a forma como regras de negócio são aplicadas passaram a ser peças-chave na decisão técnica de empresas que buscam automação segura.
Do lado da IBM, a expectativa é que a demonstração de escalabilidade do loop operacional do CUGA e da aplicação de políticas fora do prompt estimule adoção em ambientes regulados e influencie o desenho de novas camadas de governança em outros harnesses. A equipe responsável pelos testes se dispõe, inclusive, a rerodar as comparações se a comunidade enviar configurações otimizadas de Hermes ou Deep Agents para o mesmo cenário de avaliação.
Os próximos passos incluem ampliar o conjunto de benchmarks, testar mais tipos de tarefas e incorporar políticas diretamente nas baterias de testes para medir como enforcement e desempenho se combinam no dia a dia das aplicações empresariais.