Google lança novas TPUs 8tx e 8i Max com IA segura e potente
Google amplia a oitava geração de TPUs com quatro sistemas no mesmo ano. Novas 8tx e 8i Max focam em segurança em hardware e janelas de contexto gigantes para agentes de IA.
Tecnologia
Google apresenta TPUs avançadas com foco em segurança e maior capacidade para aplicações de inteligência artificial.
Leia também: SharkNinja para 1/3 da equipe para testar IA e inovar negócios
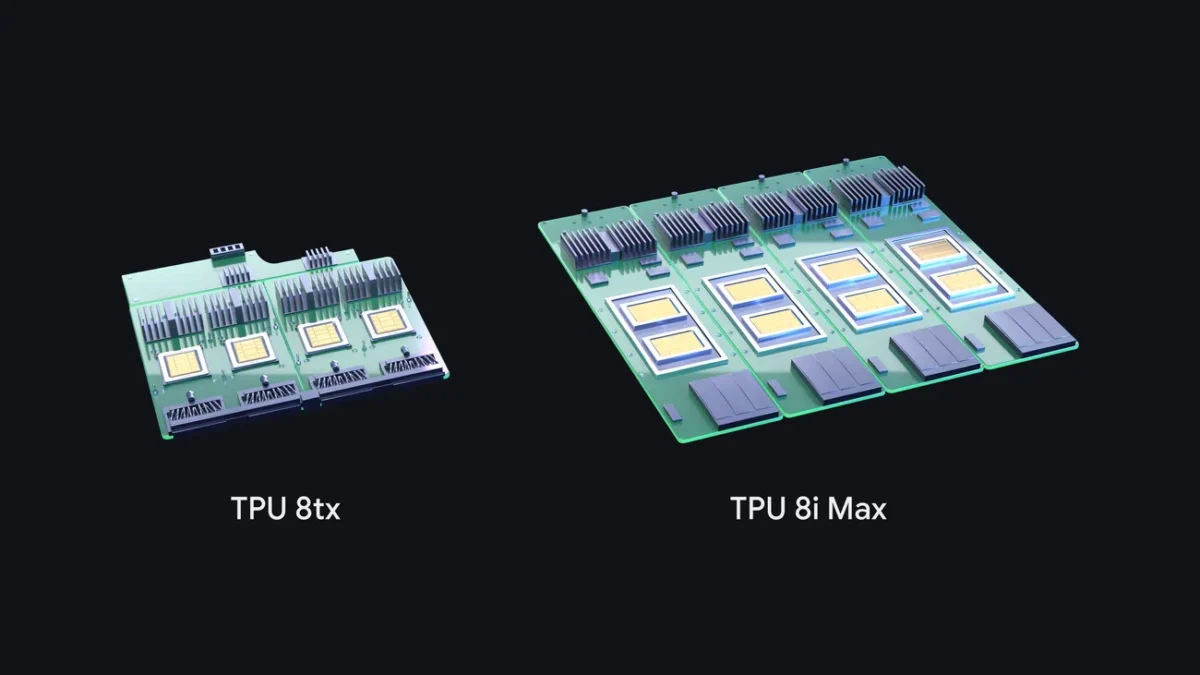
O Google ampliou a oitava geração de seus chips de inteligência artificial e lançou os sistemas TPU 8tx e TPU 8i Max, reforçando o portfólio que já tinha as TPUs 8t e 8i. Com isso, chega a quatro sistemas de Tpus Google em um único ano, em uma ofensiva para atender desde o treinamento em larga escala até a inferência confidencial e o raciocínio sobre janelas de contexto gigantes em nuvem e em data centers privados.
O que são as novas TPUs 8tx e 8i Max lançadas pelo Google?
As TPUs 8tx e 8i Max são novas configurações de hardware da oitava geração de Tpu hardware do Google, desenhadas para lidar com duas dores específicas da era dos agentes de IA: segurança de dados em nível de chip e capacidade de processar contextos enormes sem travar.
A TPU 8tx é voltada para inferência segura e confidencial. Ela usa o mesmo silício da TPU 8t, emparelhado com CPUs AMD EPYC de quinta geração, mas com um diferencial: a proteção de dados sensíveis e pesos de modelos diretamente na camada de hardware. “TPU 8tx builds security directly into the hardware layer, keeping sensitive data and model weights protected and isolated even while in active use”, afirmou o vice-presidente sênior e chief technologist de IA e infraestrutura do Google.
Já a TPU 8i Max é uma versão de altíssima densidade da TPU 8i, criada para superar o chamado “muro de memória”. O Google colocou dois chips 8i em um único pacote, dobrando computação, memória SRAM e largura de banda de memória HBM em relação à 8i, o que permite lidar com janelas de contexto massivas — por exemplo, horas de vídeo, bases de código inteiras ou milhões de tokens de texto processados por agentes autônomos em paralelo.
Com as novidades, a oitava geração fica organizada assim: TPU 8t para treinamento em larga escala, TPU 8i para raciocínio em tempo real, TPU 8tx para computação confidencial e TPU 8i Max para máxima densidade e contextos gigantes.
Entenda o contexto
As TPUs (Tensor Processing Units) nasceram há mais de uma década para acelerar tarefas internas do Google, como reconhecimento de voz e tradução automática. De lá para cá, passaram a treinar e servir modelos como a família Gemini, sustentar workloads agentivos e atender clientes corporativos na Google Cloud, incluindo bancos, empresas de trading, varejistas, laboratórios de pesquisa e universidades.
Hoje, os chips não ficam restritos à nuvem pública: clientes podem instalar TPUs diretamente em seus próprios data centers, algo estratégico para setores regulados que não podem mover dados sensíveis livremente. Segundo o Google, quase 100 clientes já usam TPUs ativamente.
A oitava geração, apresentada ao longo do ano, trouxe primeiro a TPU 8t, focada em treinamento em grande escala, e a 8i, voltada para raciocínio em tempo real. Nessas duas frentes, o Google fala em até 2,7 vezes melhor desempenho de treinamento com a 8t e 80% de melhora no preço/desempenho de inferência com a 8i, frente à geração anterior.
Agora, os sistemas 8tx e 8i Max surgem como “variações” moduladas da mesma base de silício, combinando o chip com diferentes arquiteturas de rede, memória e segurança para responder a novas demandas de mercado — em especial, segurança em hardware para governos e empresas reguladas, e performance em cenários em que dezenas de agentes de IA precisam raciocinar ao mesmo tempo sobre grandes volumes de informação.
Como as TPUs 8tx e 8i Max impactam o desempenho em aplicações avançadas?
A TPU 8tx tenta resolver um dos gargalos mais sensíveis da IA corporativa: como executar modelos avançados sem expor dados confidenciais. Normalmente, a informação é criptografada em disco e em trânsito, mas precisa ser “destravada” na memória durante o processamento. A 8tx mantém a proteção mesmo nesse momento crítico, isolando dados e pesos de modelos enquanto o sistema está em uso, com criptografia e recursos de computação confidencial em nível de hardware.
Além disso, a 8tx usa a mesma rede de baixa latência adotada na TPU 8i para raciocínio em tempo real, o que, segundo o Google, permite até duas vezes menos latência em comparação à 8t, com impacto mínimo no desempenho. Na prática, isso é importante para agentes autônomos que tomam várias decisões em sequência — por exemplo, ao navegar por registros bancários, históricos médicos ou bases jurídicas sensíveis.
Outra consequência dessa combinação de “computação de treinamento” com rede otimizada para inferência é que empresas podem treinar, ajustar e rodar modelos no mesmo sistema, sem ter de mover dados entre clusters distintos. A 8tx permite, por exemplo, fazer fine-tuning com dados privados, destilar modelos grandes em versões menores e treinar agentes por reforço mantendo tudo dentro de um ambiente protegido.
No caso da TPU 8i Max, o foco é manter os chips “alimentados” com dados na mesma velocidade em que conseguem calcular. Ao dobrar a computação e a largura de banda de memória em relação à 8i, o sistema reduz travamentos causados por gargalos de memória, comuns em workloads que envolvem múltiplos agentes analisando longos vídeos, grandes códigos-fonte ou documentos extensos de forma colaborativa.
Como o pacote 8i Max encaixa o dobro de silício na mesma pegada de rack, os data centers conseguem subir muito mais capacidade de IA no mesmo espaço físico e com eficiência energética melhor por watt, algo crucial para nuvens públicas e também para empresas que optam por instalar os racks em infraestrutura própria.
TPUs, IA agentiva e impacto na indústria
A aposta do Google é que a chamada “era agentiva” — em que agentes autônomos criam, decidem, escrevem código e operam sistemas quase sem intervenção humana — vai exigir aceleradores especializados para cada etapa do ciclo de vida da IA.
Nessa visão, a combinação das quatro TPUs de oitava geração cria um “kit completo”: a 8t cuida do treinamento massivo de modelos, a 8i atende as aplicações de baixa latência em produção, a 8tx protege inferências e ajustes de modelos com dados sensíveis, e a 8i Max sustenta workloads que precisam olhar para contextos imensos de uma vez só.
O vice-presidente sênior e chief technologist de IA e infraestrutura do Google resume a estratégia como uma corrida para acompanhar o ritmo do setor: “We’ve expanded our eighth generation TPU portfolio with TPU 8tx and TPU 8i Max, marking four new TPU systems in a single year” e “By combining modular custom silicon with an open and easy-to-use software stack, we can deliver new hardware and system configurations at the pace of the AI industry”.
Para clientes, isso significa mais opções de arquitetura, mas também a necessidade de planejar investimentos em infraestrutura para realmente explorar os novos recursos. Setores como o financeiro, o de saúde e órgãos públicos tendem a se apoiar mais na 8tx, pela camada de confidencialidade embutida, enquanto laboratórios de fronteira, grandes plataformas digitais e empresas que desenvolvem modelos próprios podem mirar principalmente na 8t e na 8i Max para treinar e operar modelos cada vez maiores.
Do lado dos desenvolvedores, o Google vem tentando reduzir a barreira de entrada às TPUs com uma pilha de software mais aberta e atualizações de suporte a frameworks populares como PyTorch. A meta declarada é fazer com que programar para TPUs se aproxime da experiência de usar hardware de uso geral, ampliando o número de equipes capazes de migrar seus workloads para os aceleradores da empresa.
Num mercado pressionado pela demanda por capacidade de IA e por requisitos de segurança mais rígidos, os quatro sistemas de TPUs de oitava geração colocam o Google em posição mais agressiva na disputa com outros fabricantes de chips e provedores de nuvem. A empresa ainda vai liberar os novos sistemas de forma gradual em seus data centers e na infraestrutura dos clientes, e diz que pretende seguir ajustando segurança e escalabilidade a partir do feedback de organizações externas.