Google lança TPUs 8tx e 8i Max para IA avançada e segura em 2026
Google Cloud amplia a 8ª geração de TPUs com os sistemas 8tx e 8i Max, focados em segurança de dados e janelas de contexto gigantes, e reforça estratégia de IA agentiva.
Tecnologia
Google Cloud apresenta novos TPUs que prometem maior segurança e capacidade para aplicações avançadas de inteligência artificial.
Leia também: SharkNinja para 1/3 da equipe para testar IA e inovar negócios
O Google Cloud ampliou sua oitava geração de unidades de processamento tensorial com o lançamento dos sistemas TPU 8tx e TPU 8i Max, voltados a cargas de trabalho de inteligência artificial mais complexas e agentivas, com foco em segurança de dados sensíveis e em janelas de contexto gigantes para raciocínio em larga escala.
O que são os novos TPUs 8tx e 8i Max?
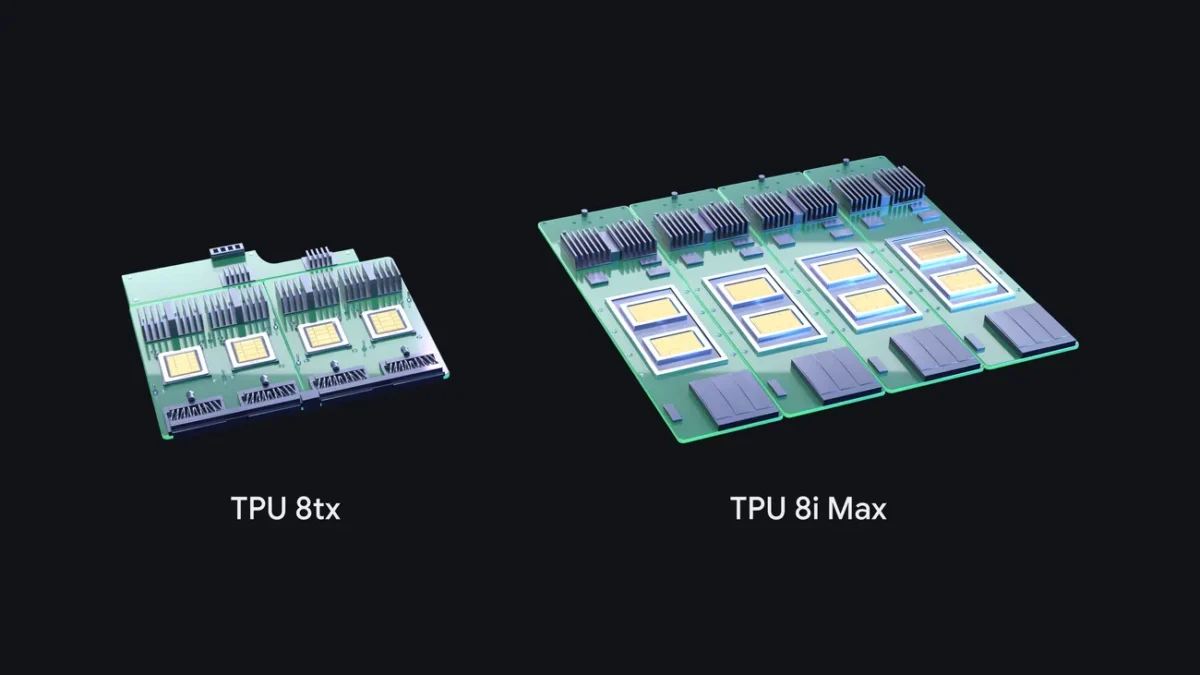
Os TPUs 8tx e 8i Max são dois novos sistemas da oitava geração de aceleradores de IA do Google, projetados para necessidades diferentes: o 8tx mira inferência segura e confidencial, enquanto o 8i Max é voltado a modelos que precisam analisar grandes volumes de dados de uma vez, com altíssima densidade computacional por rack.
Com eles, o portfólio de oitava geração passa a contar com quatro sistemas no total — TPU 8t, 8i, 8tx e 8i Max — algo inédito para a empresa em um único ano. Segundo o Google, cerca de 100 clientes já usam TPUs, incluindo laboratórios de fronteira em IA, firmas de trading, grandes varejistas e universidades.
Os novos sistemas foram desenvolvidos em conjunto pelas equipes de Google Cloud, Google DeepMind e times de hardware e software de infraestrutura, e incorporam feedback direto de clientes de setores regulados e de pesquisa avançada.
TPU 8tx foca em segurança e confidencialidade
O TPU 8tx é descrito pelo Google como um sistema otimizado para inferência segura e confidencial, também apto para treinamentos de menor escala. Ele foi pensado para governos e empresas de setores como finanças e saúde, que operam modelos proprietários e agentes autônomos sobre dados altamente sensíveis.
Baseado no mesmo chip do TPU 8t e emparelhado com CPUs AMD EPYC de quinta geração, o 8tx adiciona uma camada de proteção diretamente no hardware, impedindo que dados e pesos de modelos fiquem expostos mesmo durante o uso ativo.
“TPU 8tx builds security directly into the hardware layer, keeping sensitive data and model weights protected and isolated even while in active use”, afirmou o vice-presidente sênior e chief technologist de IA e Infraestrutura do Google Cloud.
Na prática, isso permite que dados normalmente apenas criptografados em repouso ou em trânsito permaneçam protegidos também na memória, durante o processamento. O sistema também usa a rede de baixa latência Boardfly, criada para raciocínio em tempo real, o que garante, segundo o Google, até duas vezes menos latência em relação ao TPU 8t, com impacto mínimo no desempenho.
Ao combinar capacidade de treinamento com uma rede de inferência rápida, o 8tx permite que empresas treinem, ajustem e executem modelos no mesmo ambiente, sem mover dados sensíveis entre clusters separados. Isso vale para tarefas como fine-tuning privado com dados internos, destilação de modelos grandes em versões menores e treinamento de agentes via aprendizado por reforço.
TPU 8i Max mira janelas de contexto gigantes
Já o TPU 8i Max foi desenhado para driblar o chamado “muro de memória”, quando o gargalo deixa de ser o poder de cálculo e passa a ser a capacidade de o sistema alimentar os chips com dados na velocidade necessária. Esse cenário se torna comum em cargas agentivas em que dezenas de agentes de IA trabalham ao mesmo tempo sobre uma base de código inteira, horas de vídeo ou grandes coleções de documentos.
Para isso, o Google combinou dois chips TPU 8i de baixa latência em um único pacote. O 8i Max dobra capacidade de computação, memória SRAM e largura de banda de memória HBM em relação ao 8i, mantendo o mesmo espaço físico no rack. Com isso, data centers podem instalar bem mais potência de processamento por metro quadrado e por watt.
O resultado, segundo a empresa, é um sistema capaz de sustentar janelas de contexto massivas — essenciais para modelos que precisam “lembrar” e raciocinar sobre grandes volumes de informação simultaneamente — sem travamentos causados por falta de memória ou de banda.
Entenda o contexto
Os TPUs surgiram há mais de uma década para atender demandas internas do Google, como reconhecimento de voz e tradução automática. Desde então, a tecnologia foi evoluindo até se tornar peça central no treinamento e na operação de modelos generativos como a família Gemini, além de passar a ser oferecida a clientes de nuvem e, mais recentemente, para implantação em data centers próprios.
Na oitava geração, apresentada inicialmente em uma conferência de infraestrutura em abril, o Google trouxe os sistemas TPU 8t e 8i. O 8t, voltado a treinamento em grande escala, entrega até 2,7 vezes mais desempenho que a geração anterior; o 8i, focado em raciocínio em tempo real, promete melhoria de 80% em preço por desempenho de inferência.
Agora, com 8tx e 8i Max, o portfólio se fragmenta em quatro sistemas, cada um mirando uma etapa do ciclo de vida de agentes de IA: o 8t para treinar modelos em larga escala, o 8i para inferência de baixa latência, o 8tx para computação confidencial e o 8i Max para janelas de contexto gigantes e máxima densidade de computação por rack.
“We made a foundational bet on system balance and modularity, architecting our TPUs as building blocks as part of our AI Hypercomputer, so engineers could rapidly adjust packaging, high-speed memory, optical networking, and security around them”, disse o chief technologist de IA e Infraestrutura. Segundo ele, essa abordagem permite entregar “supercomputadores especializados em meses, em vez de anos”.
Concorrência pressionada e impacto para clientes
A estratégia reforça a aposta do Google em modularidade e em um ecossistema de software aberto, com suporte a frameworks como PyTorch, para reduzir barreiras de entrada ao uso de TPUs. A empresa afirma que sua pilha de software foi redesenhada para aproximar a experiência de desenvolvimento da de hardware genérico, facilitando a migração de workloads.
Para empresas que lidam com dados regulados e modelos proprietários, o 8tx atende à demanda por segurança de hardware, reduzindo o risco de vazamentos e ataques durante a execução de modelos avançados e agentes autônomos. Já o 8i Max mira segmentos em que o gargalo é o volume de dados processado de uma vez, como pesquisa acadêmica em larga escala, análises de mercado em tempo real e motores de recomendação sofisticados no varejo.
A possibilidade de entregar novas configurações de sistema em poucos meses, combinando o mesmo chip com diferentes empacotamentos, redes, memória e camadas de segurança, também aumenta a pressão sobre concorrentes no mercado de hardware para IA, que precisam responder com ofertas igualmente flexíveis.
Segundo o Google, a tendência é que o uso de TPUs se expanda além da nuvem pública, com mais clientes levando os sistemas para data centers próprios e arquiteturas híbridas, especialmente em setores em que a localização física dos dados ainda é um requisito regulatório.