Mirendil lança Fern 0.1, IA que processa 10 mi tokens de código
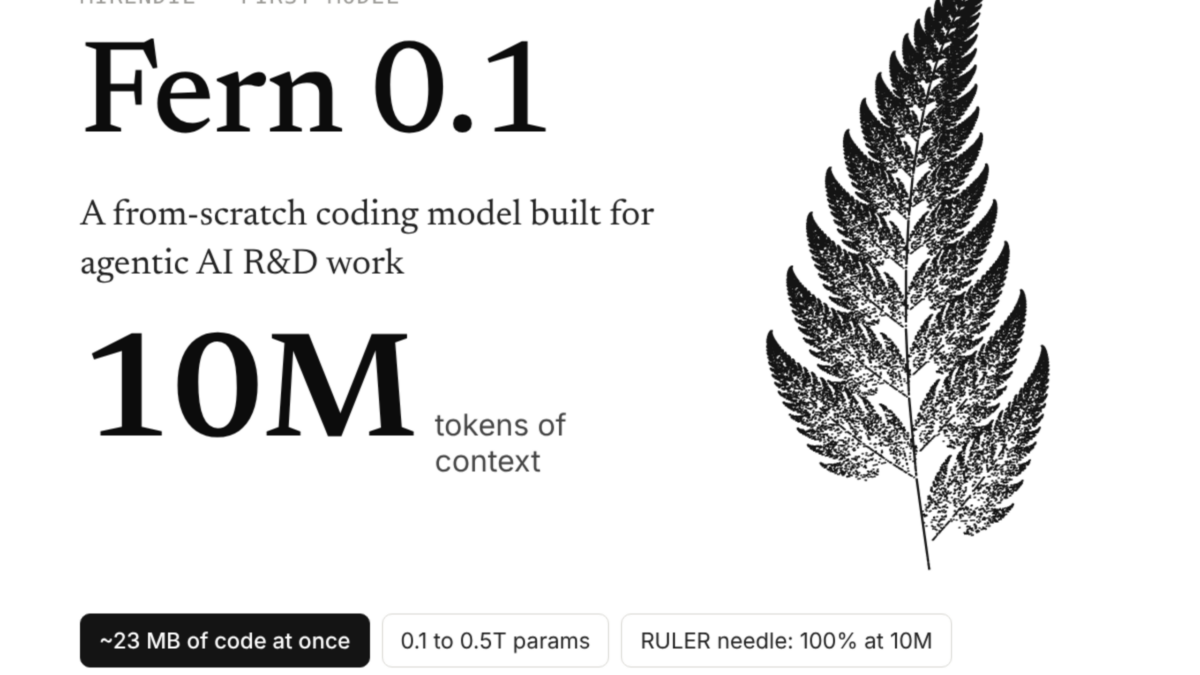
Laboratório Mirendil apresenta Fern 0.1, modelo de linguagem focado em código com janela de contexto de 10 milhões de tokens, capaz de analisar até 23 MB de código em uma só vez.
Inteligência Artificial
Fern 0.1 é um modelo inovador que amplia a capacidade de análise de códigos com uma janela de contexto de 10 milhões de tokens.
Leia também: Sondas da NASA em Marte operam há 20 anos e redefinem missões
A Mirendil anunciou nesta semana o Fern 0.1, seu primeiro modelo de linguagem voltado para codificação, com uma janela de contexto de até 10 milhões de tokens e capacidade para processar, de uma só vez, cerca de 23 MB de código — o equivalente a meio milhão de linhas — em trabalhos de pesquisa e desenvolvimento em inteligência artificial.
Modelo lê repositórios inteiros em uma única passada
Com o Fern 0.1, desenvolvedores e pesquisadores podem carregar repositórios completos, logs extensos de treinamento ou dias de registros de agentes em uma única janela de contexto, sem precisar fatiar os dados em partes menores. Na prática, isso permite depurar sistemas grandes, analisar o comportamento de agentes ao longo de longos períodos e investigar falhas raras com muito mais contexto disponível.
Segundo a Mirendil, “Fern é o primeiro modelo, construído a partir do Mirendil-Base após uma breve rodada de pós-treinamento”. O laboratório enfatiza que o modelo não foi pensado para chat generalista, mas para tarefas técnicas de desenvolvimento de software, pesquisa em IA e engenharia de dados que exigem análise profunda de bases de código extensas.
Nos benchmarks de contexto longo, a empresa afirma que “Fern 0.1 supera Inkling e Nemotron 3 Ultra em 4 de 5 testes e empata com Beam em um deles”, indicando vantagem justamente quando a janela de contexto se torna muito grande. Em tarefas de programação, o modelo atinge 76,5 pontos no conjunto SWE-Pro v2 Hard — em linha com o Beam — e 73,4 pontos no SWE-Bench Verified, resultado considerado competitivo, ainda que abaixo do Beam, que marca 81,6.
Como o Fern 0.1 foi treinado
O Fern 0.1 nasce do Mirendil-Base, pré-treinado ao longo de 3,5 meses por um único pesquisador, com custo computacional total inferior a US$ 10 milhões, incluindo experimentos, uso de agentes e processamento de dados. Os desenvolvedores descrevem uma estratégia fortemente automatizada: “Mais de 99% do código foi escrito por agentes de IA, com um pesquisador decidindo o que tentar e quando intervir”.
Todo o treinamento foi feito sobre dados públicos, como repositórios do GitHub, páginas abertas na web e conjuntos de dados disponíveis publicamente. A Mirendil afirma não ter usado dados sintéticos, licenciados ou técnicas de destilação, o que tende a facilitar a adoção em ambientes acadêmicos e corporativos mais sensíveis à origem dos dados.
O código do modelo foi desenvolvido do zero em PyTorch e JAX, duas das principais plataformas de computação de alto desempenho para aprendizado de máquina, o que pode simplificar a integração com pipelines já usados por equipes de pesquisa.
Desempenho melhora com contexto cada vez maior
Em testes internos de predição de próximo token nos próprios repositórios da empresa, concatenados em um fluxo de 42,9 MB, a Mirendil mediu a perda (cross-entropy, em bits por byte) do modelo em diferentes tamanhos de janela. “A perda do Fern caiu de 0,246 em uma janela de 32K bytes para 0,155 em 16M e 23M bytes”, relata o laboratório.
Esse comportamento indica que o Fern 0.1 se beneficia justamente de janelas muito amplas: mesmo que não seja o melhor entre os concorrentes em contextos mais curtos, a curva de desempenho segue melhorando quando outros modelos já atingem o limite de contexto. Em benchmarks padrão de contexto longo, como o RULER, o Mirendil-Base mantém boa capacidade de recuperação de informação em janelas grandes, embora a acurácia de raciocínio em múltiplas etapas caia em 10 milhões de tokens, cenário em que cada medição usa menos exemplos de teste.
Entenda o contexto
O lançamento do Fern 0.1 acontece em um momento em que laboratórios de IA disputam quem consegue ampliar mais a janela de contexto de seus modelos, isto é, o volume de texto ou código que pode ser considerado de uma vez só. Para usos de consumo, como assistentes de texto ou chat, janelas de centenas de milhares de tokens já abrem novas possibilidades; para pesquisa em IA, depuração de sistemas complexos e análise de logs, a fronteira agora se desloca para milhões de tokens.
Ao focar explicitamente em código e em aplicações de pesquisa, a Mirendil tenta ocupar um nicho técnico em que a capacidade de olhar para repositórios e históricos inteiros é mais valiosa do que a habilidade de conversar em linguagem natural. Isso também reduz expectativas em torno de aplicações mais amplas, como atendimento ao consumidor, e posiciona o Fern como ferramenta especializada para times de engenharia e data science.
Planos para modelos ainda maiores
O Fern é apresentado como o menor de uma linha de três modelos. O Mirendil-Base-Large, com entre 0,5 e 2 trilhões de parâmetros, já tem mais de 80% do pré-treinamento concluído. O Mirendil-Base-XL, projetado para a faixa de 2 a 10 trilhões de parâmetros, passou de 20% dessa mesma etapa.
A expectativa é que esses modelos maiores ampliem ainda mais as capacidades de contexto e qualidade de geração, inclusive em comparação com grandes modelos abertos e sistemas de fronteira mantidos por outras empresas. A Mirendil promete divulgar resultados mais detalhados sobre o desempenho do Fern 0.1 em cenários de contexto longo e convida interessados a solicitar acesso antecipado e acompanhar as próximas atualizações em comunidades de aprendizado de máquina.
Para profissionais como o cientista de dados Michal Sutter, que atua com estatística, machine learning e engenharia de dados, modelos com janelas de 10 milhões de tokens tendem a mudar a forma de trabalhar com bases de código e logs de produção, aproximando a análise automatizada da escala real dos sistemas modernos.