NVIDIA lança Kumo Relational para predições em bancos de dados
NVIDIA lança o Kumo Relational, modelo pré-treinado que faz predições diretamente em bancos de dados relacionais, supera pipelines clássicos e elimina semanas de engenharia.
Tecnologia
Novo modelo da NVIDIA revoluciona análises ao integrar predições diretamente em bancos relacionais, otimizando processos tradicionais.
Leia também: PHP corrige falhas graves que permitem invasão remota
A NVIDIA lançou hoje o Kumo Relational, um modelo de fundação pré-treinado para dados relacionais que faz predições diretamente em bancos de dados empresariais, sem precisar de treinamento específico, engenharia de características ou aplanamento de tabelas, e já supera técnicas tradicionais em benchmarks amplos.
Modelo pré-treinado troca projetos longos por uma única consulta
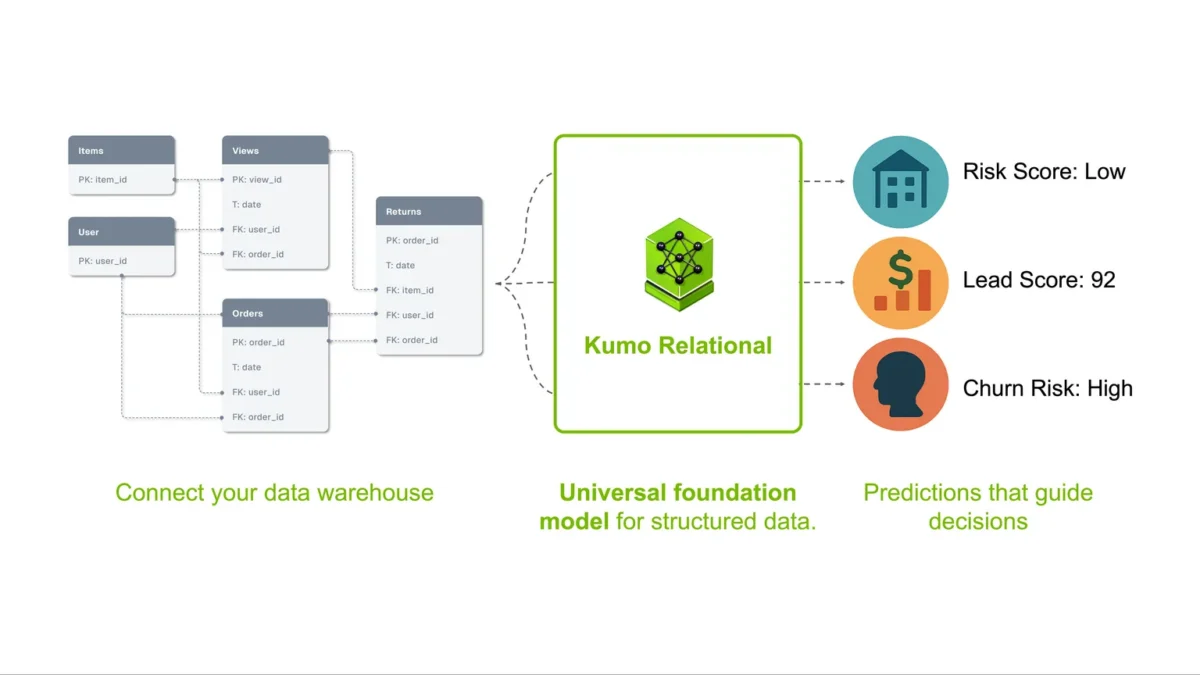
Voltado para bancos de dados relacionais clássicos — com múltiplas tabelas ligadas por chaves estrangeiras e dados ao longo do tempo — o Kumo Relational transforma tarefas que costumavam exigir semanas de trabalho em uma única consulta preditiva. Em vez de projetar features manualmente e treinar modelos separados para cada caso de uso, equipes de dados passam a descrever o que querem prever, enquanto o modelo cuida do restante.
Segundo a NVIDIA, o Kumo Relational é “o primeiro modelo de fundação few-shot que supera o aprendizado supervisionado em benchmarks relacionais comuns”. Em uma bateria de 41 tarefas em 15 bases de dados, a empresa afirma que ele “supera modelos profundos supervisionados e pipelines especializados de árvores de decisão”. No benchmark empresarial SAP SALT, o modelo “supera ensembles AutoGluon em 8 pontos percentuais de mean reciprocal rank, chegando a 13 pontos após fine-tuning”.
Na prática, um único modelo pré-treinado substitui pipelines separados para tarefas como previsão de churn, detecção de fraude, recomendação de produtos ou gestão de demanda. “Um novo modelo pré-treinado substitui pipelines separados para tarefas individuais, transformando predições em consultas simples”, descreve a NVIDIA na documentação técnica.
Como o Kumo Relational faz predições direto no banco
O Kumo Relational é treinado em dados relacionais sintéticos que simulam bases empresariais reais. Em produção, ele se conecta ao banco de dados, recebe uma consulta descritiva do que deve ser previsto e realiza a inferência em uma única passagem, sem necessidade de treinamento adicional.
Em vez de exigir que engenheiros aplainem o banco em uma tabela única, com agregações manuais como “valor médio de compra nos últimos 30 dias”, o modelo lê as próprias estruturas relacionais: “Kumo Relational opera diretamente no banco de dados, respeitando tabelas, chaves estrangeiras e timestamps, sem a necessidade de aplanar dados”, afirma a companhia.
O motor de inferência usa aprendizado em contexto. Para cada consulta preditiva, o sistema coleta até 10.000 exemplos históricos relacionados — pequenos “subgrafos” ao redor de entidades, em momentos específicos — e apresenta esses casos ao modelo, junto com seus resultados conhecidos, como “este cliente cancelou o serviço” ou “este item vendeu 142 unidades”. “O modelo lê até 10.000 exemplos de contexto para cada inferência, adaptando-se a cada nova tarefa por aprendizado em contexto”, diz a documentação.
Essas consultas são escritas em PQL (Predictive Query Language), linguagem declarativa em que o usuário indica o que deseja prever, não como construir o pipeline. Para tarefas temporais, o sistema reencena estados passados do banco, garantindo que a predição use apenas dados anteriores ao evento-alvo e evitando vazamento de informação.
Arquitetura combina atenção em tabelas, grafos e exemplos
Por baixo do capô, a arquitetura do Kumo Relational mistura diferentes tipos de mecanismos de atenção para lidar com a complexidade dos bancos empresariais. Primeiro, um módulo leve processa cada tabela isoladamente, alternando atenção por colunas e por linhas para identificar quais campos e registros importam mais para a tarefa atual, filtrando ruído antes de seguir.
Em seguida, um módulo maior espalha os embeddings de linhas pela estrutura relacional, usando atenção em grafos nas relações de chave primária e estrangeira, intercalada com atenção cruzada entre exemplos de contexto. É nessa etapa que o modelo relaciona, por exemplo, o perfil de um usuário com o seu histórico de transações, sem pagar o custo de processar célula a célula — desenho pensado para escalar a contextos maiores e subgrafos mais profundos.
Graças a esse arranjo, o Kumo Relational escala para bases com mais de 500 bilhões de linhas, de acordo com a NVIDIA, mantendo a capacidade de responder em uma única passagem de inferência. Quando a precisão máxima é crítica, o modelo pré-treinado pode ainda ser ajustado (fine-tuning) em um conjunto de dados específico, ampliando os ganhos observados nos testes padronizados.
Entenda o contexto
Modelagem preditiva em bancos de dados relacionais sempre foi um gargalo para empresas que dependem de decisões em tempo quase real. Em cenários de finanças, varejo, telecomunicações ou manufatura, é comum que equipes de ciência de dados gastem semanas projetando características, limpando dados, ajustando modelos e costurando pipelines com várias etapas até colocar uma solução de pé.
Na última década, modelos de fundação mudaram esse cenário para linguagem natural e visão: deixaram obsoletos muitos pipelines de processamento manual, oferecendo mais precisão, implantação mais simples e flexibilidade para novos casos de uso. O Kumo Relational leva lógica parecida para dados estruturados, que seguem dominando sistemas centrais de negócios.
Com um modelo único que já chega a benchmarks competitivos e se conecta direto ao banco, a própria definição de “projeto de machine learning” muda. Em vez de abrir uma nova frente de meses de trabalho a cada demanda de negócio, times passam a tratar novas predições como consultas a um serviço já disponível.
Impacto para empresas e equipes de dados
O potencial imediato do Kumo Relational é aliviar o trabalho pesado de engenharia que hoje limita o número de casos de uso que uma equipe de dados consegue atender. Processos como previsão de risco de inadimplência, probabilidade de cancelamento de clientes, rotatividade de funcionários, demanda por produtos ou sinalização de fraudes podem ser prototipados com muito menos fricção.
Além das equipes humanas, a NVIDIA destaca o uso por agentes automatizados, que já se apoiam em grandes modelos de linguagem para ler documentos, escrever código ou orquestrar fluxos de trabalho. Com o Kumo Relational acessível via APIs e pela linguagem PQL, esses agentes passam a não apenas consultar bancos de dados, mas também antecipar o que tende a acontecer — e agir com base nessas previsões.
A empresa disponibiliza o modelo de duas formas principais: pela biblioteca open-source GPU-native structured-data-models, voltada a desenvolvedores que querem integrar diretamente em seus ambientes, e pela plataforma NVIDIA NIM, que oferece o Kumo Relational como serviço.
Do lado do mercado, fornecedores de soluções baseadas em pipelines tradicionais — combinando engenharia de características manual, modelos supervisionados como XGBoost e automação via AutoML — tendem a ser pressionados por um modelo pré-treinado que, nos testes divulgados, entrega melhor desempenho com menos esforço de implementação.
O próximo passo deve ser a validação em ambientes produtivos, à medida que empresas experimentarem o Kumo Relational em dados reais. A adoção em larga escala depende tanto da comprovação de ganhos de precisão e custo quanto da capacidade das equipes de se adaptarem a um paradigma em que o trabalho se desloca da construção minuciosa de pipelines para o desenho de boas consultas preditivas e a interpretação cuidadosa dos resultados.
Fonte: matéria original