OpenAI e Anthropic cortam até 80% e mudam mercado de LLMs
OpenAI e Anthropic cortam em até 80% os preços de uso de seus principais modelos de linguagem. Queda histórica barateia agentes de código e muda disputa global em IA.
Inteligência Artificial
Reduções significativas nos preços dos modelos de linguagem impulsionam a competitividade e acessibilidade no setor de IA.
Leia também: Economista diz que IA não gera lucro fora do setor de tecnologia
OpenAI e Anthropic vêm promovendo, desde junho, uma sequência de cortes agressivos de preços em seus principais modelos de linguagem, como GPT-5.6 Sol e Luna, GPT-6 Astra, GPT-6 Sol, Claude Sonnet 5, Claude Opus 5, Opus 5.5 e Fable 5.1. As reduções, que chegam a 80% em alguns casos e atingem sobretudo o custo de leitura de cache — a parte mais cara em aplicações com agentes de codificação — estão redesenhando o mercado global de inteligência artificial ao baratear de forma inédita o uso de LLMs avançados.
Por que OpenAI e Anthropic reduziram os preços dos seus modelos de linguagem em até 80%?
Os cortes de até 80% respondem a uma combinação de competição direta entre grandes fornecedores de IA, avanço na eficiência computacional dos modelos e pressão de rivais com preços agressivos, incluindo modelos de código aberto. Ao baratear entrada, saída e, principalmente, leitura de cache, OpenAI e Anthropic tentam manter liderança num mercado em que trocar de modelo virou quase tão simples quanto trocar de endpoint de API.
O movimento começou com os lançamentos da família GPT-5.6, da OpenAI. O GPT-5.6 Sol estreou com preços de US$ 5 por milhão de tokens de entrada, US$ 30 por milhão de saída e US$ 0,50 para leitura de cache. O GPT-5.6 Luna, voltado a usos mais baratos, saiu a US$ 1/US$ 6/US$ 0,10. Poucos meses depois, a OpenAI cortou o preço do Luna em 80%, para US$ 0,20/US$ 1,20/US$ 0,02, e reduziu o Sol em cerca de 20%, para US$ 4/US$ 20/US$ 0,40.
Uma análise de custo-benefício sobre o Luna pós-corte resumiu a lógica competitiva: “If OpenAI didn’t do the 80% price cut, it would have lost to DeepSeek V4 Pro”, em referência a um modelo de outra desenvolvedora que vinha pressionando por baixo com desempenho aceitável e cache muito barato.
Do lado da Anthropic, o Claude Sonnet 5 chegou com preço promocional de US$ 2/US$ 10/US$ 0,20, que seria temporário, mas acabou tornando-se permanente. O Claude Opus 5 foi lançado a US$ 5/US$ 25/US$ 0,50, patamar semelhante ao GPT-5.6 Sol original, mas também entrou rapidamente na onda de descontos.
A disputa escalou com modelos ainda mais novos. A OpenAI apresentou o GPT-6 Astra a US$ 10/US$ 50/US$ 1 e, em seguida, o GPT-6 Sol a um valor considerado “chocante” no setor: US$ 2/US$ 10/US$ 0,20, metade do preço do GPT-5.6 Sol mesmo após o desconto. O GPT-6 Luna veio ainda mais barato, a US$ 0,10/US$ 0,50/US$ 0,01.
Na mesma data, a Anthropic respondeu com o Claude Opus 5.5 por US$ 4/US$ 20/US$ 0,20 e explicou a lógica: “Opus 5.5 requires less compute to serve than Opus 5, and its pricing reflects that”. A empresa afirma que a nova versão demanda menos recursos computacionais para operar e, por isso, pode ser oferecida com uma redução total de custo estimada entre 40% e 60%, mesmo entregando desempenho superior ao de modelos como o Fable 5.1.
Na prática, as reduções só são sustentáveis porque os modelos mais novos são mais eficientes por token gerado, consomem menos computação por requisição e se beneficiam de arquiteturas e infraestruturas de inferência mais otimizadas. Ao mesmo tempo, a concorrência de modelos abertos e de novos players, que conseguem oferecer qualidade “boa o suficiente” a preços irrisórios, impede aumentos e força cortes sucessivos.
Entenda o contexto
Um dos pontos centrais dessa guerra de preços está na leitura de cache, mecanismo usado para reaproveitar o histórico de conversas em aplicações com agentes de IA, especialmente os voltados a tarefas de código. Nesses cenários, entre 96% e 99% do custo de tokens vem justamente da leitura de cache, não dos tokens “novos” de entrada ou saída, porque a cada interação o sistema relê praticamente toda a conversa anterior.
Ao lançar o Fable 5.1, com preço de US$ 10/US$ 50/US$ 0,25, a Anthropic manteve o custo de entrada e saída em relação à geração anterior, mas cortou em 75% o valor de cache. Em aplicações com agentes, isso se traduz em queda total de 70% a 75% na conta final, mesmo com pouca mudança nos outros componentes.
A OpenAI seguiu caminho parecido com o GPT-6.1 Sol. Depois de o GPT-6 Sol decepcionar em desempenho, a empresa apresentou o 6.1 Sol com performance mais próxima do GPT-6 Astra e, ao mesmo tempo, reduziu pela metade o custo de cache para US$ 0,10, mantendo o resto da tabela em US$ 2/US$ 10. Somados aos cortes anteriores, a família Sol ficou cerca de 75% mais barata em relação ao ponto de partida em junho.
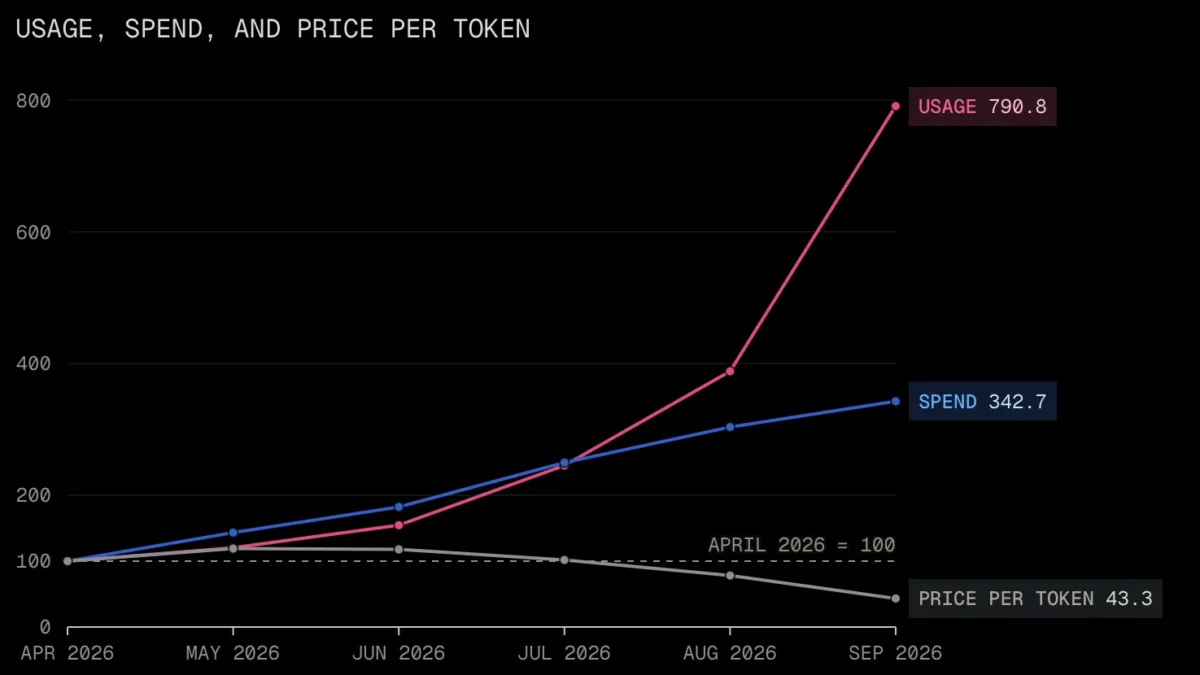
Dados do gateway de modelos de IA da Vercel ajudam a dimensionar o impacto: o custo médio por token hoje está em apenas 43,3% do que era em abril, ou seja, menos da metade. Ainda assim, o gasto agregado com modelos subiu, porque o uso explodiu e os sistemas ficaram melhores mais rápido do que ficaram baratos.
Anthropic realmente cortou os preços dos seus LLMs?
Sim. A Anthropic transformou em definitivos descontos que haviam sido anunciados como temporários, introduziu modelos intermediários com preços mais agressivos e reduziu de forma forte o custo de cache em suas ofertas topo de linha.
O Claude Sonnet 5 estreou como um modelo “de meio de tabela”, entre a linha Sonnet e a Opus, e foi lançado com preço promocional de US$ 2 por milhão de tokens de entrada, US$ 10 por milhão de saída e US$ 0,20 para cache. A empresa sinalizava um reajuste para cima, mas acabou mantendo esses valores, consolidando o Sonnet 5 como uma opção mais barata com desempenho próximo ao da família Opus.
O Claude Opus 5, por sua vez, veio a US$ 5/US$ 25/US$ 0,50, espelhando a faixa do GPT-5.6 Sol no lançamento e mirando diretamente o mercado de agentes de codificação avançados. Na sequência, a Anthropic lançou o Fable 5.1 por US$ 10/US$ 50/US$ 0,25, com uma queda de 75% no custo de leitura de cache em relação ao modelo anterior, mantendo ou melhorando todos os benchmarks.
A guinada mais clara é o Claude Opus 5.5, com preços de US$ 4/US$ 20/US$ 0,20. Além da frase explícita sobre menor necessidade de computação para rodar o modelo, a estrutura de cobrança mostra a estratégia: corte de 20% em entrada e saída, e redução ainda maior em cache, levando a uma economia total estimada entre 40% e 60% frente ao Opus 5, sem perda de qualidade — pelo contrário, com avanços de desempenho.
Esses movimentos indicam que a Anthropic não está apenas reagindo à OpenAI, mas também tentando se diferenciar com modelos de alta qualidade e custo mais previsível para uso intensivo, especialmente em agentes que mantêm longos históricos de contexto.
Quais os impactos dessas reduções de preço para os usuários dos LLMs?
Para quem usa LLMs em escala — de startups a grandes empresas —, a queda de preços muda a equação econômica de vários projetos. Em aplicações com agentes de codificação, por exemplo, uma redução de 70% a 75% no custo total torna viáveis fluxos contínuos de análise de código, revisão automatizada e testes assistidos que antes ficavam caros demais para rodar o dia inteiro.
Com GPT-6 Sol cobrando US$ 2/US$ 10/US$ 0,20 e o GPT-6 Luna indo a US$ 0,10/US$ 0,50/US$ 0,01, desenvolvedores passam a experimentar mais, plugar modelos em ferramentas de produtividade, criar agentes especializados e iterar rapidamente, sem medo de estouro de orçamento. Na Anthropic, Fable 5.1 e Opus 5.5 cumprem papel semelhante, permitindo uso intensivo em contextos longos graças ao cache muito mais barato.
Do lado dos pequenos provedores de IA e de modelos open weight, o cenário fica mais desafiador. Muitos vinham atraindo usuários com preços agressivos, em especial no cache, mas agora precisam concorrer com gigantes que combinam custo mais baixo, qualidade elevada e infraestrutura global. A tendência é uma consolidação: modelos generalistas se tornam commodities, e a diferenciação passa a vir de nichos específicos, integrações profundas, suporte e ferramentas em torno dos LLMs, não apenas do modelo em si.
Ao mesmo tempo, o volume total de uso tende a continuar crescendo, impulsionado pela democratização de acesso. A queda de preço por token abre espaço para novas aplicações em setores como finanças, saúde, educação, atendimento ao cliente e desenvolvimento de software, ampliando o impacto econômico desses sistemas e colocando mais pressão regulatória sobre um mercado em rápida expansão.