TinyFish puxa disputa por APIs de busca mais baratas para IA
Avaliações internas e benchmark independente mostram como o volume de texto retornado por APIs de busca muda o custo real de agentes de IA, e colocam a TinyFish como opção mais barata por tarefa.
Tech Desk
Análises revelam que TinyFish oferece a solução mais econômica para integração de APIs de busca em agentes de IA.
Leia também: μRepRap revoluciona impressão 3D com precisão de 1 micrômetro
Um novo comparativo de custos e desempenho em APIs de busca para agentes de IA coloca a TinyFish como a opção mais barata por tarefa hoje, mas expõe um ponto que muitas equipes ainda ignoram: mais do que o preço por requisição, é o volume de texto retornado por cada busca que infla a conta de modelos como o GPT-5.6 Luna.
Qual é o custo real para um agente de IA ler a web usando TinyFish?
Nas medições mais recentes da plataforma independente Artificial Analysis, o custo total por 1.000 tarefas com TinyFish fica em US$ 9,30, já considerando o modelo GPT-5.6 Luna médio e busca integrada. Nesse cenário, a busca em si sai a US$ 0 no benchmark, e toda a cobrança vem do processamento do modelo, que consome tokens no conteúdo de entrada, no raciocínio e na saída.
O levantamento da Artificial Analysis mostra valores entre US$ 8,04 e US$ 21,65 por 1.000 tarefas nos diferentes provedores avaliados, com TinyFish na ponta mais barata quando se soma custo de busca e de modelo. A própria plataforma resume assim a conta: “O custo do modelo cobre tokens de entrada, cache, raciocínio e saída; diferenças entre provedores refletem o volume de dados retornados e o número de buscas realizadas”, diz a Artificial Analysis em sua metodologia.
Isso significa que, na prática, cada página que o agente de IA lê pesa duas vezes no bolso: primeiro no eventual valor cobrado pela API de busca ou de fetch; depois, e quase sempre de forma mais relevante, na quantidade de tokens que aquele texto ocupa na janela de contexto do modelo. Provedores que devolvem páginas muito extensas acabam empurrando esse custo para a parte de IA, mesmo que a linha de busca pareça barata ou gratuita.
Entenda o contexto
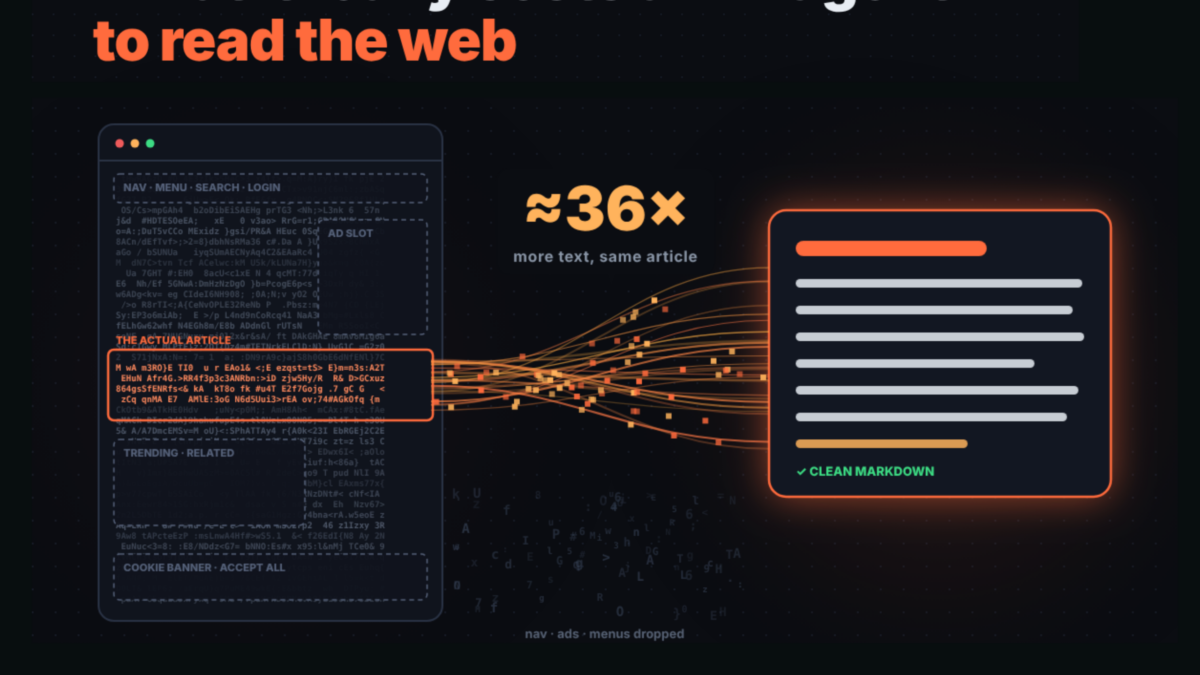
Em uma avaliação interna concluída em junho, a TinyFish testou 45 URLs em cinco provedores — TinyFish, Tavily, Exa, Firecrawl e Parallel — para medir não só se o conteúdo chegava, mas quanto texto vinha em cada resposta e com que qualidade. Em um artigo do Daily Mail com cerca de 4.300 caracteres, por exemplo, a Firecrawl entregou aproximadamente 36 vezes mais caracteres do que a TinyFish, enquanto a Parallel retornou apenas um trecho, sem a página completa.
Na metodologia da TinyFish, uma página é considerada “coberta” quando há pelo menos 1.000 caracteres úteis e uma proporção de “sinal” (conteúdo relevante, sem lixo ou elementos repetitivos) acima de 30%. Nesse recorte, a cobertura ficou em 93% para TinyFish, 80% para Tavily, 73% para Exa, 62% para Firecrawl e 58% para Parallel. Entre os resultados aproveitáveis, o sinal mediano foi semelhante entre TinyFish (90,5%) e Exa (89,7%).
A avaliação reforça a tese da empresa de que olhar apenas para o preço por requisição esconde a principal fonte de gasto: o tamanho dos textos que acabam entrando na conta do modelo de linguagem. Quando uma página vem com dezenas de milhares de caracteres, o custo de inferência dispara, mesmo que a linha de busca esteja classificada como “barata”.
Busca como infraestrutura, não como produto
Ao se posicionar nessa disputa, a TinyFish tenta empurrar a busca para um lugar mais invisível na arquitetura dos agentes de IA — algo entre DNS e armazenamento, que funciona em segundo plano e não vira centro de custo separado. “Um agente que reserva, compara ou preenche um formulário deve se importar se o trabalho foi feito, não qual sistema de busca encontrou a página”, diz a empresa, defendendo que o foco do desenvolvedor fique no fluxo da tarefa.
Esse discurso ganha peso em um momento em que times de IA já fazem roteamento dinâmico de tarefas para o modelo mais barato capaz de cumprir o objetivo. A própria TinyFish argumenta que, com a guerra de preços por token em curso, o gargalo passa a ser o volume de contexto que cada busca despeja no modelo — algo que APIs de extração e fetch podem controlar melhor ou pior.
Do outro lado, a Artificial Analysis ajuda a organizar o debate ao fixar o modelo de resposta (no caso, o GPT-5.6 Luna médio) e variar apenas o provedor de busca. Assim, o que muda de um concorrente para outro é justamente o tanto de páginas e o volume de texto que o agente traz antes de raciocinar, além do número de buscas disparadas por tarefa.
Trade-offs entre custo, qualidade e velocidade
Os números, porém, mostram que baratear não é de graça em termos de qualidade e velocidade. No ranking de busca da Artificial Analysis, a TinyFish registra um índice de Search Index de 71 e um DeepSearchQA F1 de 67, as menores notas entre as configurações exibidas no recorte em que ela aparece. O tempo médio por tarefa fica em 59 segundos, somando o processamento do modelo com o tempo de busca, e não apenas a latência bruta da API.
Na prática, isso indica um equilíbrio deliberado: cortar excesso de texto e focar em resultados com bom “sinal” ajuda a reduzir conta de tokens, mas pode limitar a profundidade da busca em cenários mais complexos e alongar um pouco o tempo por tarefa. Para equipes que operam grandes volumes de tarefas simples ou moderadas, a conta tende a fechar; para usos que exigem pesquisa muito profunda e rápida, outros provedores podem entregar mais, a um custo maior.
Outro ponto de atenção é metodológico: o benchmark da Artificial Analysis usa uma camada própria de extração, o que significa que os números de qualidade de conteúdo não medem diretamente o Fetch da TinyFish, e sim o conjunto busca + extração desse ambiente de testes. Já a avaliação interna de 45 URLs é um teste de um único fornecedor sobre si mesmo, ainda que com métricas explícitas.
Qual é a estrutura de preços do TinyFish?
A TinyFish mantém a busca (Search) e a extração de páginas (Fetch) gratuitas dentro de limites diários e por minuto, e cobra à parte pelo uso do agente e do navegador automatizado. Na prática, desenvolvedores pagam pelo “cérebro” e pela navegação, enquanto a linha de busca fica isenta até certo patamar.
No Search, o limite gratuito hoje é de 30 requisições por minuto e 500 por hora. No Fetch, que traz o HTML e o texto das páginas, a franquia diária chega a 150 URLs por minuto e 1.000 por dia. Mesmo com saldo de carteira em US$ 0, esses serviços continuam funcionando dentro dessas margens.
O componente Agent, que controla a orquestração das tarefas de IA, custa US$ 0,016 por passo, com direito a duas execuções concorrentes. Já o Browser, usado para automação de navegação em páginas mais complexas, sai por US$ 0,002 por minuto, com cinco sessões simultâneas. Novas contas recebem US$ 8 em créditos na carteira para iniciar os testes.
Essa arquitetura de preços tenta alinhar cobrança com valor percebido: times que fazem muitas buscas e leituras de páginas, mas poucas sequências longas de raciocínio ou automação intensiva, conseguem rodar grande parte do trabalho pagando só o custo de modelo embutido na camada de agente, sem ver a fatura estourar na linha de retrieval.
Como o TinyFish torna a busca na web gratuita?
A TinyFish consegue eliminar a cobrança direta por busca dentro dos limites publicados ao tratar Search e Fetch como infraestrutura compartilhada, amortizada em cima do que realmente escala com uso: passos de agente e minutos de navegador. Em outras palavras, a empresa concentra sua receita no que varia com a complexidade da tarefa, não com o número bruto de requisições de busca.
Com isso, a estratégia passa a ser otimizar agressivamente o tamanho e a qualidade do texto retornado, reduzindo o desperdício de tokens no modelo e mantendo os custos totais em níveis competitivos mesmo quando a linha de retrieval não entra na conta. Para desenvolvedores, o efeito prático é uma previsibilidade maior de custos por tarefa e menos necessidade de ficar calculando o peso de cada chamada de busca isolada.
Do ponto de vista de mercado, esse desenho de preços pressiona concorrentes que cobram por página ou por requisição de forma direta. Se a competição se deslocar para custo total por 1.000 tarefas — métrica usada pela Artificial Analysis —, a tendência é que outros provedores também tenham de rever políticas de limite, payload retornado e granularidade de cobrança para não perder volume para modelos mais “enxutos” de busca.
Fonte: matéria original