Mistral lança Voxtral 3 com voz em tempo real e resposta em 1s
Mistral AI lança Voxtral 3, família de modelos de fala com transcrição em 50 idiomas, TTS emocional e SDK para agentes de voz com resposta em menos de 1 segundo.
Tecnologia
Nova geração de modelos de fala oferece transcrição multilíngue e respostas rápidas para agentes de voz.
Leia também: Mercury 3 gera texto 8x mais rápido e supera GPT-6 em testes
A Mistral AI lançou o Voxtral 3, uma família de modelos de fala com transcrição em 50 idiomas, síntese de voz com controle emocional e um SDK para agentes de voz em tempo real, capaz de responder em menos de um segundo em chamadas telefônicas e sessões pela web ou apps.
O que é o Voxtral 3
O pacote reúne 3 modelos de transcrição, 1 modelo de texto para fala (TTS) e um SDK de agente de voz construído sobre a plataforma LiveKit. Todos estão em prévia pública na API da empresa, com endpoints na Europa, nos Estados Unidos e globais, voltados a aplicações como call centers, plataformas de comunicação, assistentes virtuais e ferramentas corporativas.
Os modelos de transcrição suportam diarização, que identifica quem está falando em conversas com múltiplos interlocutores, e context biasing, técnica que usa termos-chave ou trechos de texto para aumentar a recuperação de informações relevantes. A transcrição em lote cobre 50 idiomas, incluindo as 24 línguas oficiais da União Europeia, mirando empresas que lidam com grandes volumes de áudio multilíngue.
Na outra ponta, o Voxtral Speech 3 é o modelo de TTS que dá voz aos agentes, com foco em naturalidade e expressividade. Ele oferece controles explícitos de emoção, ritmo e ênfase, além de cerca de 90 milissegundos para o primeiro áudio e 34 etiquetas emocionais para ajustar o tom da fala ao contexto da conversa.
Como funcionam os agentes de voz
O SDK de agente de voz foi construído sobre o LiveKit e integra três estágios em um único pipeline de streaming. Primeiro, o modelo Realtime Transcribe 3 escuta o usuário e detecta automaticamente quando ele faz pausas ou conclui uma frase. Em seguida, um modelo de linguagem de uso geral, como o Mistral Small 4, faz o raciocínio, decide a resposta e aciona ferramentas externas, se necessário. Por fim, o Voxtral Speech 3 sintetiza a resposta em áudio.
Segundo a Mistral AI, “cada turno completa em menos de 1 segundo. O agente para de falar quando o interlocutor interrompe”. Essa capacidade de interromper a fala ao ser cortado é crítica para que a experiência pareça mais próxima de uma conversa humana, sobretudo em atendimento telefônico.
O sistema aceita chamadas via SIP, protocolo comum em centrais telefônicas, e sessões via WebRTC para navegadores e aplicativos móveis. Como cada etapa usa um modelo separado, equipes técnicas podem trocar o modelo de linguagem, o tipo de voz ou o idioma conforme a necessidade do projeto, sem reescrever toda a solução.
Entenda o contexto
A chegada do Voxtral 3 acontece em um momento em que empresas de diversos setores buscam automatizar interações por voz sem perder qualidade na experiência do usuário. Em ambientes regulados, como o mercado europeu, a combinação de endpoints locais, política de retenção zero de dados e suporte amplo a idiomas é um diferencial competitivo para adoção em escala.
O lançamento também reforça a estratégia da Mistral AI de disputar espaço com grandes players globais em tecnologias de fala e linguagem. À frente da Marktechpost AI Media Inc., o CEO Asif Razzaq é uma das vozes que defendem o uso da inteligência artificial para impacto social positivo e popularização do conhecimento técnico, em uma plataforma que soma mais de 2 milhões de visualizações mensais.
Desempenho e comparação com rivais
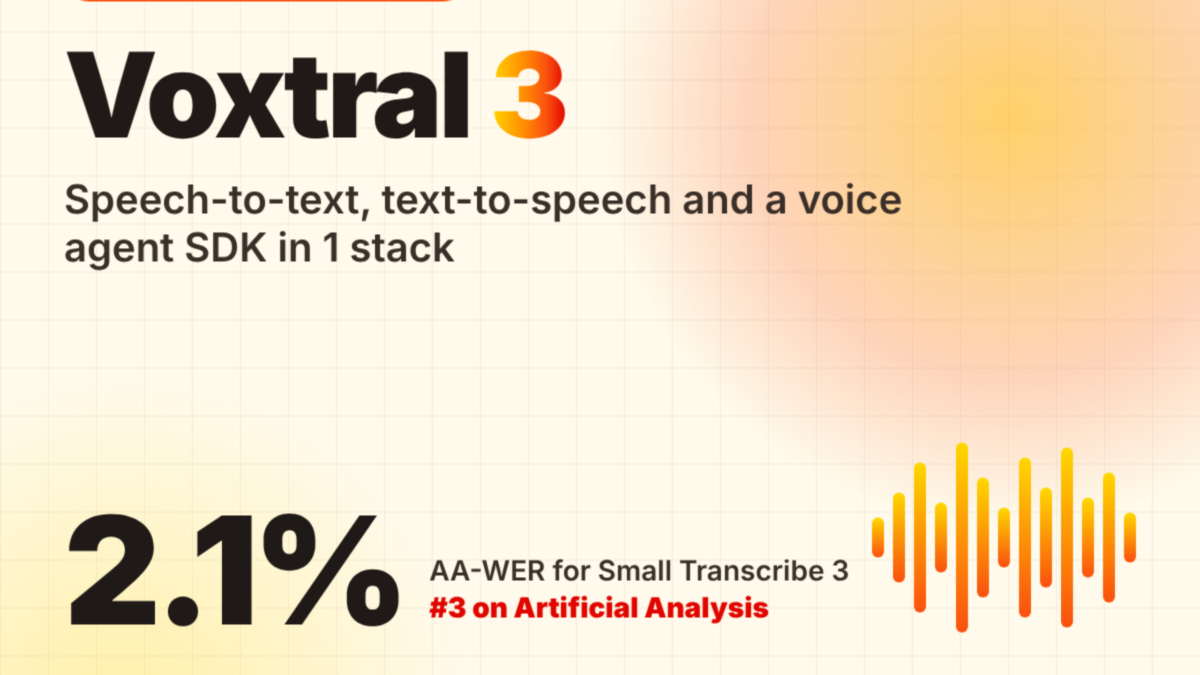
Nos números divulgados pela própria Mistral, o modelo de transcrição Small atinge 2,1% de erro de palavra na métrica Artificial Analysis (AA-WER), resultado próximo ao topo das avaliações de mercado. Há concorrentes ligeiramente mais precisos, mas com vantagem expressiva em velocidade; o foco do Voxtral 3 é equilibrar precisão e uso em tempo real.
Em outro conjunto de testes, o FLEURS 35, o modelo em tempo real mostra um trade-off claro entre latência e acurácia, com taxas de erro que variam de 5,7% a 7,4% conforme o tempo de resposta permitido. Nessa faixa, supera sistemas como alguns modelos Gemini 3.5 e GPT Live Transcribe em diferentes configurações, o que ajuda a sustentar a narrativa de desempenho competitivo.
Na síntese de voz, a Mistral destaca custo e flexibilidade. “O modelo Voxtral Speech 3 custa 13 dólares por 1 milhão de caracteres, preço que subcorta concorrentes como OpenAI TTS-1, Deepgram, ElevenLabs Flash e Gemini Flash”, afirma a empresa. O recurso Pro Voice é outro argumento: “O recurso Pro Voice adapta o estilo de um locutor a partir de 30 minutos de áudio”, o que permite aproximar a voz sintética de uma identidade vocal específica, respeitando políticas de uso definidas pelos clientes.
Quem ganha com o Voxtral 3
A combinação de transcrição precisa, TTS expressivo e pipeline de streaming em um só pacote interessa diretamente a setores como atendimento ao cliente, tecnologia, comunicação, saúde, educação e serviços financeiros. Call centers podem automatizar partes significativas das conversas sem abrir mão de contexto e emoção na voz do agente virtual; plataformas de telemedicina conseguem registrar e transcrever consultas em múltiplos idiomas; fintechs e bancos ganham opções de atendimento 24 horas com maior controle sobre segurança e privacidade.
Ao oferecer uma solução integrada e modular, a Mistral AI pressiona concorrentes que trabalham com blocos separados de transcrição, TTS e orquestração de agentes, muitas vezes a preços mais altos. A expectativa no mercado é de que o Voxtral 3 acelere a adoção de agentes de voz inteligentes em ambientes multilíngues e regulados, ao mesmo tempo em que puxa a concorrência por mais qualidade, menor latência e custos mais baixos.
Para desenvolvedores e integradores, os próximos passos passam por testar os modelos em cenários reais, ajustar o balanceamento entre latência e precisão e explorar os controles finos de emoção e ritmo no TTS. A Mistral indica que a documentação e as páginas individuais dos modelos trazem os detalhes técnicos necessários para essa etapa de experimentação e implementação comercial.
Fonte: matéria original