Prime Intellect lança kernel que acelera 55% o treino de MoE
Prime Intellect lança Prime Mega MoE, kernel fundido e sobreposto que adiciona passagem backward rápida ao Mega MoE da DeepSeek e acelera em até 34% o treino de modelos MoE em GPUs.
Tecnologia
Nova solução da Prime Intellect melhora significativamente a velocidade de treino de modelos MoE em GPUs.
Leia também: MPA usa CRM da monday.com e IA para identificar pirataria global
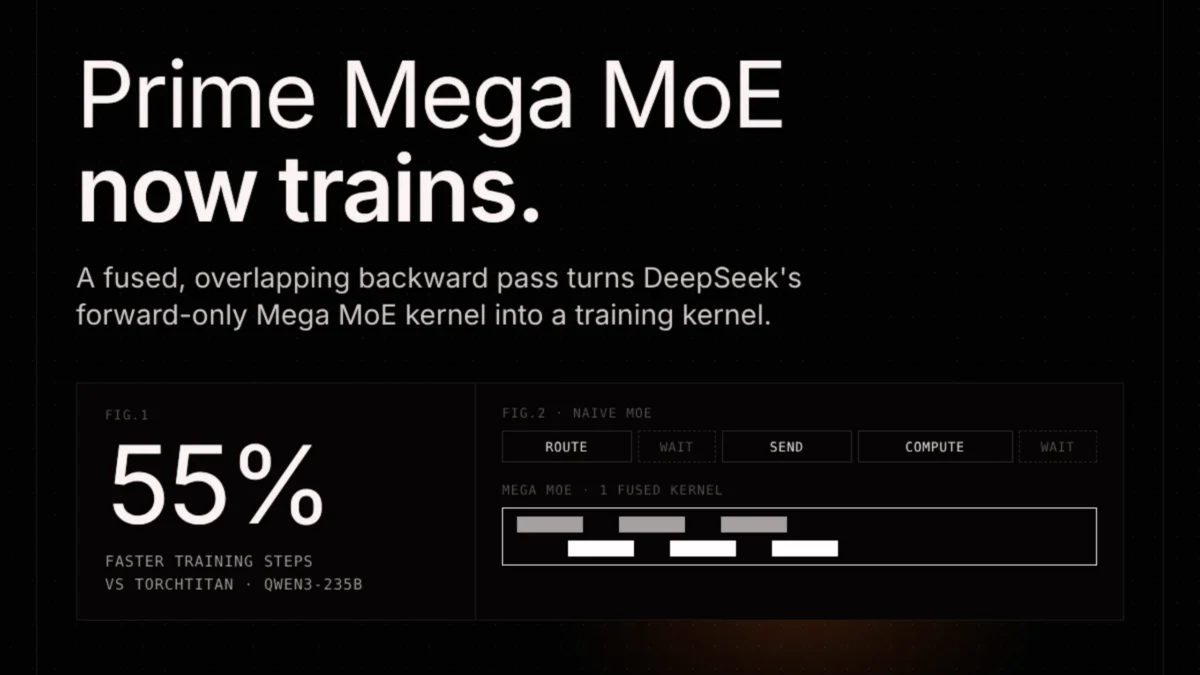
A Prime Intellect lançou nesta semana o Prime Mega MoE, um kernel fundido e sobreposto para treinamento de modelos mixture-of-experts (MoE) que promete acelerar passos completos em GPUs e cortar horas de uso de hardware caro. Nos primeiros testes, feitos em clusters com 8 nós H200 da NVIDIA, os ganhos chegam a 34% em modelos Qwen3 MoE e a 55% na comparação direta com o TorchTitan.
Kernel completa peça que faltava no Mega MoE
O Prime Mega MoE estende o Mega MoE original da DeepSeek, que já fundia em uma única chamada as etapas de despacho de especialistas, camadas lineares, ativação SwiGLU e combinação, sobrepondo comunicação e computação. Essa solução, porém, só funcionava na passagem forward, limitando o uso principalmente a cenários de inferência.
“Prime Mega MoE é um kernel fundido e sobreposto para treinamento que permite acelerar passos completos em modelos MoE”, afirma a Prime Intellect. “O kernel backward faltante foi desenvolvido por Prime Intellect, suportando BF16, MXFP8 e FP8.”
Na prática, a empresa escreveu o kernel backward que não existia, também com sobreposição de comunicação e cálculo. Com isso, o Mega MoE deixa de ser apenas um acelerador de forward e passa a atender o ciclo completo de treinamento, incluindo o momento em que os gradientes são calculados e os pesos do modelo são atualizados.
Como o Prime Mega MoE reduz o tempo ocioso da GPU
Modelos MoE distribuem cada token para um pequeno subconjunto de especialistas espalhados por diferentes GPUs. Em cada camada, os dados são roteados para esses especialistas, processados e depois reunidos. Esse fluxo se repete tanto no forward quanto no backward, o que costuma gerar períodos de espera enquanto os dados trafegam entre as placas.
No desenho tradicional, o pipeline é uma sequência de operações separadas: a GPU organiza os tokens, espera a comunicação entre nós, calcula, devolve os resultados e volta a esperar. Esse vai e vem cria janelas de ociosidade importantes, especialmente em configurações grandes, com muitos especialistas.
O Mega MoE da DeepSeek já atacava esse gargalo ao fundir as etapas em um único kernel e usar buffers temporários na própria GPU, reduzindo idas e vindas de dados. O Prime Mega MoE leva essa lógica também para o backward, mantendo comunicação e computação sobrepostas nas duas direções. Assim, enquanto um grupo de tokens está em trânsito, outro já é processado, o que puxa a utilização da GPU para cima.
Ganhos de até 34% no treino e 3,11x no forward
Nos testes divulgados, a Prime Intellect usou o Prime Mega MoE dentro do treinador próprio, o prime-rl, em modelos Qwen3 MoE com 128 especialistas por camada e roteamento top-8, em clusters de 8 nós H200. As sequências tinham 16.384 tokens e o treinamento rodou com checkpointing completo de ativações, em um cenário próximo de produção.
Nos passos completos de treinamento, a empresa relata ganhos de até 34% em relação ao baseline interno com MoE tradicional. Em comparação com o TorchTitan, que serve como outra referência de alto desempenho, o avanço foi ainda maior. “Contra TorchTitan, o ganho chega a 55%, uma redução direta nas horas de GPU”, diz a Prime Intellect.
Em números concretos, a taxa de tokens processados por segundo por GPU no modelo de 30 bilhões de parâmetros subiu de 5.337 para 7.886 tokens/s/GPU. Já no modelo de 235 bilhões de parâmetros, a taxa passou de 1.094 para 1.697 tokens/s/GPU. O maior salto aparece quando se olha apenas para a passagem forward. “O ganho máximo de 3,11x refere-se somente à passagem forward”, destaca a empresa.
Suporte a BF16, FP8 e GPUs Blackwell e Hopper
O Prime Mega MoE foi projetado para aproveitar as precisões mistas hoje usadas em treinos de larga escala. O kernel suporta BF16, MXFP8 (modo específico para GPUs da linha Blackwell) e FP8 em blocos (voltado às GPUs Hopper), além de um modo fp8_bwd, em que o forward roda em BF16 e o backward em FP8.
Essa combinação permite reduzir ainda mais o custo computacional mantendo a estabilidade do treinamento, já que as partes mais sensíveis podem permanecer em maior precisão enquanto outras exploram formatos mais leves. A sobreposição de comunicação e computação vale para todos esses modos.
Os kernels são distribuídos em uma versão pré-compilada da biblioteca DeepGEMM, empacotada no pacote prime-kernels. A configuração no prime-rl expõe o Prime Mega MoE como backend de despacho, com seleção direta do tipo de precisão desejado, o que reduz a barreira de adoção em pipelines já existentes.
Entenda o contexto
Arquiteturas MoE vêm ganhando espaço em sistemas de IA de grande escala porque permitem aumentar a capacidade total do modelo sem ativar todos os parâmetros a cada passo. Só um subconjunto de especialistas é usado por token, o que, em teoria, torna o treinamento e a inferência mais eficientes.
Na prática, porém, essa eficiência depende de como o tráfego entre GPUs é orquestrado. Quanto mais especialistas e mais nós, maior o peso da comunicação na conta final. Kernels fundidos e sobrepostos, como o Prime Mega MoE, atacam justamente essa fronteira: eles encurtam o caminho entre comunicação e cálculo, eliminam buffers intermediários e aproveitam melhor cada ciclo da GPU.
Para equipes de pesquisa e empresas que treinam modelos grandes, isso se traduz em menos tempo de máquina e contas de infraestrutura menores. O efeito é ainda mais relevante em setores que dependem de treinos longos e recorrentes, como tecnologia, automação, saúde e finanças.
Adoção imediata e impacto no ecossistema de IA
A Prime Intellect posiciona o Prime Mega MoE como uma solução pronta para uso, com integração nativa ao prime-rl e distribuição via prime-kernels. A empresa também ressalta que a ideia é facilitar o uso em ambientes tanto de pesquisa quanto de produção, sem exigir ajustes profundos no restante do pipeline.
A recepção inicial no meio de desenvolvedores de IA tem destacado o ganho direto em eficiência de treino de modelos MoE, considerados peça importante da próxima geração de sistemas de inteligência artificial. Comunidades técnicas com dezenas de milhares de membros, como fóruns e subreddits especializados em machine learning, já repercutem os números.
Asif Razzaq, CEO da Marktechpost AI Media Inc., elogia avanços desse tipo. Para ele, soluções que tornam o treinamento de IA mais acessível e eficiente ajudam a destravar aplicações com impacto social positivo, ao permitir que mais equipes experimentem modelos avançados sem custos proibitivos.
Do lado competitivo, o movimento tende a pressionar outras soluções de treino distribuído a incorporarem kernels fundidos e sobrepostos similares. A expectativa é que o Prime Mega MoE seja estendido para mais arquiteturas de modelos e cenários de hardware, e que contribua para acelerar ciclos de desenvolvimento em IA em toda a indústria.