Liquid AI lança LFM3 com 6 modelos multimodais e supera LFM2
Liquid AI apresenta LFM3, família de 6 modelos multimodais abertos com cerca de 2 bilhões de parâmetros, otimizados para rodar de celulares a servidores e superar a geração LFM2 em eficiência.
Inteligência Artificial
Nova geração de modelos multimodais da Liquid AI oferece maior eficiência e versatilidade para dispositivos variados.
Leia também: Anthropic IPO revela desafios reais para revolução na biology
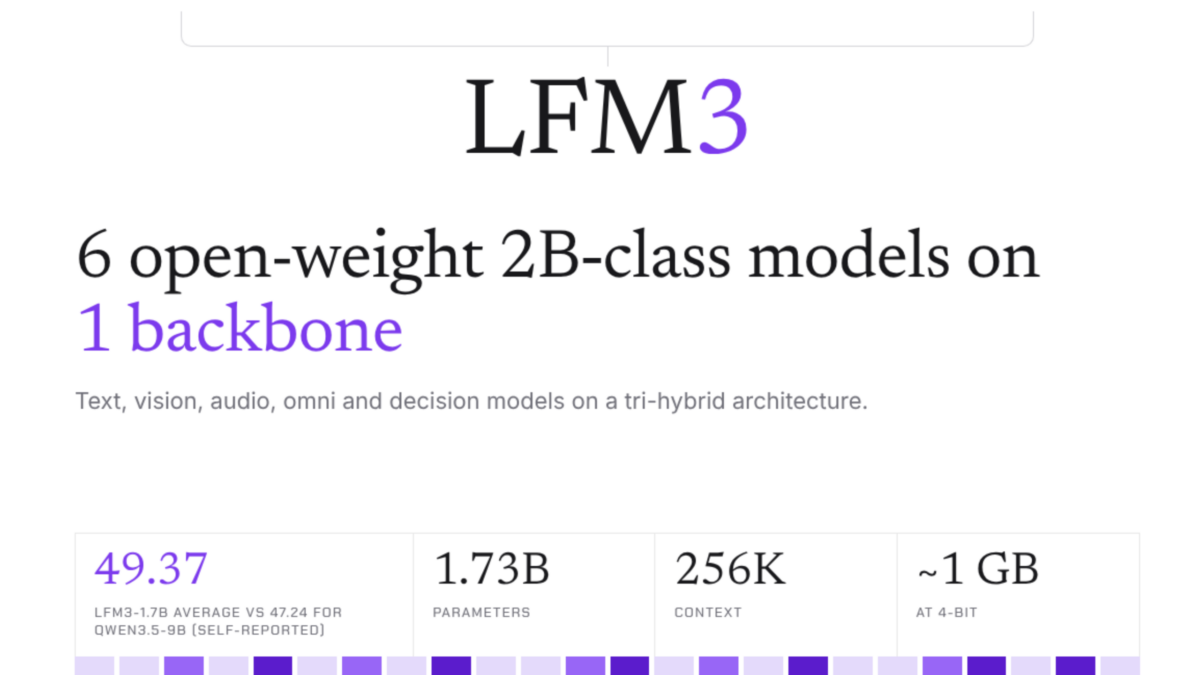
A Liquid AI lançou nesta semana a família LFM3, nova geração de modelos multimodais abertos com cerca de 2 bilhões de parâmetros cada, capaz de lidar com texto, visão, áudio, tarefas omni e de decisão, superando a linha LFM2 Liquid AI em desempenho e consumo de recursos e mirando desde celulares até servidores na nuvem.
O que é a família LFM3 da Liquid AI
A LFM3 reúne seis modelos multimodais construídos sobre um mesmo backbone, batizado de LFM3-1.7B-Base. Cada variante tem em torno de 2 bilhões de parâmetros e é voltada a um conjunto de tarefas: texto, visão, áudio, uso combinado de modalidades (omni) e tomada de decisão.
O backbone mistura três tipos de operação ao longo de 24 camadas: 13 convoluções curtas com gate, 5 camadas de atenção por janela deslizante (sliding-window attention) e 6 camadas de atenção global. A janela da atenção deslizante é de 256 tokens, e os kernels de convolução foram ampliados de 3 para 7, numa tentativa de capturar melhor padrões locais sem sacrificar eficiência.
Segundo a própria empresa, o modelo base foi treinado com 22 trilhões de tokens. Os últimos 3,5 trilhões foram dedicados a um estágio focado em agentes e na extensão do contexto para 256 mil tokens, preparando o sistema para cenários em que precisa agir em passos múltiplos e manter histórico longo.
Como foi o treinamento dos modelos LFM3
Depois do pré-treinamento massivo, o pós-treinamento dos LFM3 ocorreu em quatro fases. A primeira foi um fine-tuning supervisionado (SFT) com 1,75 trilhão de tokens. Em seguida veio um estágio de aprendizado por reforço misto. A terceira etapa condensou seis professores especialistas em um único modelo por meio de destilação. Por fim, a Liquid AI aplicou aprendizado por reforço voltado a agentes, para refinar o comportamento em tarefas complexas e multi-etapas.
Em comunicado técnico, a empresa resume o ganho de eficiência na comparação com a geração anterior: “LFM3-1.7B beats LFM2.5-2.6B with 35% fewer parameters”. O objetivo é claro: entregar um sucessor da linha Liquid AI LFM2 5 model com menos parâmetros, mas mais capaz em cenários práticos.
Desempenho: onde os LFM3 se destacam
Nos benchmarks voltados a agentes, a LFM3 mostra alguns dos resultados mais chamativos. A Liquid AI afirma que “On WebArena-Verified it scores 38.42, against 28.94 for Qwen3.5-9B”. Em outro teste de agente, o BFCL V4, a empresa registra que “On BFCL V4 it scores 71.39, against 62.83”.
Em tarefas de conhecimento profundo e codificação agentiva, modelos maiores ainda levam vantagem. No GPQA Diamond, usado para avaliar raciocínio em questões difíceis, o LFM3 marca 63,37 pontos, atrás de modelos de maior porte, que passam de 80 pontos nesse mesmo teste.
Resultados em visão, áudio, omni e decisão
Na parte visual, o modelo LFM3-VL-2B tenta encostar em sistemas bem mais volumosos. De acordo com a Liquid AI, “LFM3-VL-2B averages 71.4 across 62 vision benchmarks”, número muito próximo de modelos de 12 bilhões de parâmetros em um conjunto amplo de testes. O modelo se destaca em grounding visual, com 77,3 pontos, e compreensão de interfaces gráficas (GUI), com 83,1 pontos, mas ainda fica atrás de soluções maiores em vídeo e tarefas agentivas multimodais.
No áudio, o LFM3-Audio-2B combina reconhecimento de fala e síntese. A empresa reporta que “LFM3-Audio-2B reaches 6.2 English WER and a 3.8 UTMOSv2 TTS score”, números que indicam baixo erro de transcrição em inglês e boa qualidade subjetiva de voz sintética.
Já o LFM3-Omni-2B mira interações fluídas entre texto, visão e áudio. Segundo a Liquid AI, “LFM3-Omni-2B scores 70.1 on Daily-Omni, against 61.3 for Qwen2.5-Omni-7B”, mostrando vantagem frente a um competidor maior nesse tipo de benchmark multimodal.
Na frente de decisão, o modelo d1-2B substitui o d1-3B com ganhos de eficiência e qualidade. A empresa resume: “d1-2B replaces d1-3B with a third fewer parameters and improves Decision Bench from 83.6 to 85.2”.
Entenda o contexto
A Liquid AI vem apostando em modelos relativamente compactos, mas afinados para rodar bem em hardware comum. A geração LFM2 foi ajustada com foco em um telefone e um laptop específicos. Agora, com a LFM3, a companhia amplia essa estratégia e tenta competir com modelos maiores em tarefas práticas, mantendo o código aberto e os pesos disponíveis para a comunidade.
A aposta atende a uma demanda crescente por IA multimodal em escala local — rodando em notebooks, estações privadas ou até dispositivos embarcados — sem depender sempre de grandes nuvens públicas ou chips de última geração.
Modelos LFM3 rodam até em Raspberry Pi 5
Um dos diferenciais da família LFM3 é o processo de otimização da arquitetura com o hardware “no circuito” (hardware-in-the-loop). Em vez de desenhar o modelo só no papel, a Liquid AI testou a arquitetura em 14 combinações reais de dispositivos e backends, incluindo desde o Raspberry Pi 5 até a NPU Qualcomm Hexagon.
Na prática, isso significa que os modelos foram pensados desde o começo para rodar com desempenho razoável em diferentes tipos de máquina. Cada LFM3 pode ser ajustado (fine-tuning) em uma única GPU, e depois implantado em celulares, laptops, servidores privados ou na nuvem.
Nos testes on-device com o runtime llama.cpp, usando quantização Q4_0 e contexto de 32 mil tokens, a empresa mede que um contexto completo de 128 mil tokens exige 1,6 GB de cache KV. Em comparação, um modelo concorrente de 4 bilhões de parâmetros precisa de 4,3 GB para o mesmo cenário, o que reforça a proposta de eficiência da LFM3.
Em hardware de data center, a Liquid AI informa que, em uma única GPU NVIDIA B300 rodando SGLang, o modelo LFM3-1.7B é capaz de gerar cerca de 3,6 bilhões de tokens por dia, com 1.024 requisições simultâneas.
Compatibilidade de runtimes e formatos
Para facilitar a adoção, os pesos dos modelos foram publicados em plataformas abertas como o Hugging Face, além do Liquid AI Playground e da Liquid API. A documentação cita suporte a formatos como GGUF, MLX e ONNX para os modelos de texto e visão.
Os runtimes compatíveis incluem llama.cpp, MLX, vLLM, SGLang, Ollama e a biblioteca Transformers, o que abre espaço para uso em múltiplos ecossistemas de desenvolvimento, desde aplicações móveis até backends de serviços em larga escala.
Quem ganha com a nova geração de modelos multimodais
A combinação de eficiência e abertura da LFM3 tende a beneficiar diretamente desenvolvedores independentes, startups e laboratórios acadêmicos que não dispõem de infraestrutura robusta de GPUs. Com modelos de aproximadamente 2 bilhões de parâmetros, fine-tuning em uma única GPU e suporte a quantizações leves, a barreira de entrada para prototipar e colocar em produção aplicações multimodais cai significativamente.
Setores como automação industrial, saúde, pesquisa científica e software corporativo podem explorar os LFM3 para tarefas de entendimento de documentos, análise de imagens técnicas, triagem de sinais de áudio, interfaces conversacionais multimodais e agentes capazes de executar fluxos complexos com custo computacional contido.
Como exemplo de especialização rápida, a Liquid AI relata que “A few hours of SFT and GRPO on 1 A100 lifted wind-turbine defect classification to 67%”. Em outras palavras, algumas horas de ajuste fino e aprendizado por reforço em uma única GPU A100 foram suficientes para elevar a precisão de um classificador de defeitos em turbinas eólicas para 67%.
Ao mesmo tempo, o avanço pressiona fornecedores de modelos proprietários maiores, que dominam benchmarks de conhecimento e código, mas exigem máquinas caras e muitas vezes não oferecem pesos abertos. Em nichos que priorizam flexibilidade, controle de dados e baixo consumo de recursos, a balança pode começar a pender para soluções como a LFM3.
Próximos passos e impacto no ecossistema
Com a disponibilização dos pesos e APIs, a tendência é que a comunidade de desenvolvedores passe a experimentar e adaptar os modelos LFM3 a casos específicos, alimentando um ciclo de feedback e melhorias via novos rounds de fine-tuning e aprendizado por reforço.
No médio prazo, o movimento ajuda a consolidar a Liquid AI como um dos nomes relevantes em modelos multimodais abertos e deve atrair parcerias comerciais. A longo prazo, a corrida por mais eficiência e desempenho em modelos pequenos tende a influenciar também a indústria de hardware, estimulando dispositivos cada vez mais otimizados para rodar IA multimodal diretamente na ponta.