NVIDIA lança Nemotron 3.5 Bolt para IA local com 4 GB VRAM
NVIDIA apresenta o Nemotron 3.5 Bolt E4B 4GB, modelo de linguagem pequeno e aberto, otimizado para rodar localmente em GPUs RTX e Jetson, com foco em voz, jogos e robótica.
Tecnologia
NVIDIA revela modelo de linguagem compacto para IA local, ideal para aplicações em voz, jogos e robótica.
Leia também: Washable rugs Revival Rugs: 20% OFF até domingo em todo site
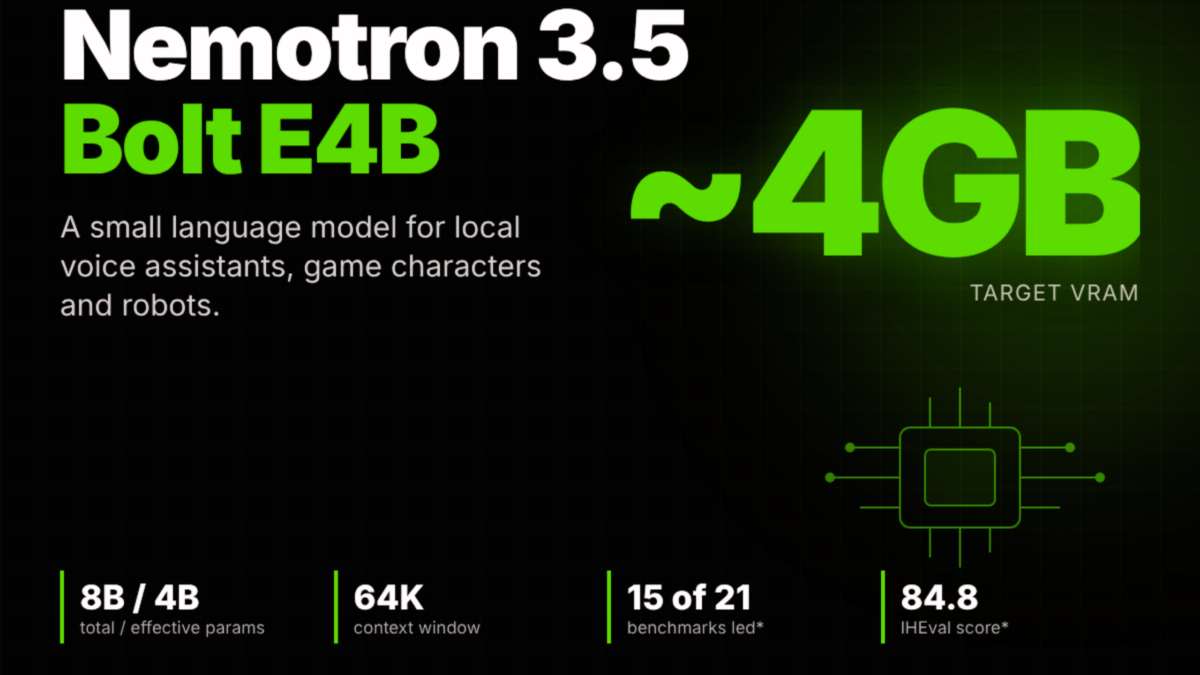
A NVIDIA lançou o Nemotron 3.5 Bolt E4B 4GB, um modelo de linguagem pequeno e aberto voltado para rodar inteiramente em hardware local, como GPUs RTX, placas Jetson e plataformas Spark, com foco em assistentes de voz, personagens de jogos e robôs que precisam responder em tempo real.
O Bolt combina conversa natural com chamadas de ferramentas em vários turnos, ocupando cerca de 4 GB de VRAM para execução. Na prática, isso deixa espaço na mesma GPU para outros modelos de fala e visão, algo crucial em dispositivos embarcados e aplicações industriais que não podem depender da nuvem.
O que é o Nemotron 3.5 Bolt E4B lançado pela NVIDIA?
O Nemotron 3.5 Bolt E4B é um modelo de linguagem de porte pequeno, otimizado para agentes conversacionais locais e liberado em formato aberto para desenvolvedores. Ele nasce a partir do Gemma 4 E4B do Google, mas passa por um pós-treinamento próprio da NVIDIA baseado apenas em aprendizado por reforço.
Segundo o relatório técnico da empresa, não houve etapa de fine-tuning supervisionado. A equipe explica que “o fine-tuning supervisionado melhorava chamadas de ferramentas, mas prejudicava a qualidade e verbosidade da conversação”. Em vez disso, o time usou técnicas de RLVR e RLHF por meio das plataformas NeMo-RL e NeMo-Gym.
Cada amostra de treinamento roda em dois modos — com e sem raciocínio explícito — mantendo uma proporção de 2:1 para dados sem raciocínio, com penalidades de comprimento para evitar respostas excessivamente longas. O objetivo é manter o modelo direto, mas ainda capaz de raciocinar quando necessário.
Como o Nemotron 3.5 Bolt E4B pode ser usado em agentes de voz locais, personagens de jogos e robôs?
O Bolt foi desenhado justamente para esses três cenários: assistentes de dispositivos e voz, personagens interativos e agentes embarcados ou industriais. Em todos os casos, ele roda localmente, o que reduz latência, aumenta privacidade e permite funcionamento mesmo sem conexão constante à internet.
Na demonstração apresentada pela NVIDIA, um robô Reachy Mini equipado com um Jetson Orin Nano 8 GB usa o Bolt para gerar respostas de fala e gerenciar chamadas de ferramentas, enquanto o modelo Cosmos 3 Edge cuida da visão. O conjunto permite que o robô observe o ambiente, entenda comandos falados e responda de forma mais natural, tudo em tempo real.
Para jogos, a empresa posiciona o modelo no ecossistema NVIDIA ACE, destinado a NPCs mais inteligentes e expressivos. A própria equipe de pesquisa descreve que “Bolt é o terceiro modelo pequeno de terceira geração para personagens de jogos NVIDIA ACE”, indicando continuidade em uma linha específica para esse tipo de personagem digital.
Principais novidades técnicas e de desempenho
Além da aposta em aprendizado por reforço, o Bolt traz uma cadeia de otimizações para caber em dispositivos limitados sem abrir mão de desempenho. O checkpoint original em precisão BF16 foi quantizado para o formato Q4_K_M, usando calibração baseada em matriz de importância construída a partir de cerca de 1 milhão de tokens gerados em rollouts de reforço.
Nessa versão, o arquivo no formato GGUF disponível em repositório público ocupa 6,18 GB, mas o alvo de execução é um envelope de aproximadamente 4 GB de VRAM. Isso permite, por exemplo, combinar o Bolt com um modelo de síntese de voz e outro de visão na mesma GPU de consumo, cenário típico em PCs gamer, workstations compactas e kits de robótica.
Para acelerar a geração de texto, a NVIDIA lançou junto o DFlash, um decodificador especulativo que antecipa tokens e reduz o tempo de resposta. Com ele, “Bolt com DFlash alcançou 272,6 tokens por segundo em RTX 5070, 1,21x mais rápido que Gemma 4 E4B”, segundo a própria empresa. No mesmo teste, o modelo original do Google, com o decodificador MTP, registra 225,9 tokens por segundo.
Nos benchmarks internos, rodando em BF16 no ambiente NeMo-Gym, o Bolt liderou 15 de 21 testes em modo de raciocínio. A NVIDIA fala em cerca de 40% de melhora média em relação ao Nemotron 3 Nano 4B e até 80% menos tokens gerados quando o raciocínio está habilitado, o que indica respostas mais enxutas e objetivas.
Em avaliações externas, o modelo também se destaca. A Scale Labs “classificou Bolt em primeiro lugar entre modelos pequenos no MultiChallenge com 56,03%”, em ranking voltado a comparar diferentes capacidades de modelos compactos. Ainda assim, a própria NVIDIA reconhece que concorrentes como Qwen3.5-4B lideram em alguns testes específicos de contexto longo e raciocínio.
Qual o tamanho e capacidade do modelo Nemotron 3.5 Bolt E4B da NVIDIA?
O Nemotron 3.5 Bolt E4B foi desenhado para rodar em cerca de 4 GB de VRAM, faixa considerada o “envelope de memória” alvo do projeto. Isso o coloca como opção viável para placas RTX de entrada, kits Jetson embarcados e outros dispositivos que não comportam modelos gigantes.
O arquivo quantizado em formato GGUF, voltado a runtimes como llama.cpp, tem 6,18 GB. A NVIDIA mediu o desempenho desse build com tamanho de lote 1, usando 3 mil tokens de entrada e 50 de saída, cenário típico de diálogo curto, o que reforça o foco em conversação rápida e contínua.
Na prática, esse perfil de consumo permite montar agentes de voz, interfaces para robôs, painéis industriais inteligentes e NPCs de jogos com todo o processamento de linguagem rodando localmente, sem a necessidade de servidores externos. Em muitos casos, desenvolvedores conseguem ainda acoplar modelos de fala e visão na mesma máquina.
Entenda o contexto
O lançamento do Nemotron 3.5 Bolt E4B acontece em um momento em que o mercado de IA começa a olhar com mais atenção para modelos menores, porém rápidos e especializados, capazes de rodar no próprio dispositivo do usuário ou em borda de rede.
Enquanto sistemas gigantes concentram os holofotes pela capacidade bruta, eles esbarram em custos altos de nuvem, latência e preocupação com dados sensíveis. Modelos como o Bolt atacam o outro lado: menos parâmetros, mais otimização, código aberto e dados públicos, voltados à criação de agentes locais sob medida.
Além do pacote técnico, o lançamento é amplamente divulgado por atores do ecossistema de IA aplicada. Asif Razzaq, CEO da Marktechpost AI Media Inc., destaca o compromisso com “o potencial da IA para o bem social e a divulgação técnica acessível”, o que ajuda a aproximar esse tipo de inovação de uma comunidade mais ampla de desenvolvedores e pesquisadores.
O Nemotron 3.5 Bolt E4B já está disponível em plataformas como Hugging Face, Ollama, LM Studio, Unsloth e Jetson AI Lab, além de integrar o NVIDIA NIM e o In-Game Inferencing SDK. Com o projeto e os dados de treinamento abertos, a expectativa é de rápida adoção em agentes de voz, personagens de jogos e soluções industriais embarcadas.