TorchNeuron ensina a acelerar modelos no AWS Trainium hoje
Série técnica mostra como usar TorchNeuron e Neuron Explorer para analisar gargalos de inferência em modelos PyTorch no AWS Trainium, com foco em operações como RMSNorm.
Tech Desk
Aprenda a otimizar a performance de modelos PyTorch usando ferramentas específicas para AWS Trainium.
Leia também: IBM lança novos modelos Granite Speech para empresas
Desenvolvedores que usam PyTorch em AWS Trainium passam a contar com um passo a passo detalhado para entender, em nível de operação, por que seus modelos de machine learning demoram a responder. Uma nova série técnica publicada nesta semana mostra como usar o backend TorchNeuron e o Neuron Explorer para fazer profiling sistemático de inferência e encontrar gargalos de performance em chips Trainium, começando por um estudo de caso da operação RMSNorm.
Como o profiling funciona no TorchNeuron
O guia parte da constatação de que, na prática, muita gente otimiza modelo “no feeling”, sem saber exatamente onde o tempo é gasto. “Many ML practitioners have some intuition about how to make models run fast, but fewer know how to analyze why a model is slow”, resume o autor do post técnico da AWS.
No Trainium, o backend Neuron se integra ao PyTorch por meio do mecanismo PrivateUse1, um ponto de extensão que permite registrar um novo dispositivo sem criar uma chave de despacho específica, como acontece com cuda. “The Neuron backend uses PyTorch’s PrivateUse1 extension point”, registra a documentação técnica do TorchNeuron, que se apresenta como backend nativo para os fluxos padrão do framework, incluindo execução eager e torch.compile, com poucas mudanças de código.
Para perfilar workloads, o desenvolvedor configura o profiler do PyTorch com parâmetros pensados para o Trainium. O campo modes escolhe quais fluxos de dados serão capturados, como instruções de dispositivo e traços de runtime. O capture_enabled_for_nc define quais NeuronCores entram na coleta. Já o correlate_device_time=True faz o tempo medido no hardware aparecer na tabela key_averages(), permitindo comparar diretamente tempo de CPU e de dispositivo.
A recomendação é usar um agendamento padrão com quatro chamadas a prof.step(), distribuídas em períodos de wait=2, warmup=1 e active=1. Essa agenda grava uma iteração de aquecimento sem incluir o custo inicial de setup. Dentro do laço do profiler, a chamada a torch.neuron.synchronize() é obrigatória para não “perder” tempo de dispositivo na coleta. “Call torch.neuron.synchronize() inside the profiler loop. Without this synchronization, the profiler can export before the device finishes and leave the Neuron time column empty”, orienta o guia de profiling do TorchNeuron.
Entenda o contexto
O Trainium é um chip dedicado a cargas de deep learning, e o TorchNeuron é o backend open source que pluga o PyTorch nesse hardware. A ideia da série técnica é transformar esse ecossistema em algo menos “caixa-preta”: em vez de apenas medir o tempo total de inferência, o desenvolvedor passa a enxergar quais operações ATen vão para o dispositivo, quanto tempo gastam na CPU, quanto tempo consomem no Neuron e como isso se traduz em instruções de hardware.
Ferramentas como o Neuron Explorer completam o quadro. O sistema roda em um navegador, acessível via túnel SSH ou pela extensão do Visual Studio Code, e exibe o traço completo: do despacho no framework à execução nas engines do chip, com visão de timeline, agrupamento por subsistema e detalhamento por motor de execução.
RMSNorm expõe onde o tempo realmente vai
Para mostrar o método, a primeira parte da série foca em uma operação relativamente simples: RMSNorm, normalização usada em diversos modelos modernos. Três implementações equivalentes são analisadas, sempre com mesmas entradas, mesma configuração de profiler e o mesmo schedule, para garantir comparabilidade.
No primeiro cenário, RMSNorm é escrito “na unha”, linha a linha em PyTorch, com operações elementares que viram chamadas ATen. Depois que o profiler termina, a análise começa pela tabela key_averages(), ordenada pela coluna de tempo total no dispositivo Neuron. A conclusão é direta: “The key averages table shows that three aten::mul calls account for the largest share of Neuron device time”, aponta a análise de profiling do TorchNeuron.
Cada uma dessas chamadas corresponde a um trecho específico da RMSNorm: a multiplicação x * x, o produto x * rms e a multiplicação final pelo weight. Outras operações aparecem bem atrás, como aten::mean (redução do último eixo), aten::add (soma do epsilon, que ainda por cima gera cópia host-to-device por começar na CPU) e aten::rsqrt (inverso da raiz quadrada).
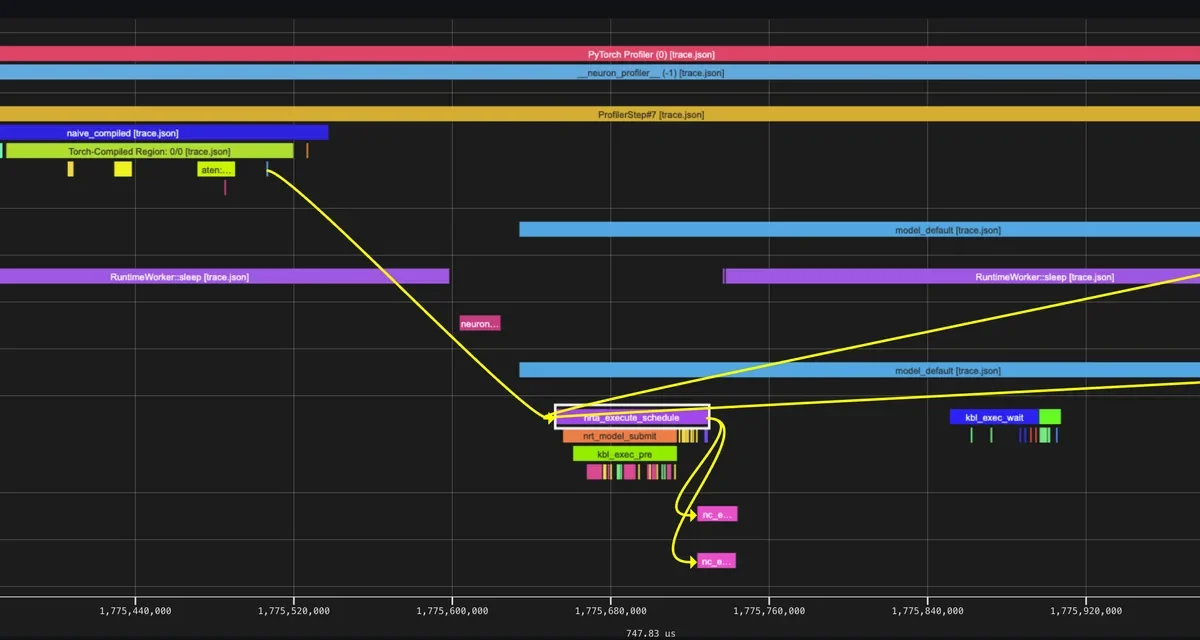
No Neuron Explorer, essas mesmas operações surgem como uma linha do tempo visual. Cada aten::mul nasce na “faixa” do framework, é agendada no runtime como nrta_execute_schedule e chega ao hardware como nc_exec_running. O tempo corre da esquerda para a direita; as fases da vida da operação, de cima para baixo. A ferramenta permite seguir a cadeia de dependência de uma única operação, do despacho até a execução física nas lanes do chip, e ver claramente os buracos entre uma chamada e outra na implementação ingênua.
Fusão de operações corta lacunas e custo
Na segunda etapa do experimento, os autores trocam a implementação manual pela função torch.rms_norm já pronta no PyTorch. No backend Neuron, essa chamada é rebaixada para um kernel fundido único. Na tabela de key_averages(), RMSNorm aparece como uma operação só no dispositivo, em vez de uma sequência de mul, add, mean e rsqrt separados.
O traço no Explorer acompanha essa simplificação: um único despacho do framework ao runtime e uma única execução no hardware, sem os espaços vazios e sem materializar tensores intermediários no meio do caminho. O ganho de tempo vem justamente dessa fusão, que reduz fronteiras de despacho e acessos redundantes à memória.
O terceiro cenário reforça a mesma ideia, agora com o compilador. Em vez de chamar a função fundida pronta, os autores mantêm a RMSNorm ingênua em Python e decoram com @torch.compile(backend="neuron"). TorchDynamo captura o bytecode, converte em grafo FX e, em seguida, o pipeline de compilação reduz esse grafo a operações ATen que o Neuron consegue fundir e otimizar.
O resultado prático é semelhante ao de torch.rms_norm: um único artefato NEFF é gerado, com o grafo inteiro fundido, e a inferência vira um único despacho ao hardware. A tabela de key_averages() registra essa região compilada como um bloco só, com tempo de dispositivo comparável ao da operação fundida nativa. Nos testes relatados, a duração em microsegundos das abordagens com fusão fica em torno de um sexto do tempo da implementação original linha a linha.
Neuron Explorer revela gargalos invisíveis no código
Enquanto a tabela de médias mostra numérico quem gasta mais tempo, o Neuron Explorer dá o contexto visual: mostra se o kernel está fragmentado em muitos despachos pequenos, se há lacunas grandes entre operações no hardware, se o runtime está inserindo esperas ou transferências desnecessárias.
Cada perfil gera uma pasta de saída com o traço de sistema e, quando há coleta de dados de dispositivo, pares de arquivos .neff e .ntff. O primeiro guarda o executável compilado para o Neuron (Neuron Executable File Format); o segundo, o traço de instruções correspondente. Ambos compartilham um hash que os identifica como par. Para uma visão completa de sistema, o desenvolvedor envia a pasta inteira ao Explorer; para análises focadas no dispositivo, basta subir o par de arquivos segmentado.
Com o traço aberto, é possível alternar agrupamentos, seguir a cadeia de dependência de uma operação específica e observar como a fusão de kernels reduz a quantidade de eventos e a distância temporal entre eles. A ferramenta também expõe eventos de CPU, como alocações e cópias host-to-device, que aparecem no key_averages() mas ganham nova leitura quando distribuídos na linha do tempo.
Impacto para quem roda modelos em Trainium
Na prática, o método descrito muda a forma como times técnicos encaram otimização em aceleradores dedicados. Em vez de apenas reduzir batch size ou trocar camada “na tentativa e erro”, passa a ser possível medir com precisão quais operações drenam mais tempo de NeuronCore, onde a CPU vira gargalo, quanto se perde em latência entre despachos e qual é o efeito concreto de uma fusão ou de torch.compile no tempo de inferência.
Equipes de tecnologia, finanças, saúde e pesquisa que operam modelos de deep learning intensivos ganham em dois fronts: conseguem acelerar respostas e, ao mesmo tempo, reduzir custo computacional por requisição, ao usar melhor o hardware especializado. Por outro lado, quem ignora esse tipo de profiling tende a conviver com subutilização de Trainium e latências maiores do que o necessário.
Todo o código usado nos experimentos está disponível no diretório de exemplos do pacote torch-neuronx, o que permite que praticantes reproduzam o estudo, troquem a RMSNorm por camadas reais de seus modelos e adotem o mesmo fluxo em arquiteturas maiores. A expectativa é que as próximas publicações da série avancem para o perfil de nível de dispositivo, com análise do uso de TensorEngine, VectorEngine e DMA e colocação de kernels em diagramas de roofline, abrindo caminho para uma cultura de desenvolvimento mais sistemática em cima do AWS Trainium.
Fonte: matéria original