MiniMax lança M3.1 Flash multimodal com 428 bi e preço baixo
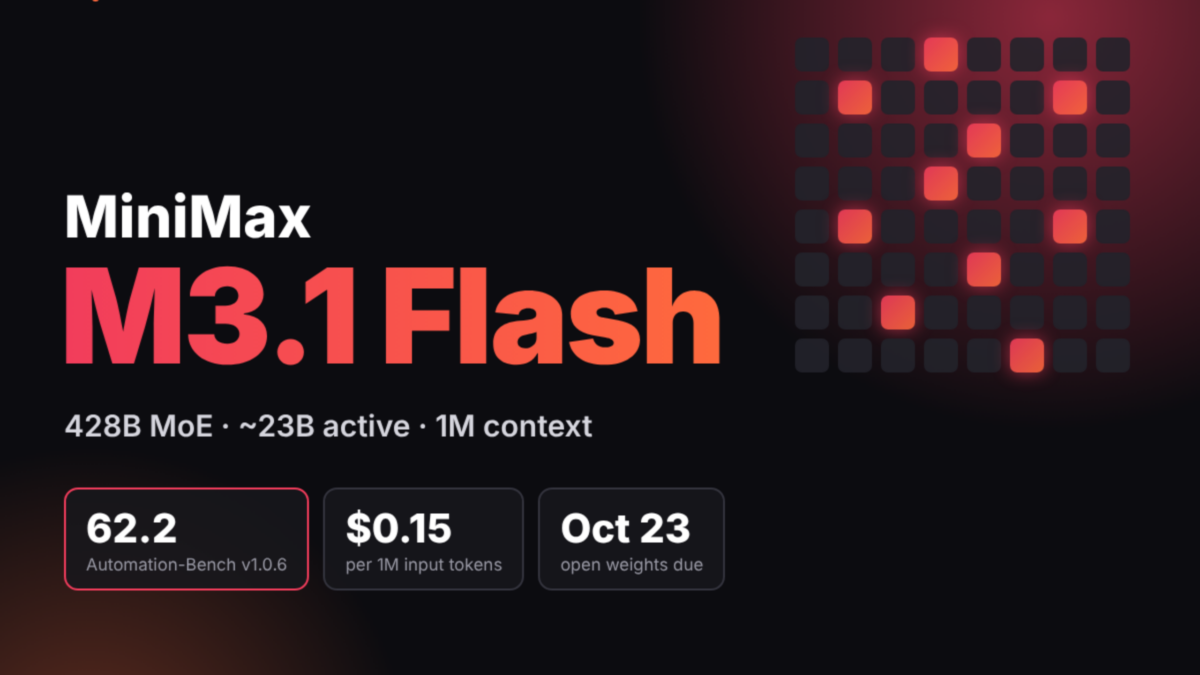
MiniMax lança o M3.1 Flash, modelo multimodal de 428 bilhões de parâmetros, janela de 1 milhão de tokens e preço a partir de US$ 0,15 por 1M tokens, mirando desenvolvedores.
Lançamento Tech
Novo modelo multimodal da MiniMax oferece alta capacidade e custo acessível para desenvolvedores.
Leia também: Nintendo Switch online vai liberar Wii, DS e Sega CD em 2026
A MiniMax lançou hoje o M3.1 Flash, um modelo de inteligência artificial multimodal que combina alta capacidade de raciocínio com preço agressivo para desenvolvedores, e promete desempenho próximo ao de sistemas de ponta em tarefas de automação, código e análise visual.
Modelo gigante, multimodal e voltado a agentes
O MiniMax M3.1 Flash é um modelo do tipo mistura de especialistas, com 428 bilhões de parâmetros no total e cerca de 23 bilhões ativos a cada chamada. Ele aceita texto, imagens e vídeos como entrada e responde em texto, com uma janela de contexto de até 1.000.000 de tokens — volume que permite lidar, de uma vez, com grandes bases de documentos, longos históricos de chat ou projetos complexos de software.
Segundo a MiniMax, o modelo foi pensado para três frentes principais: codificação, trabalho de escritório em modo agente (quando a IA executa sequências de ações de forma autônoma) e raciocínio visual, unindo análise de linguagem e visão computacional. A arquitetura usa atenção esparsa e um codificador visual nativo para lidar com multimodalidade.
O M3.1 Flash sucede o MiniMax M3, mantendo o mesmo número de parâmetros totais e ativos, mas com otimizações que a empresa ainda não detalhou em relatório técnico. A promessa é entregar desempenho mais alto, menor custo por tarefa e maior velocidade.
Raciocínio sempre ligado e cinco níveis de esforço
Uma mudança importante para quem desenvolve é que o raciocínio detalhado do modelo está sempre ativado e não pode ser desligado. Em vez disso, o usuário escolhe entre cinco níveis de esforço: Low, Medium, High, Xhigh e Max. “MiniMax recomenda Max como o padrão para esforço”, afirma a empresa.
Esse raciocínio estruturado é devolvido em um campo separado na resposta, o que exige ajustes em integrações que antes liam blocos de pensamento embutidos no texto principal. Chamadas que tentarem desativar o raciocínio, com parâmetros como thinking.type=disabled ou effort=none, passam a retornar erro.
Nos testes internos divulgados pela MiniMax, o M3.1 Flash aparece como líder no Automation-Bench v1.0.6, com 62,2 pontos, e empata com o modelo Opus 5 em outro conjunto focado em tarefas financeiras. No Agents’ Last Exam, voltado a avaliação de agentes, o modelo registra 29,6 pontos. Todos esses resultados são reportados pela própria empresa e ainda não têm validação independente.
Quanto custa usar o MiniMax M3.1 Flash
O modelo chega com preço plano por volume de tokens, sem cobrança extra por contexto longo. O custo é de US$ 0,15 por 1 milhão de tokens de entrada e US$ 0,60 por 1 milhão de tokens de saída, com leituras de cache a US$ 0,015 por 1 milhão de tokens.
Na prática, a MiniMax tenta mudar a conversa de preço por token para preço por tarefa. Em materiais de divulgação, a empresa afirma que, nos testes de automação usados como referência, “o custo por tarefa fica abaixo de US$0,05 em todos os níveis de esforço”. A comparação direta com o M3 anterior é favorável ao novo modelo: o M3.1 Flash sai, por token, pela metade da tarifa padrão do M3, que ainda encarecia mais para contextos acima de 512 mil tokens.
Com isso, o M3.1 Flash entra em um segmento disputado por modelos que tentam combinar raciocínio avançado com preços de “camada rápida” para uso intensivo em agentes, pipelines de dados e aplicações corporativas.
Velocidade e desempenho em código e visão
Além do custo, a MiniMax destaca ganhos de velocidade. “O modelo é três vezes mais rápido que o M3”, diz a empresa, que anuncia throughput na faixa de 150 tokens por segundo. A promessa é reduzir a latência em fluxos de trabalho pesados, como agentes que chamam a API diversas vezes por tarefa.
Nos benchmarks de programação, os resultados são mistos, mas competitivos. Em um dos conjuntos de testes de desenvolvimento de software, o M3.1 Flash aparece pouco acima de modelos de referência, enquanto em outros fica para trás de concorrentes recentes. Já na visão computacional, o modelo atinge 91,0 pontos em BabyVision com uso de ferramentas e 82,5 em CharXiv RQ, também em números reportados pela própria MiniMax.
A empresa admite que a escolha de benchmarks, o tipo de avaliação e a forma de rodar os testes podem deslocar as pontuações, e reforça que os números servem mais como indicação geral de capacidade do que como medida absoluta.
Como acessar o M3.1 Flash
O M3.1 Flash já está disponível na plataforma online da MiniMax, em platform.minimax.io, sob o nome MiniMax-M3.1-Flash. O acesso pode ser feito via API compatível com os formatos usados por Anthropic e OpenAI, incluindo endpoints de chat e de respostas estruturadas, o que facilita a migração de projetos existentes.
Além da API, o modelo pode ser usado pelo M Plan e pelo aplicativo MiniMax Code para desktop, voltado a fluxos de trabalho de programação. A compatibilidade com APIs populares tende a reduzir o esforço de integração para equipes que já operam com outros grandes modelos de linguagem.
Peso do modelo sai em 23 de outubro
Um ponto que chama a atenção na estratégia da MiniMax é o compromisso de liberar os pesos do M3.1 Flash em 23 de outubro de 2026. A medida abre a porta para que empresas e laboratórios executem o modelo em infraestrutura própria, em vez de depender exclusivamente da nuvem da fornecedora.
Por enquanto, porém, a empresa ainda não divulgou detalhes da licença de uso nem os requisitos de hardware para rodar o modelo em escala. O histórico da linha M3 indica arquivos de centenas de gigabytes, o que em geral exige máquinas especializadas e forte investimento em GPU.
A divulgação dos pesos pode acelerar a adoção entre times de tecnologia que buscam mais controle, customização e privacidade, mas o impacto real depende do quão permissiva será a licença e de como a MiniMax vai equilibrar esse movimento com o próprio negócio de API.
Entenda o contexto
O lançamento do M3.1 Flash acontece em um momento de corrida por modelos multimodais potentes e relativamente baratos, capazes de atuar como “cérebros” de agentes que escrevem código, analisam documentos, interpretam imagens e vídeos e tomam decisões com pouca intervenção humana.
Ao combinar janela de 1 milhão de tokens, raciocínio sempre ligado, velocidade alta e preço baixo, a MiniMax mira principalmente desenvolvedores independentes, startups e pequenas empresas que encontravam barreira de custo em modelos concorrentes. A expectativa é que áreas como tecnologia, automação de processos, análise de imagens e desenvolvimento de software incorporem rapidamente o novo modelo em seus fluxos.
Concorrentes que operam com tarifas mais altas ou modelos menos capazes tendem a sofrer pressão para ajustar preços ou acelerar novos lançamentos. No médio prazo, a tendência é de mercado mais competitivo e diversidade maior de modelos acessíveis, em que empresas como a MiniMax buscam espaço ao oferecer IA avançada com melhor relação entre custo, velocidade e capacidade.
Fonte: matéria original